অনিশ্চয়তার সাথে প্রেডিকশন এবং পলিসি লার্নিং (PPUU)
🎙️ Alfredo Canzianiসূচনা এবং সমস্যার বিন্যাস
ধর, আমরা শিখতে চাই কিভাবে একটি মডেল ছাড়া রিইনফোর্সলার্নিং এর মাধ্যমে গাড়ি চালানো যায়। আমরা আরএল এ মডেলকে ভুল করতে দিই, এবং ভুল গুলো থকে শিক্ষা নেয়ার মাধ্যেমে ট্রেইন করি। কিন্তু এটি সবচেয়ে ভালো পদ্ধতি না, কারণ ভুল আমাদের স্বর্গ/নরক এ নিয়ে যেতে পারে, যেখানে শিখে কোন লাভ নেই।
সুতরাং, মানুষ কিভাবে গাড়ি চালায় এ বিষয়ে এখন কথা বলবো। লেন সুইচিং এর একটি উদাহরণ নিয়ে ভাবো। ধরো গাড়িটি ১০০/ঘন্টা বেগে এগুচ্ছে, যেটিকে রুপান্তর করলে ৩০মি/সে. এর কাছাকাছি হয়, আমরা যদি ৩০ মিটার সামনের দিকে তাকাই, তাহলে আমরা মোটামুটিভাবে ১ সেকেন্ড ভবিষ্যতের দিকে দেখছি।
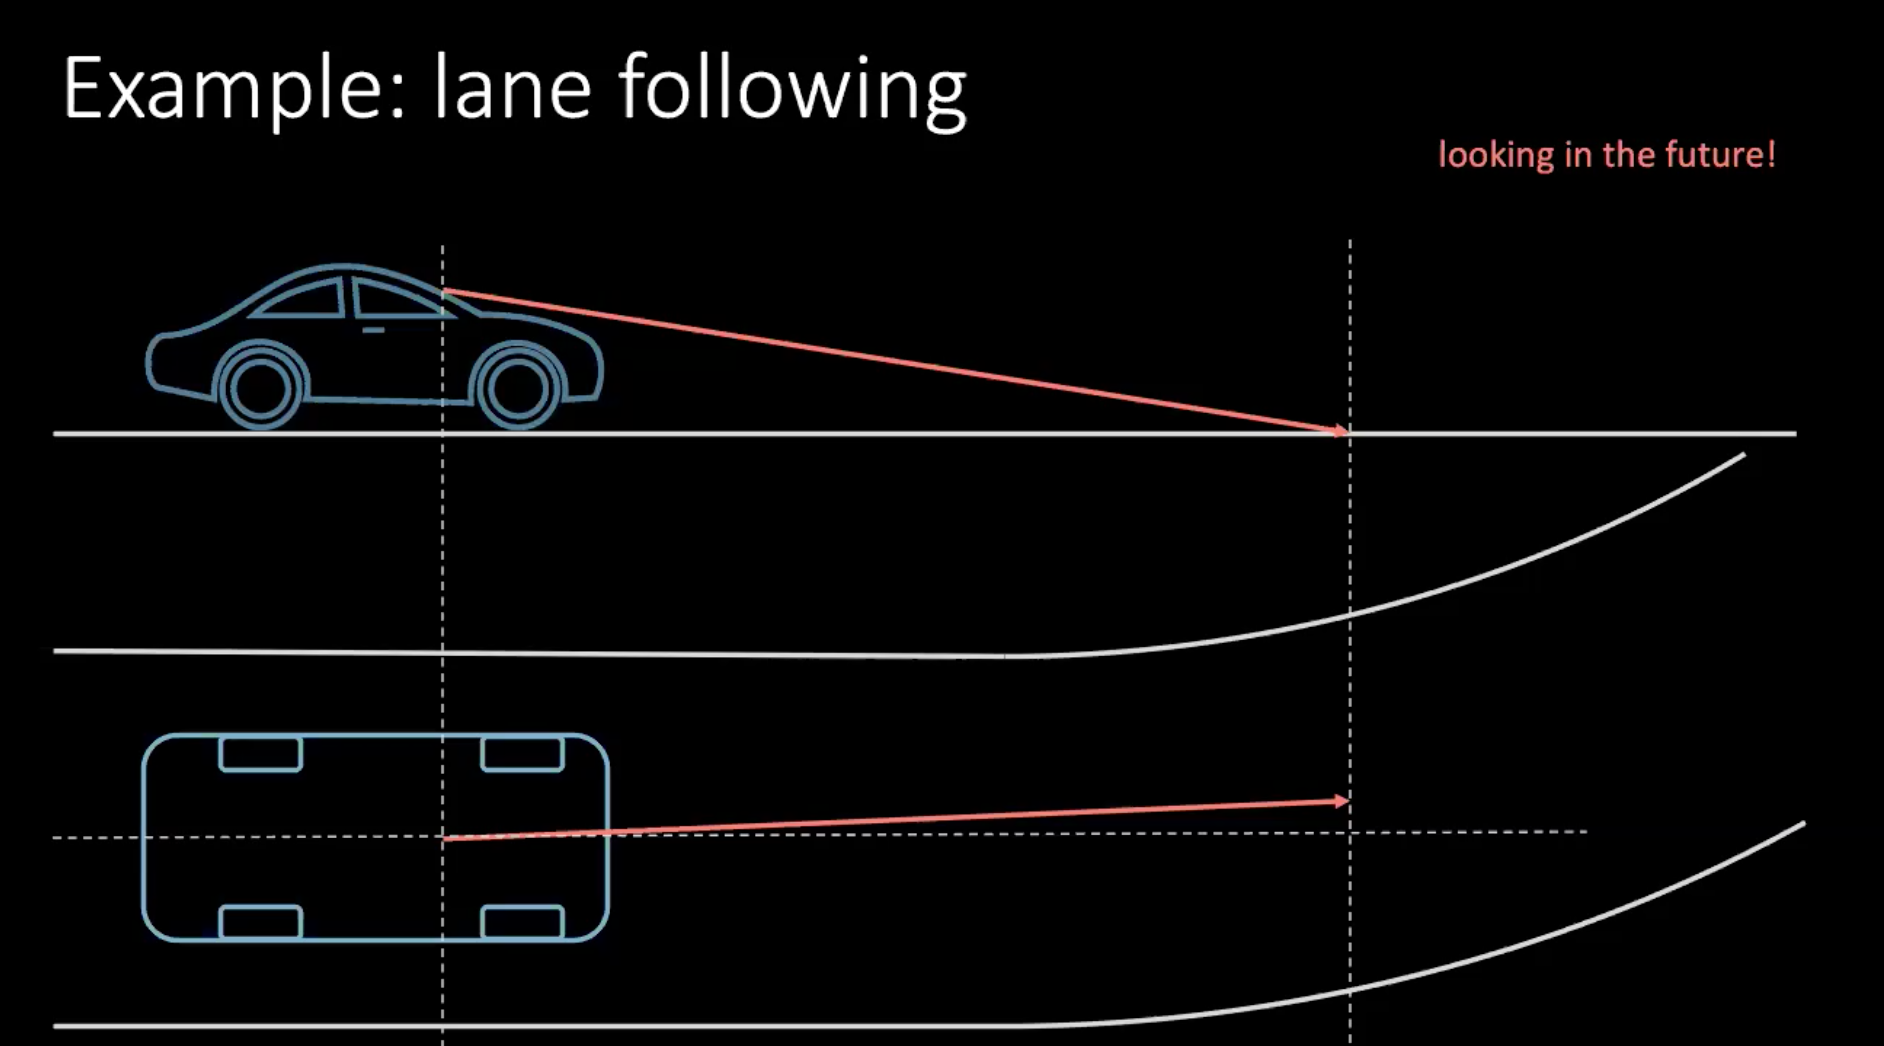
ফিগার ১: গাড়ি চালানোর সময় ভবিষ্যতের দিকে দেখা
আমরা যদি মোড় নিই, তাহলে আমাদের খুব কাছে ভবিষ্যতের উপর নির্ভর করে সিদ্ধান্ত নিতে হবে। কয়েক মিটার পরে মোড় নেয়ার জন্য, আমরা এখন একটি কাজ করবো, যেটি এই প্রসঙ্গে হলো স্টিয়ারিং হুইল ঘুড়ানো। একটি স্বিদ্ধান্ত নেয়া শুধুমাত্র তোমার ড্রাইভিং এর উপরেই নির্ভর করেনা, আশেপাশের ট্রাফিকের উপরেও নির্ভর করে। যেহেতু আমাদের আশেপাশের সবাই এতোটাও ডিটারমিনিস্টিক নয়, সকল সম্ভাবনা হিসেব করা আমাদের জন্য অনেক কঠিন।
এইখানে কি ঘটছে আমরা টা ভেঙ্গে দেখি। আমাদের একটি এজেন্ট(একটি ট্রেন প্রতিনিধিত্ব করছে) আছে যেটি $s_t$(অবস্থান, বেগ, প্রাসঙ্গিক চিত্র) ইনপুট নেয় এবং একটি ক্রিয়া করে (স্টিয়ারিং নিয়ন্ত্রন করা, ত্বরণ এবং ব্রেক করা)। পরিবেশ আমাদের নতুন স্টেট এ নিয়ে যায় এবং একটি কস্ট $c_t$ রিটার্ন করে।
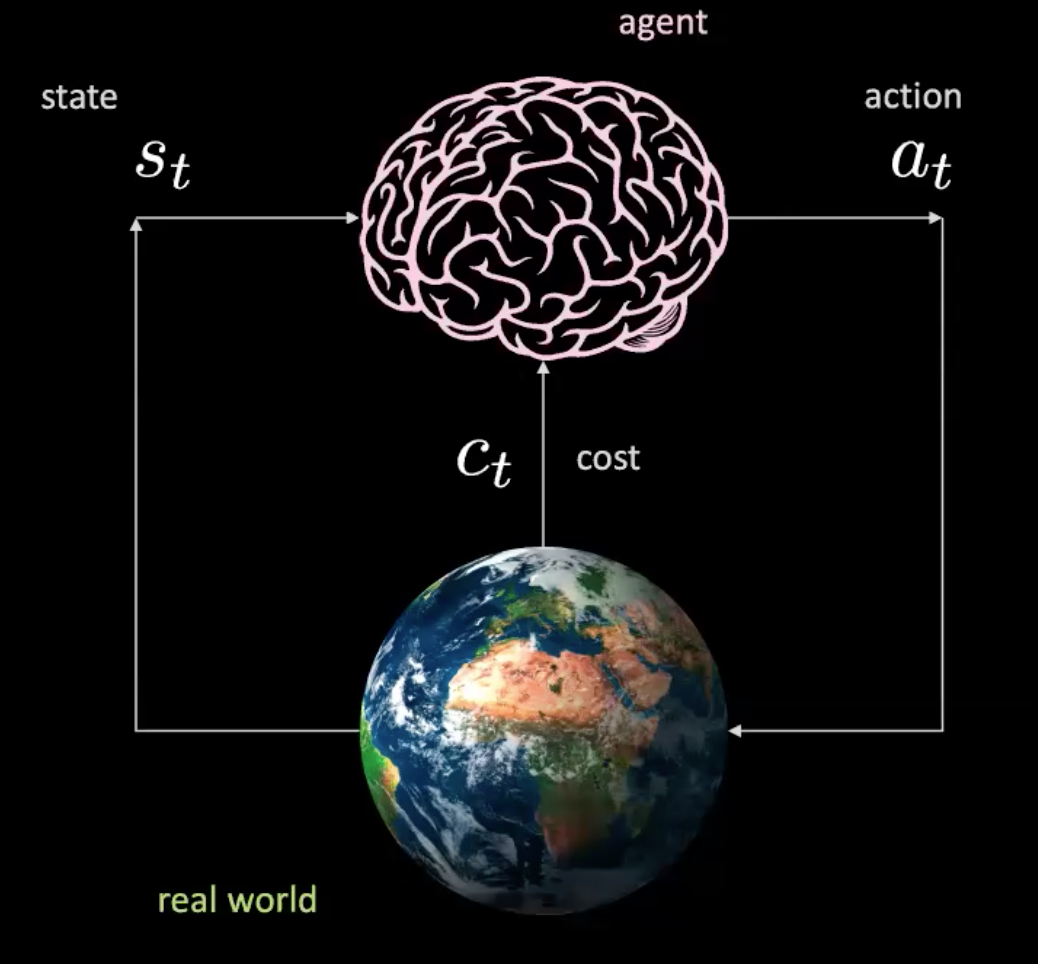
ফিগার ২: বাস্তব বিশ্বের মধ্য একটি এজেন্ট এর বর্নণা।
এটি একটি সাধারণ নেটওয়ার্কের মত, যেখা তুমি একটি নির্দিষ্ট স্টেজে একটি কাজ করো এবং ওয়ার্ল্ড আমাদের পরবর্তী স্টেজ এবং পরবর্তী পরিণতি দেয়। এটি মডেল-ফ্রি কারন প্রত্যেক কাজের সাথে আমরা বাস্তব বিশ্বের সাথে ক্রিয়া-প্রতিক্রিয়া করছি। কিন্তু আমরা কি বাস্তব বিশ্বের সাথে কোন ক্রিয়া-প্রতিক্রিয়া না করে আমাদের এজেন্টকে ট্রেইন করতে পারি ?
হ্যাঁ আমরা পারি! চলো এখন, “লার্নিং ওয়ার্ল্ড মডেল” বিভাগটি দেখি।
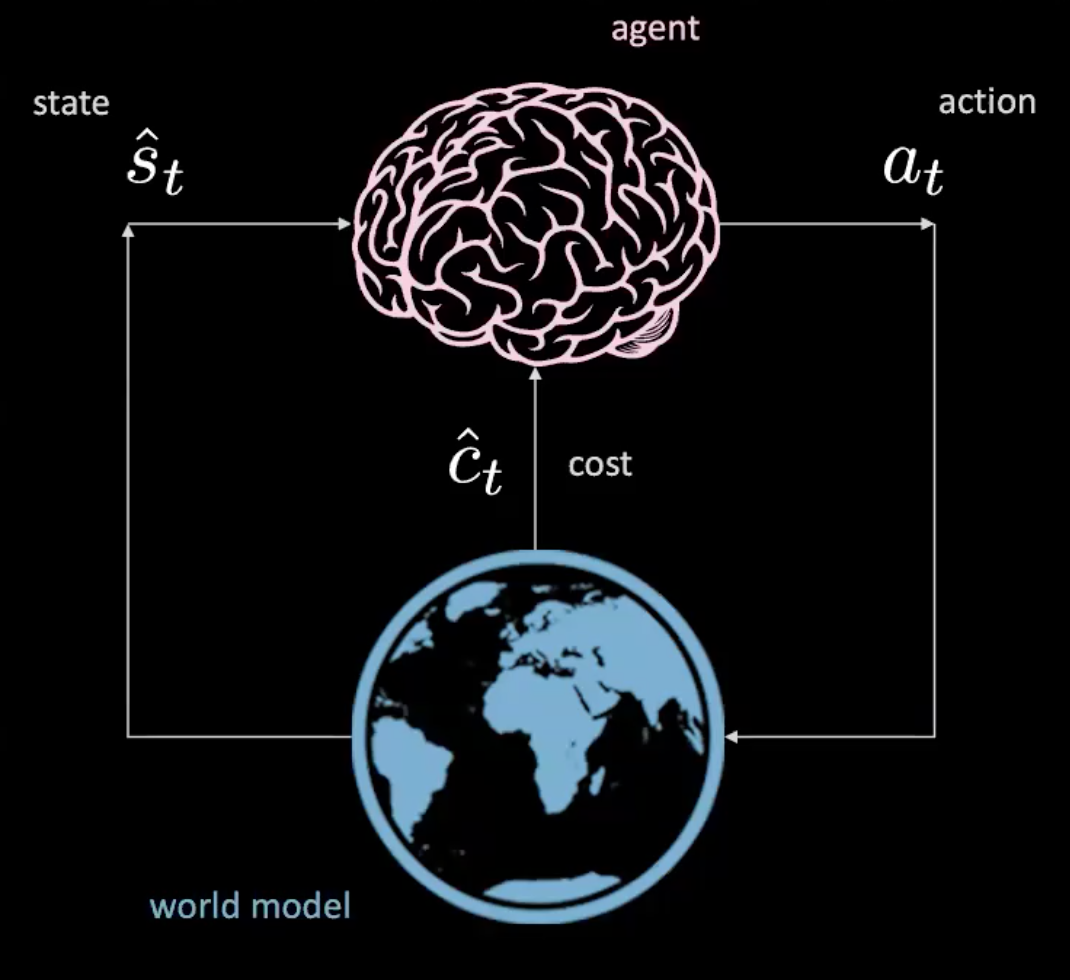
ফিগার ৩: এজেন্ট ইন দ্যা ওয়ার্ল্ড মডেলের বর্নণা
ডাটা সেট
ওয়ার্ল্ড মডেল কিভাবে শিখবো তা আলোচনা করার আগে, আমাদের কাছে যেই ডাটা সেটটি আছে সেটি বিশ্লেষণ করা যাক। একটি ৩০ তলা বিল্ডিং এর উপরে অন্তঃরাজ্যের দিকে মুখ করা ৭ টি ক্যামেরা রয়েছে। আমরা ক্যামেরাগুলোকে এমনভাবে রাখি যাতে সেটি টপ-ডাউন ভিউতে থাকে এভং প্রত্যেক গাড়ির জন্য আমরা বাউন্ডিং বক্স বের করি। একটি সময় $t$ এ আমরা $p_t$ বর্তমান গাড়ির অবস্থা, $v_t$ গাড়ির বেগ এবং $i_t$ গাড়ির আশেপাশের ট্রাফিকের স্টেট বের করতে পারি।
যেহেতু আমরা গাড়িটির গতিপ্রক্রিতি সম্পর্কে জানি, আমরা সেগুলোকে ব্যবহার করে চালক কি সিদ্ধান্ত নিচ্ছে তা বের করতে পারি। যেমন, গাড়িটি যদি একটি সরল পথে সম গতি নিয়ে চলে, তাহলে আমরা জানি গাড়িটির ত্বরণ শূন্য(অর্থাৎ কোন ক্রিয়া নেই)।
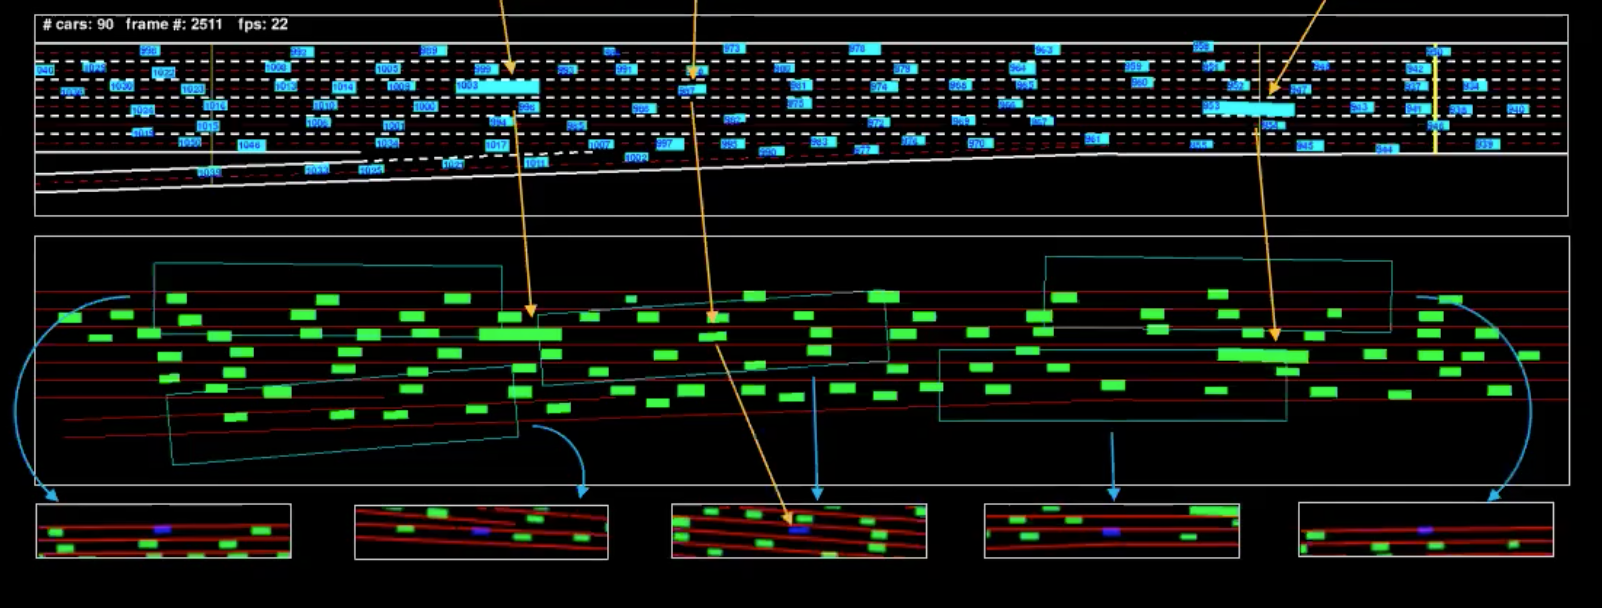
ফিগার ৪: একটি ফ্রেমের মেশিন রিপ্রেসেন্টেশন
ছবিতে নীল রঙে যেটি বর্নণা করা আছে সেটি হচ্ছে ফীড এবং সবুজ রঙেরটি হচ্ছে মেশিন রিপ্রেসেন্টেশন। ভালোভাবে বুঝার লক্ষ্যে, আমরা কিছু গাড়িকে আলাদা করে রেখেছি(ছবিতে চিহ্নিত)। নিচে আমরা যে দৃশ্য দেখতে পাচ্ছি, তা মূলত গাড়িগুলোর বাউন্ডিং বক্সগুলোর ফিল্ড-অফ-ভিয়ু।
কস্ট
এখানে দুই ধরণের কস্ট আছেঃ লেন কস্ট এবং প্রক্সিমিটি কস্ট। লেন কস্ট এর মাধ্য আমরা জানতে পারি একটি লেনে আমরা কিভাবে আছি, এবং প্রক্সিমিটি কস্ট এর মাধ্যমে জানতে পারি আমরা অন্য গাড়িগুলোর কতটা কাছাকাছি আছি।
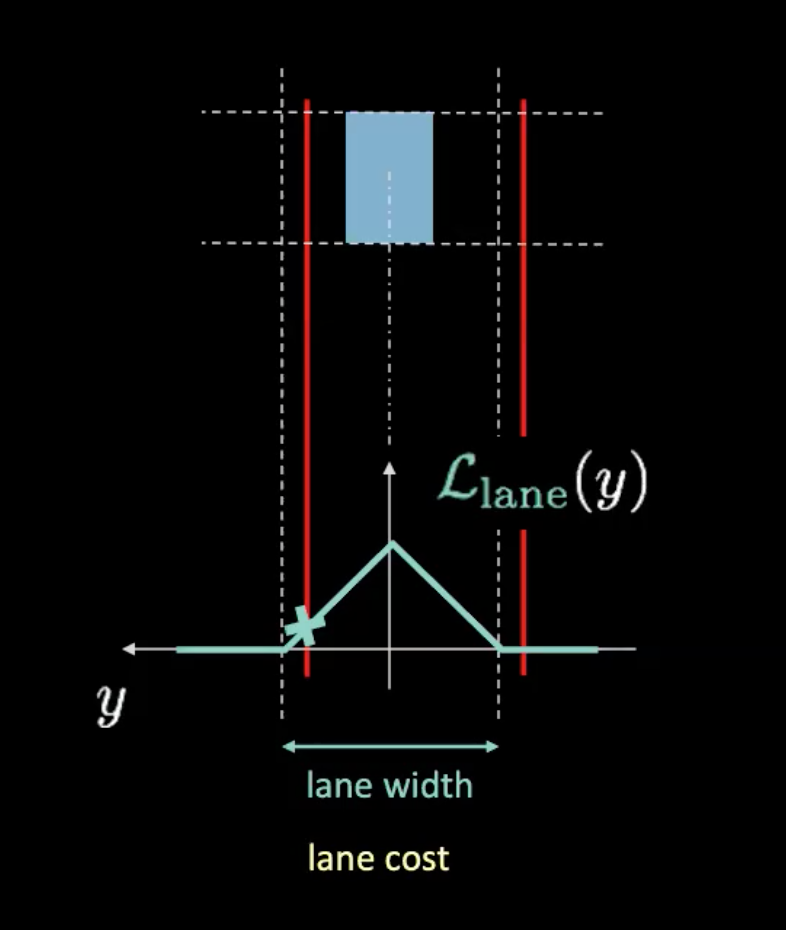
ফিগার ৫: লেন কস্ট
উপরের ছবিতে ডটগুলো দ্বারা আসল লেনকে বুঝানো হয়েছে, এবং লাল রেখাগুলো আমাদের গাড়ির বর্তমান অবস্থানের উপর নির্ভর করে লেন কস্ট বের করতে সাহায্য করে। গাড়ি চলার সাথে সাথে আমাদের লাল রেখাও সরে যায়। সাম্ভব্য বক্ররেখার (সবুজাভ নীল) সাথে লাল রেখার ছেদ বিন্দুতে উচ্চতা থেকে আমরা কস্ট পাই। গাড়িটি যদি লেনের মাঝামাঝিতে থাকে তাহলে উভয় লাল রেখা আসল লেনের সাথে অভারল্যাপ করে যার ফলে কস্ট শুন্য হয়। অন্যদিকে, গাড়িটি কন্দ্র থেকে দূরে সরার সাথে সাথে লাল রেখাগুলোও সরতে থাকে যার ফলে কস্ট অশূন্য হয়।
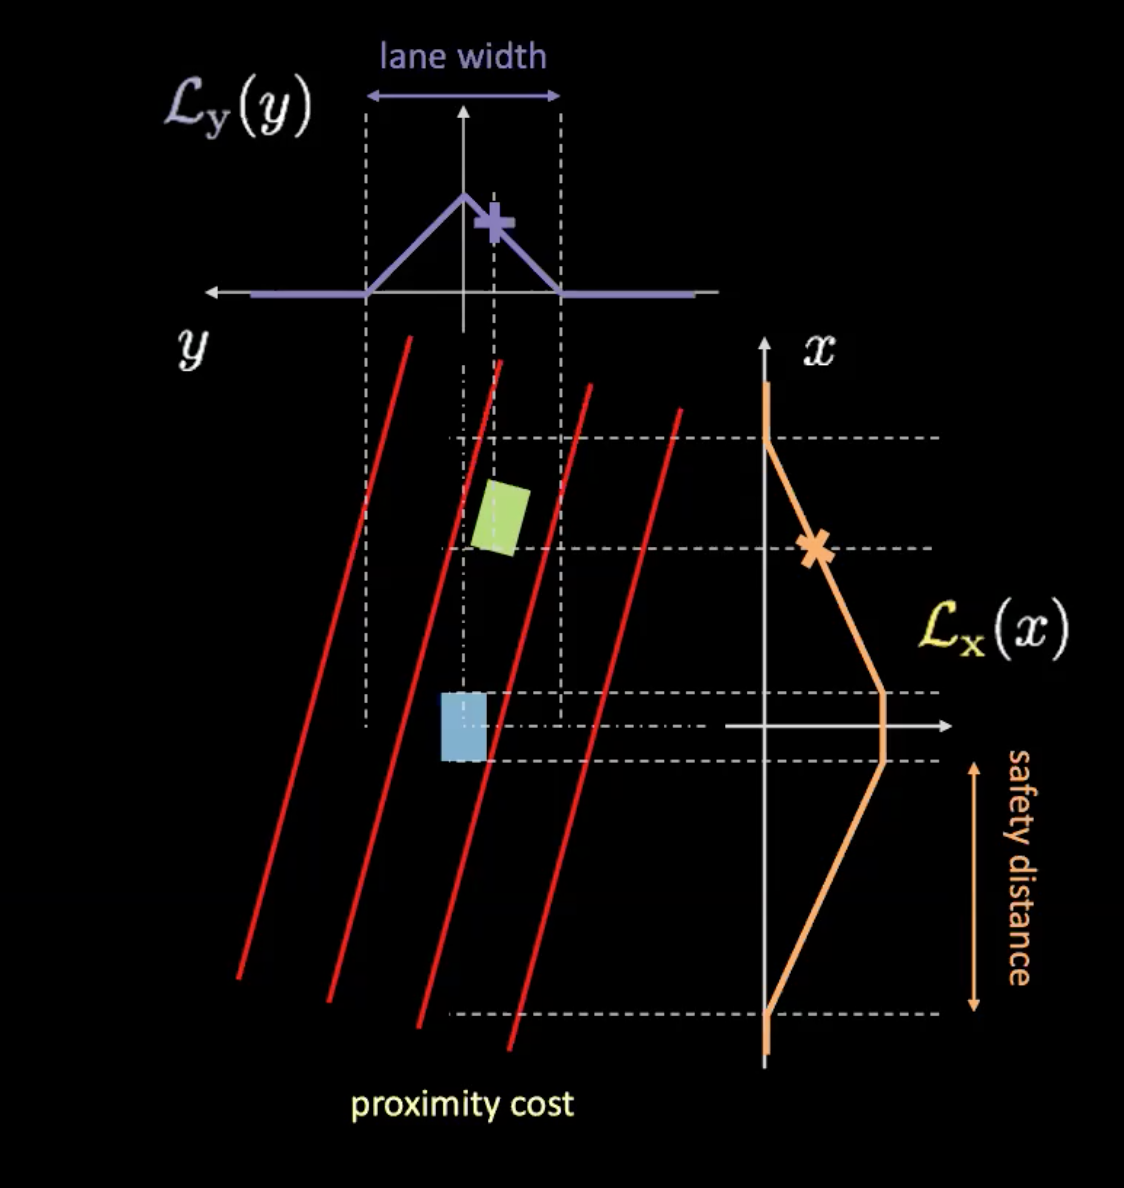
ফিগার ৬: প্রক্সিমিতটি কস্ট
প্রক্সিমিট কস্ট এর দুটো উপাদান আছে ($\mathcal{L}_x$ এবং $\mathcal{L}_y$)। $\mathcal{L}_y$ এর লেন কস্ট এর সাথে মিল রয়েছে এবং $\mathcal{L}_x$ নির্ভর করে গাড়ির গতি কেমন তার উপর। ফিগার ৬ এ কমলা রঙের বক্ররেখা আমাদের নিরাপদ দূরত্ব সম্পর্কে ধারণা দেয়। গাড়ির গতি যত বাড়তে থাকে কমলা বক্ররেখাটিও তত প্রশস্ত হতে থাকে। তাই, আমরা যত তাড়াতাড়ি চলবো, আমাদের ততই সামনে এবং আশেপাশে তাকাতে হবে। কমলা বক্ররেখার সাথে গাড়ির ছেদ এর উচ্চতা $\mathcal{L}_x$ নির্ধারণ করে।
এই দুটি উপাদানের গুণফল আমাদের প্রক্সিমিটি কস্ট দেয়।
লার্নিং ওয়ার্ল্ড মডেল
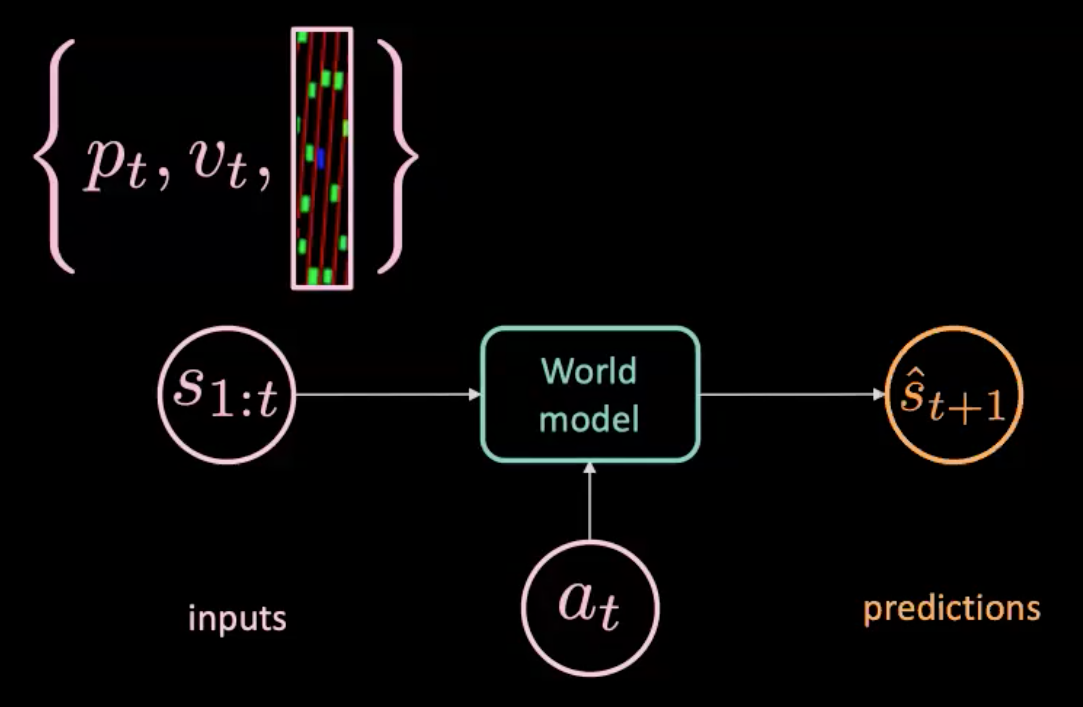
ফিগাড় ৭: ওয়ার্ল্ড মডেলের উদাহরণ
অয়ার্ল্ড মডেলকে একটি ক্রিয়া $a_t$ ফীড করা হয়,
ডিটারমিনিস্টিক প্রেডিক্টর-ডিকোডার
আমাদের ওয়ার্ল্ড মডেল নিচে বর্ণিত উপায়ে প্রেডিক্টর-ডিকোডার মডেল ব্যবহার করে ট্রেইন করা যেতে পারে।
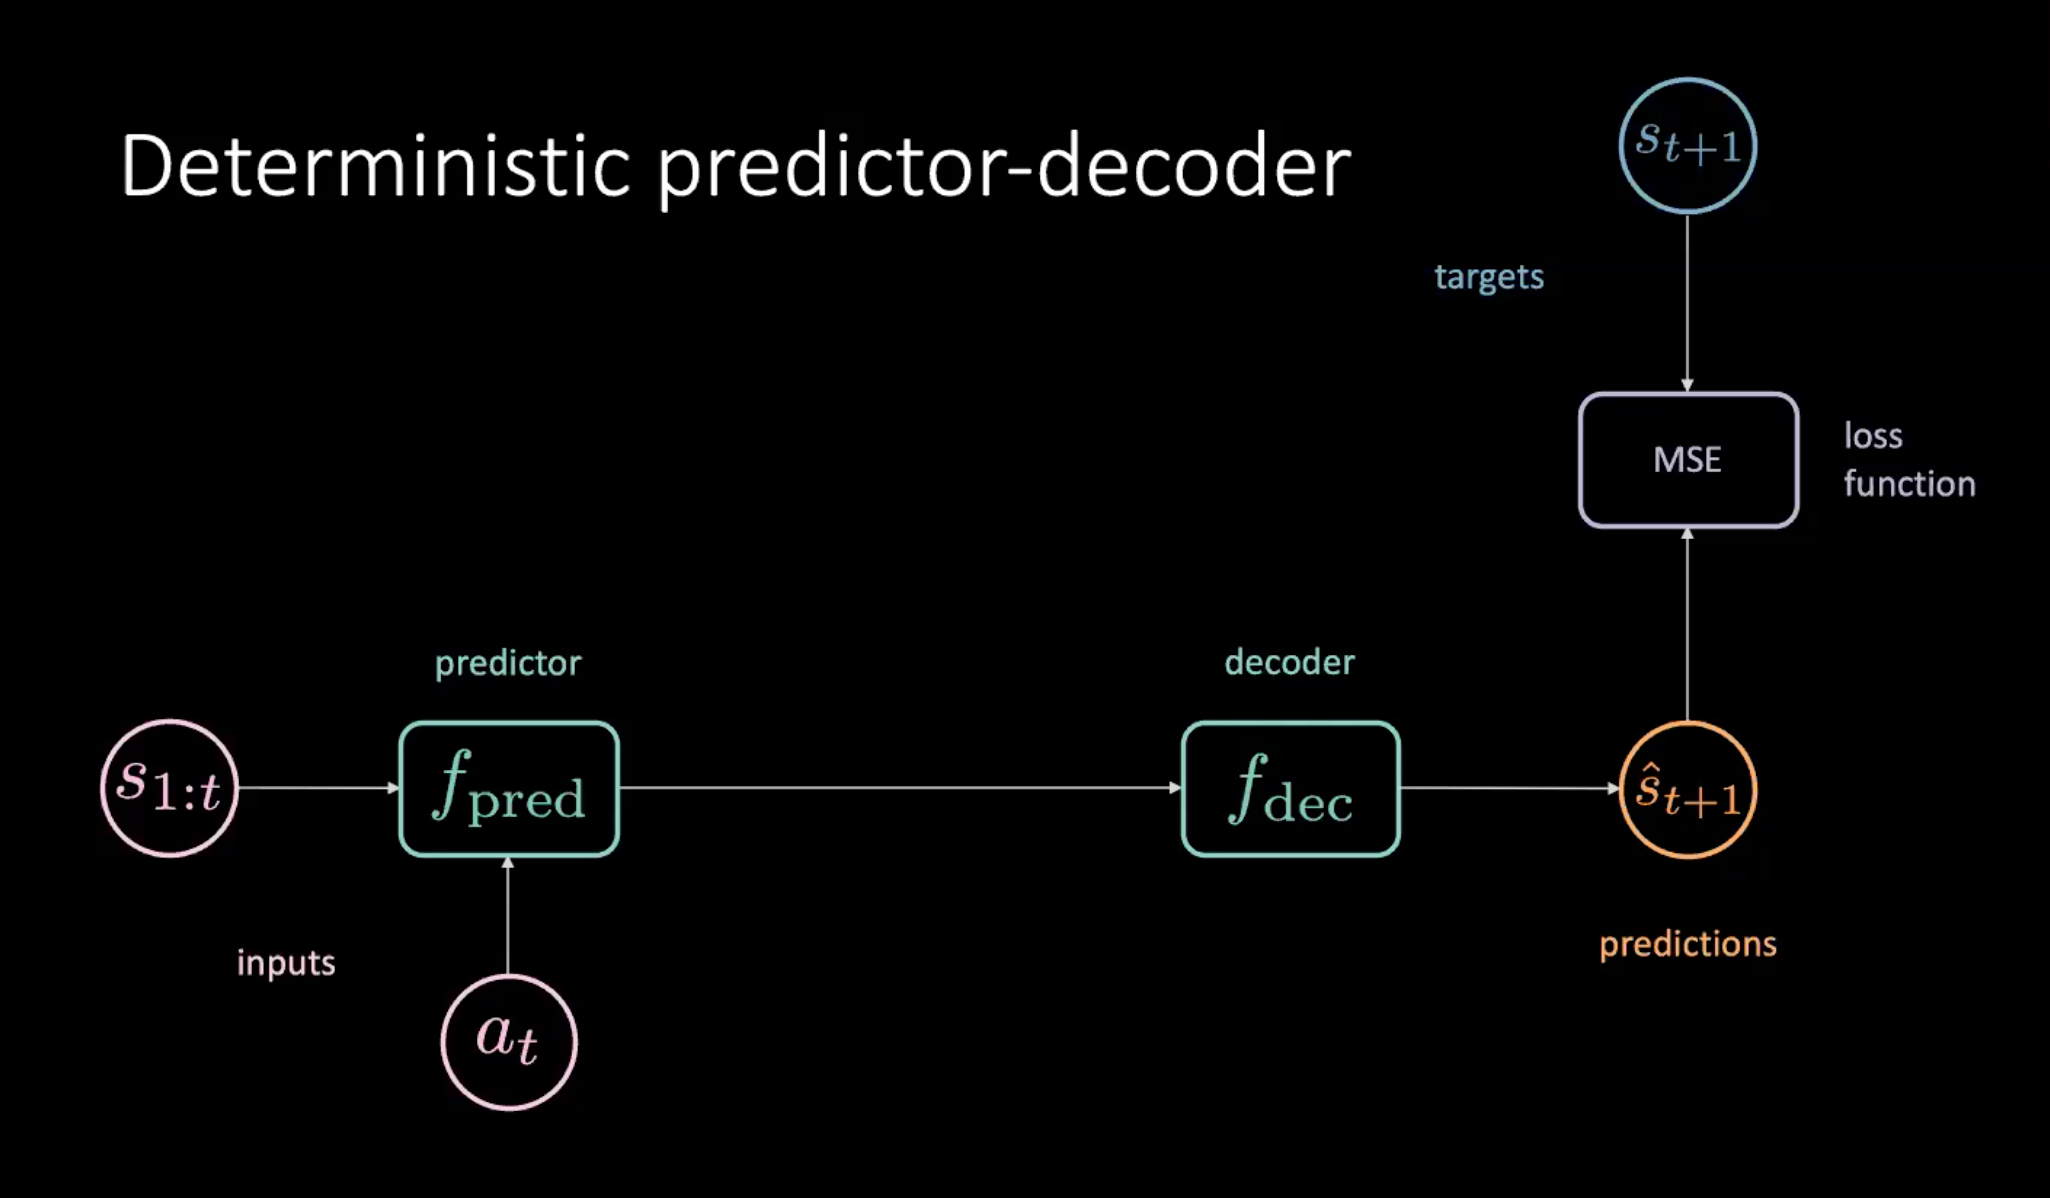
ফিগার ৮: অয়ার্ল্ড মডেল লার্ন করার জন্য প্রেডিক্টর ডিকোডার মডেল।
ফিগার ৮ এ বর্ণিত, আমাদের কিছু স্টেট($s_{1:t}$) এবং এ্যাকশন($a_t$) এর ক্রম রয়েছে, যেগুলো প্রেডিক্টর মডিউলকে সরবরাহ করা হয়। প্রেডিক্টরটি ফিউচার এর একটি হিডেন রিপ্রেসেন্টেশন আউটপুট দেয়, যেটি ডিকোডারে সরবরাহ করা হয়। ডিকোডারটি ফিউচারের হিডেন রিপ্রেসেন্টেশনকে ডিকোড করে, এবং একটি প্রেডিকশন আউটপুট দেয়($\hat s_{t+1}$)। আমরা প্রেডিকশন $\hat s_{t+1}$ এবং টার্গেটের $s_{t+1}$ মধ্যকার MSE কে মিনিমাইজ হ্রাস করার মাধ্যমে আমাদের মডেলকে ট্রেইন করি।
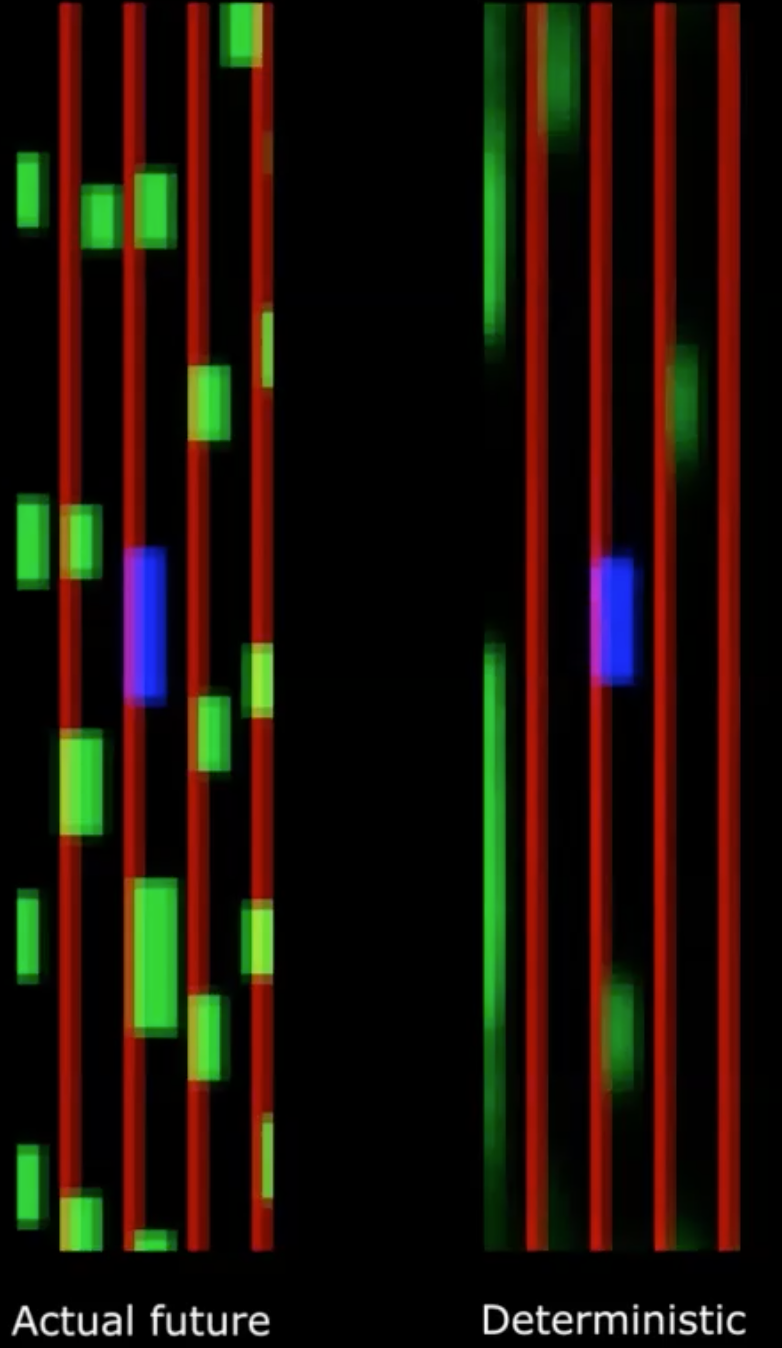
ফিগার ৯: আসল ফিউচার *বনাম* ডিটারমিনিস্টিক ফিউচার
দূর্ভাগ্যজনক, এটি আসলে কাজ করেনা।
আমরা দেখতে পাই যে, ডিটারমিনিস্টিক আউটপুট অনেক অস্পষ্ট। এর কারণ হলো আমাদের মডেল সব সাম্ভব্য ফিউচারকে গড় করছে। এটি কিছু ক্লাস আগে আলোচনা করা, ফিউচারের বহুমাত্রিকতার সাথে তুলনা করা যেতে পারে, যেখানে একটি কলম কেন্দ্র থেকে র্যান্ডমলি ফেলে দেয়া হয়েছিলো। আমরা যদি কলমের সকল স্থানের গড় নিই, তাহলে এটি আমাদের ধারণা দেয় যে কলমটি আসলে অবস্থানের কোন পরিবর্তনই করেনি, যেটি আসলে সত্য নয়।
মডেলে লেটেন্ট ভেরিয়েবল ব্যবহারের মাধ্যমে আমরা এই সমস্যার সমাধান করতে পারিন
ভেরিয়েশনাল প্রেডিক্টিভ নেটওয়ার্ক](https://www.youtube.com/watch?v=VcrCr-KNBHc&t=1779s)
পূর্বের অধ্যায়ে আলোচিত সমস্যা সমাধানের জন্য, আমরা মূল নেটয়ার্কে একটি নিম্ন মাত্রিক লেটেন্ট ভেরিয়েবল $z_t$ ব্যবহার করবো মাত্রার মিল করার জন্য, একটি এক্সাপানসন মডিউলের $f_{exp}$ মধ্য দিয়ে যায়।
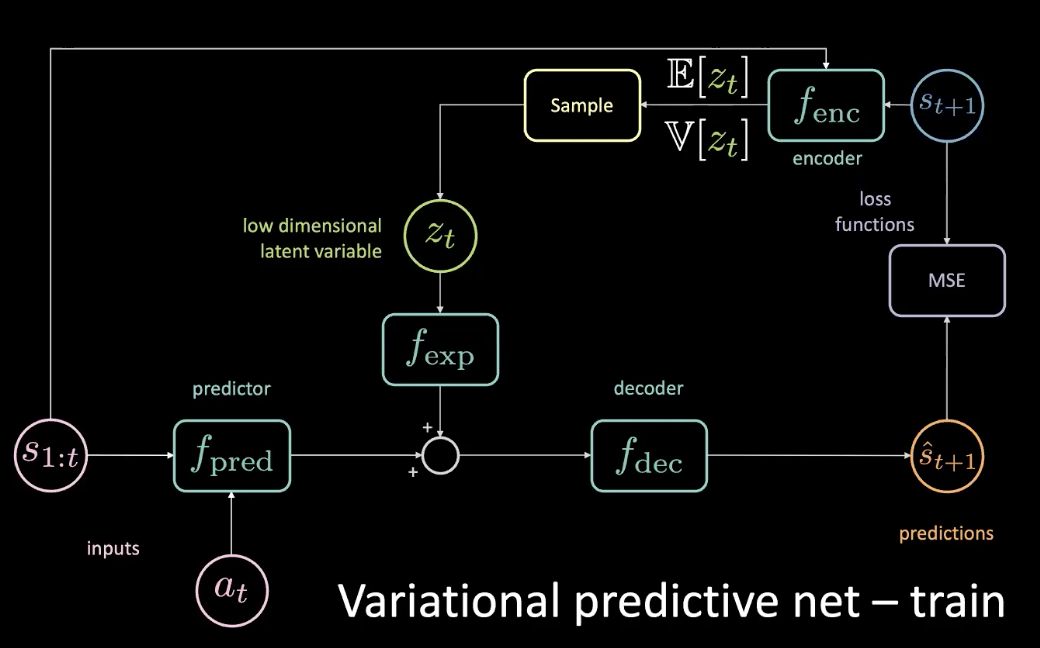
ফিগার ১০: ভেরিয়েশনাল প্রেডিক্টিভ নেটওয়ার্ক - ট্রেইন
$z_t$ এমনভাবে বাছাই করা হয় যাতে একটি নির্দিষ্ট প্রেডিকশনের জন্য MSE হ্রাস পায়। লেটেন্ট ভেরিয়েবলকে টিউন করার মাধ্যমে, লেটেন্ট স্পেসে গ্রেডিয়েন্ট ডিসেন্ট করার মাধ্যমে তুমি MSE কে শুন্যের কাছাকাছি নিতে পারো। কিন্তু এটি খুবই ব্যবহুল। তাই আমরা এনকোডার ব্যবহারের মাধ্যমে লেটেন্ট ভেরিয়েবলকে প্রেডিক্ট করতে পারি। এনকোডাড় ফিউচার স্টেট ইনপুট হিসেবে নিয়ে আমাদের, গড় এবং ভেদাঙ্কের মধ্যে একটি বিন্যাস দেয়, যেখান থেকে আমরা $z_t$ কে স্যাম্পল করতে পারি।
ফিউচার দেখে এবং এর থেকে তথ্য নিয়ে এবং এই তথ্য ব্যবহার করে লেটেন্ট ভেরিয়েবলকে প্রেডিক্ট করে আমরা ট্রেনিংয়ে কি ঘটছে তা জানতে পারি। যদিও, টেস্ট এর সময় আমাদের কাছে ফিউচার এর কোন তথ্য থাকবে না। KL ডাইভারজেন্স অপ্টিমাইজেশন করে এনকোডারকে পূর্বের বিন্যাসের কাছাকাছি উত্তরোত্তর বিন্যাস দিতে বাধ্য করার মাধ্যমে আমরা এটিকে ঠিক করতে পারি।
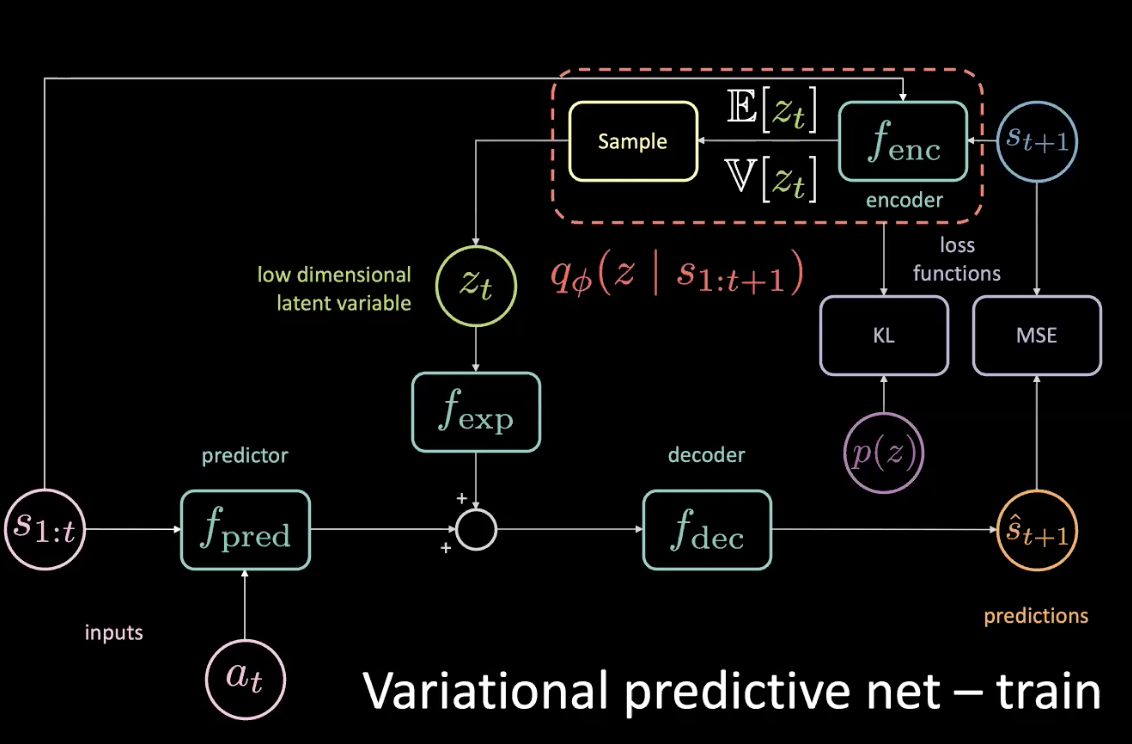
ফিগার ১১: ভেরিয়েশনাল প্রেডিক্টিভ নেটওয়ার্ক - ট্রেইন (পূর্বের বিন্যাস)
এখন আমরা ইনফেরেন্স দেখবো- কিভাবে আমরা গাড়ি চালাই?
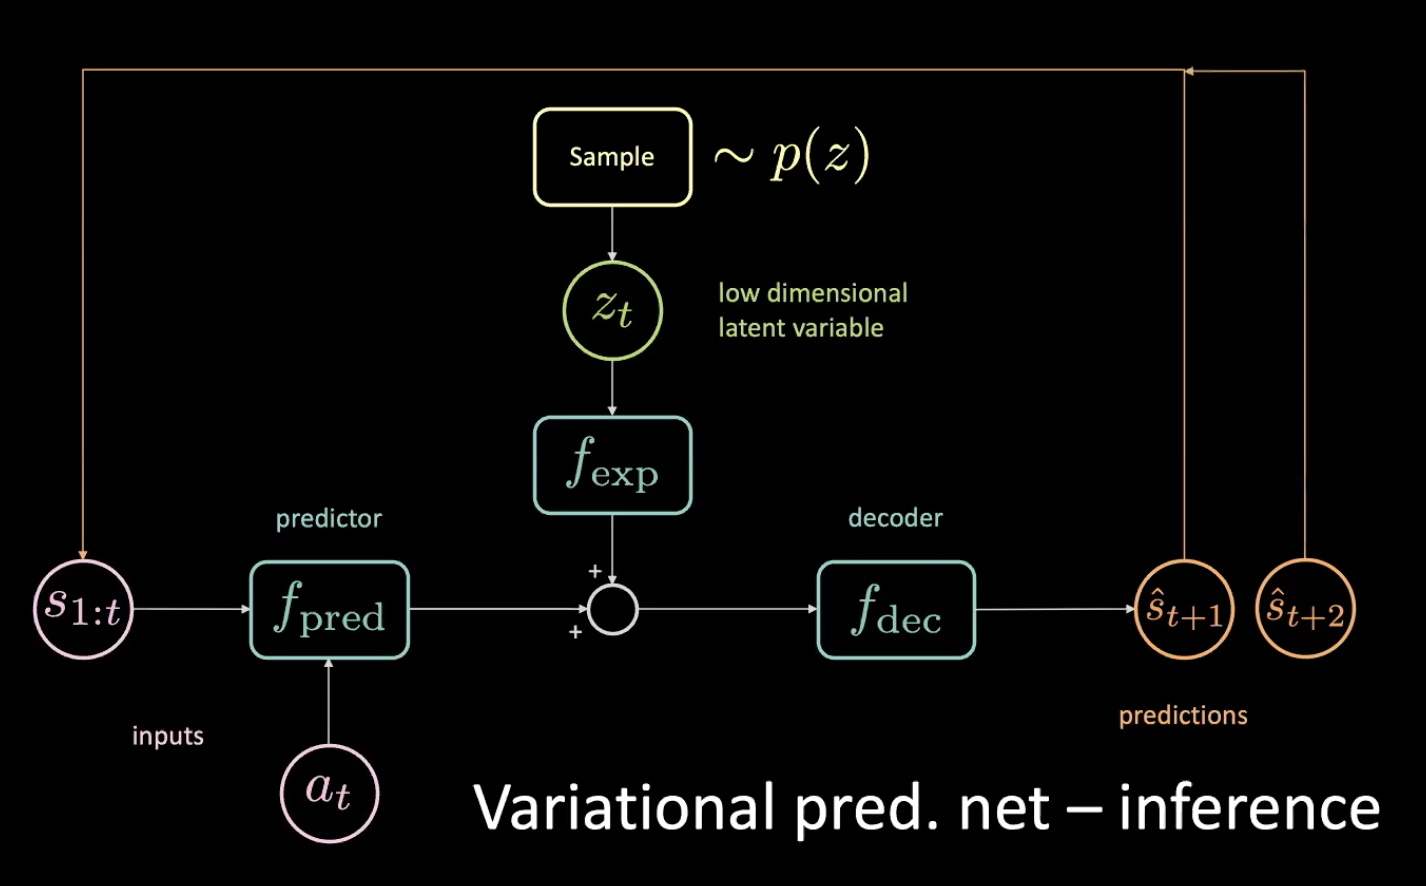
ফিগার ১২: ভেরিয়েশনাল প্রেডিক্টিভ নেটওয়ার্ক - অনুমান
এনকোডারকে এই বিন্যাসের দিকে বাধ্য করার মাধ্যমে আমরা পূর্বের বিন্যাস থেকে নিম্ন মাত্রিক লেটেন্ট ভেরিয়েবল $z_t$ কে স্যাম্পল করতে পারি। প্রেডিকশন $\hat s_{t+1}$ পাওয়ার পর, আমরা এটিকে আবার রেখে দিই (অটো-রিগ্রেসিভ স্টেপ) এবং পরবর্তী প্রেডিকশন $\hat s_{t+2}$ পাই এবং এভাবে আমরা নেটওয়ার্কটিকে ফিড করতে থাকি।
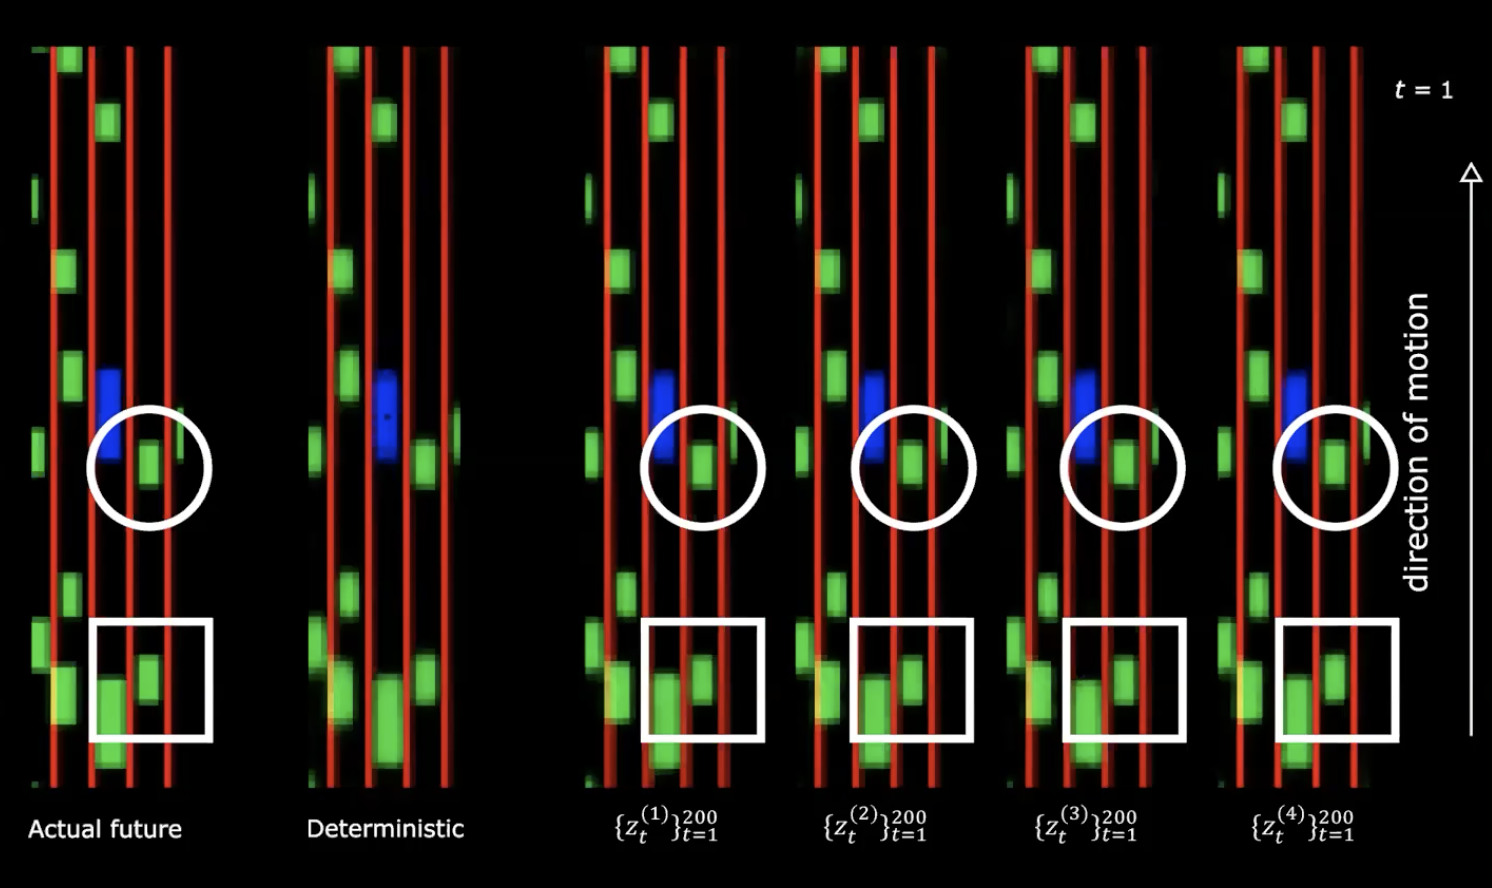
ফিগার ১৩: আসল ফিউচার *বনাম* ডিটারমিনিস্টিক
উপরের ফিগারের ডান দিকে আমরা নরমাল বিন্যাসের চারটি ভিন্ন ছবি দেখতে পাই। আমরা একই ইনিশিয়াল স্টেট দিয়ে শুরু করি এবং ভিন্ন ভিন্ন ২০০টি লেটেন্ট ভেরিয়েবল সরবরাহ করি।
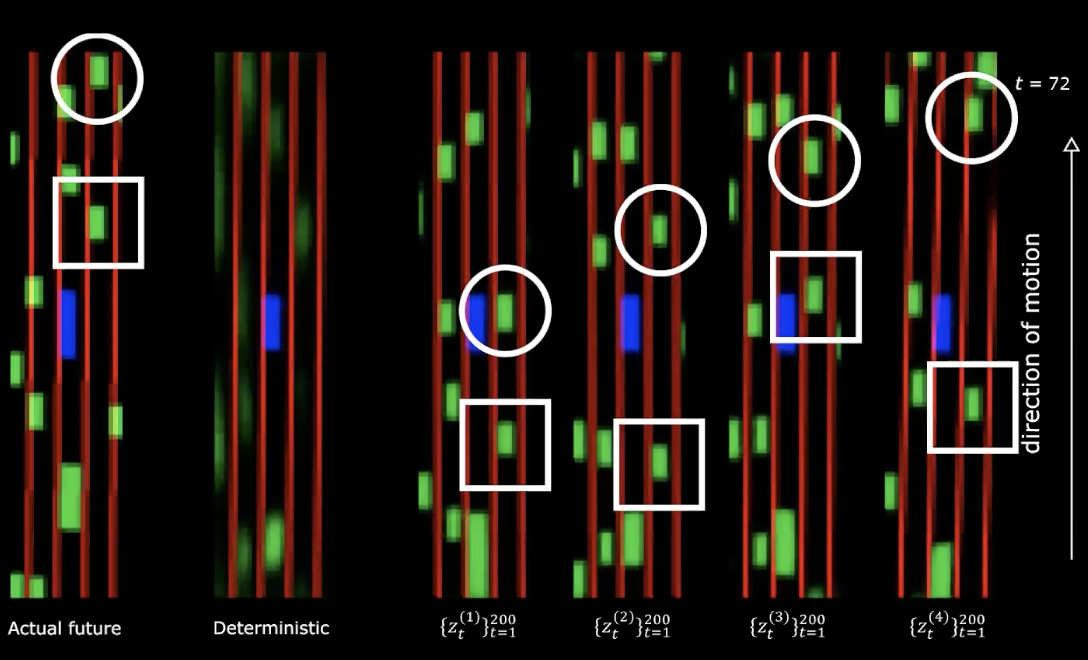
ফিগার ১৪: আসল ফিউচার *বনাম* ডিটারমিনিস্টিক - অবস্থান পরিবর্তনের পরে
আমরা লক্ষ্য করি যে, ভিন্ন লেটেন্ট ভেরিয়েবল প্রদান করলে, ভিন্ন ক্রমের এবং ভিন্ন বৈশিষ্ট্যের তৈরী হয়। তার মানে হলো আমাদের একটি নেটওয়ার্ক আছে যেটি ফিউচারটি জেনারেট করে। বেশ আকর্ষণীয়!
পরবর্তীতে কি?
আমরা এই বিশাল পরিমাণ ডাটা, লেন এবং নিচে বর্ণিত প্রক্সিমিটি কস্টকে অপ্টিমাইজেশনের মাধ্যমে আমাদের পলিসিকে ট্রেইন করতে ব্যবহার করতে পারি।
তুমি নেটওয়ার্কে লেটেন্ট ভেরিয়েবলের যে ক্রমকে ফিড কর, এই ফিউচারগুলো সেখান থেকে আসে। তুমি যদি লেটেন্ট স্পেসে গ্রেডিয়েন্ট এসেন্ট করো, তুমি আসলে প্রক্সিমিটি কস্টকে বাড়ানোর চেষ্টা করছো, তাই তুমি লেটেন্ট ভেরিয়েবলের একটি ক্রম পাবে যাতে অন্য সকল গাড়ি তোমার দিকে চালনা করবে।
এ্য্যাকশন এর নিবিড়তা এবং লেটেন্ট ড্রপআউট
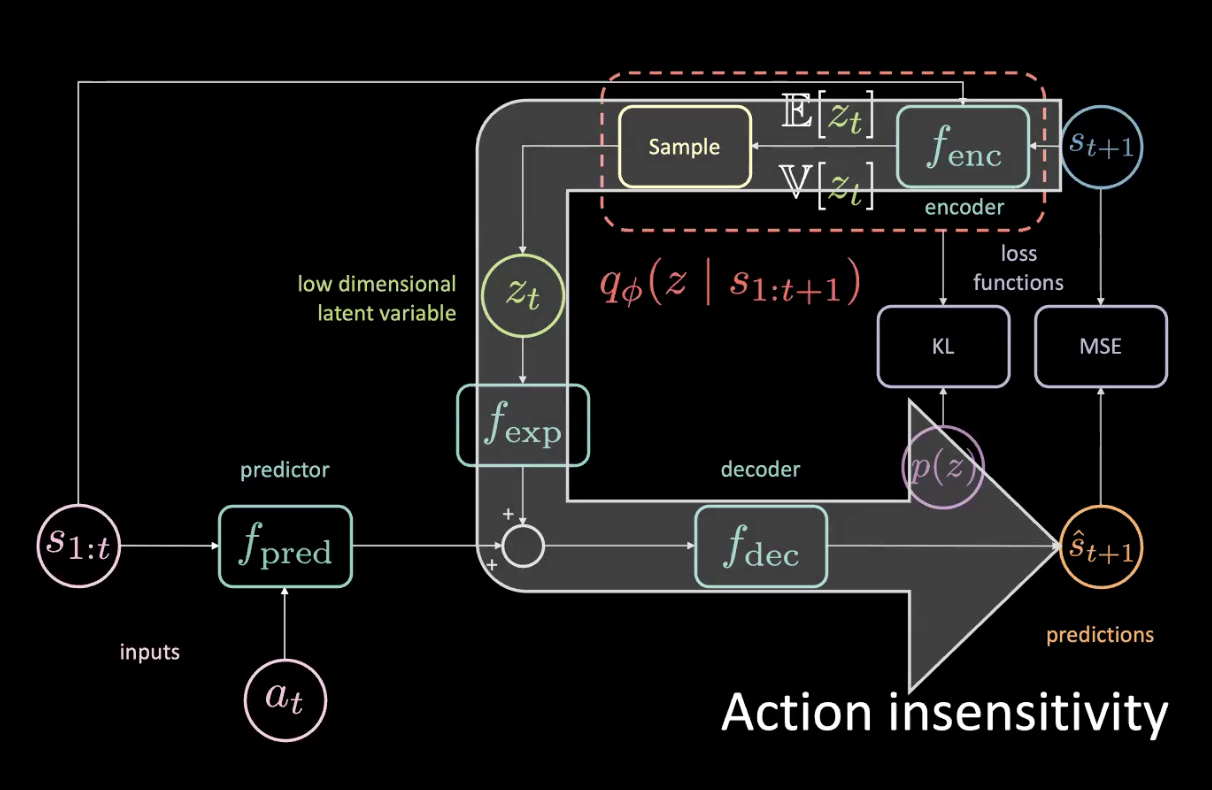
ফিগার ১৫: সমস্যা - এ্য্যাকশনের নিবিড়তা
দেওয়া আছে, তোমার কাছে ফিউচার এর এক্সেস আছে, তুমি যদি বামে সামান্য তমও মোড় নাও, সবকিছু ডানে মোড় নিবে এবং MSE তে এর অনেক বড় প্রভাব রয়েছে। MSE লসকে হ্রাস করা যায়, যদি নেটওয়ার্কের নিচের অংশকে লেটেন্ট ভেরিয়েবল অবহিত করতে পারে যে সবকিছু ডানে মোড় নিবে - কিন্তু আমরা সেটি চাই না! সবকিছু ডানে মোড় নিলে তখন আমরা বলতে পারি কারন এটি একটি ডিটারমনিস্টিক কাজ।
ফিগার ১৫ এর বড়ো তীর চিহ্নটি তথ্য ফাঁস হয়ে যাওয়ার দিকে ইঙ্গিত করে এবং এজন্য এটি প্রেডিক্টরে দেওয়া বর্তমান কো এ্য্যাকশনের প্রতি সংবেদনশীল নয়।
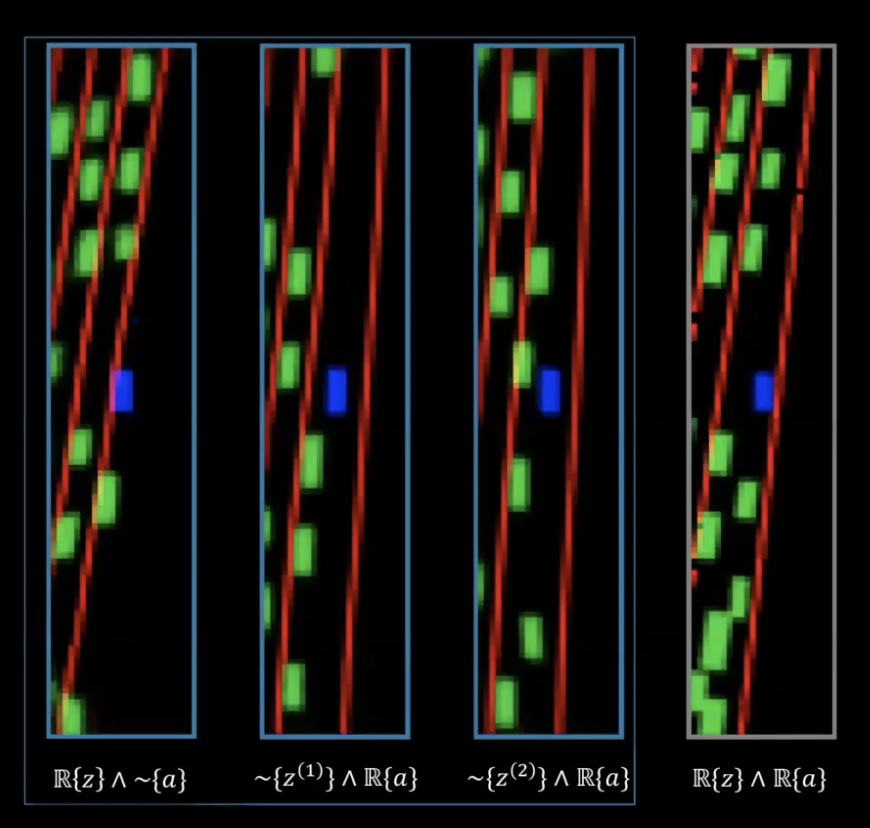
ফিগার ১৬: সমস্যা - এ্য্যাকশন অসংবেদনশীলতা
ফিগার ১৬ তে, সবচেয়ে ডানের ছবিতে আমাদের লেটেন্ট ভেরিয়েবলের আসল ক্রম আছে (লেটেন্ট ভেরিয়েবল যা আমাদের সবচেয়ে সুনির্দিষ্ট ফিউচার পেতে সাহায্য করে) এবং অভিজ্ঞদের দ্বারা গৃহিতি আসল এ্য্যাকশনের ক্রমও আছে। এই ছবির বামে দুটি ছবিতে র্যান্ডমলি স্যাম্পল করা লেটেন্ট ভেরিয়েবল আছে কিন্তু আসল এ্যাকশন আছে যাতে আমরা স্টিয়ারিং ঘুরতে দেখি। সবচেয়ে বামের ছবিতে আসলে লেটেন্ট ভেরিয়েবল কিন্তু র্যান্ডম এ্যাকশন আছে, তাই আমরা দেখতে পাই, মোড় নেয়া আসলে লেটেন্ট এর কারনে হয়েছে, যেটি রোটেশন এবং এ্যাকশনকে এনকোড করে(যেগুলো অন্য এপিসোড থেকে স্যাম্পল করা)।
কিভাবে এই সমস্যাটির সমাধান করা যায় ?
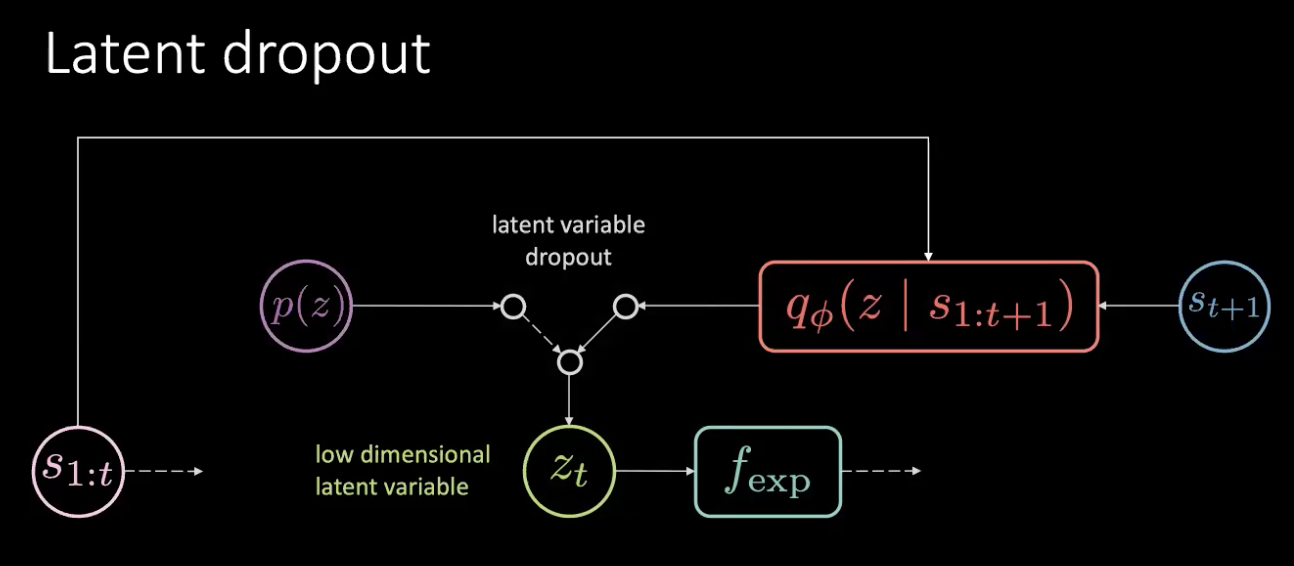
ফিগার ১৭: ঠিক করা- লেটেন্ট ড্রপআউট
এই সমস্যাটি মেমরি ফাঁস নয়, তথ্য ফাঁসের সমস্যা। আমরা এই সমস্যাটি, এই লেটেন্ট ড্রপ করার মাধ্যমে এবং একটি পূর্বের বিন্যাস থেকে দৈবভাবে স্যাম্পলের মাধ্য সমাধান করতে পারি। আমরা সবসময় এনকোডারের ($f_{enc}$) আউটপুটের উপর নির্ভর করে থাকি না, পূর্বেকার বিন্যাস থেকেও নিই। এই পদ্ধতিতে আমরা লেটেন্ট ভেরিয়েবলে রোটেশনকে আর এনকোড করতে পারি না।। এই পদ্ধতিতে, তথ্য লেটেন্ট ভেরিয়েবলের পরিবর্তে এ্যাকশনে এনকোড হয়।
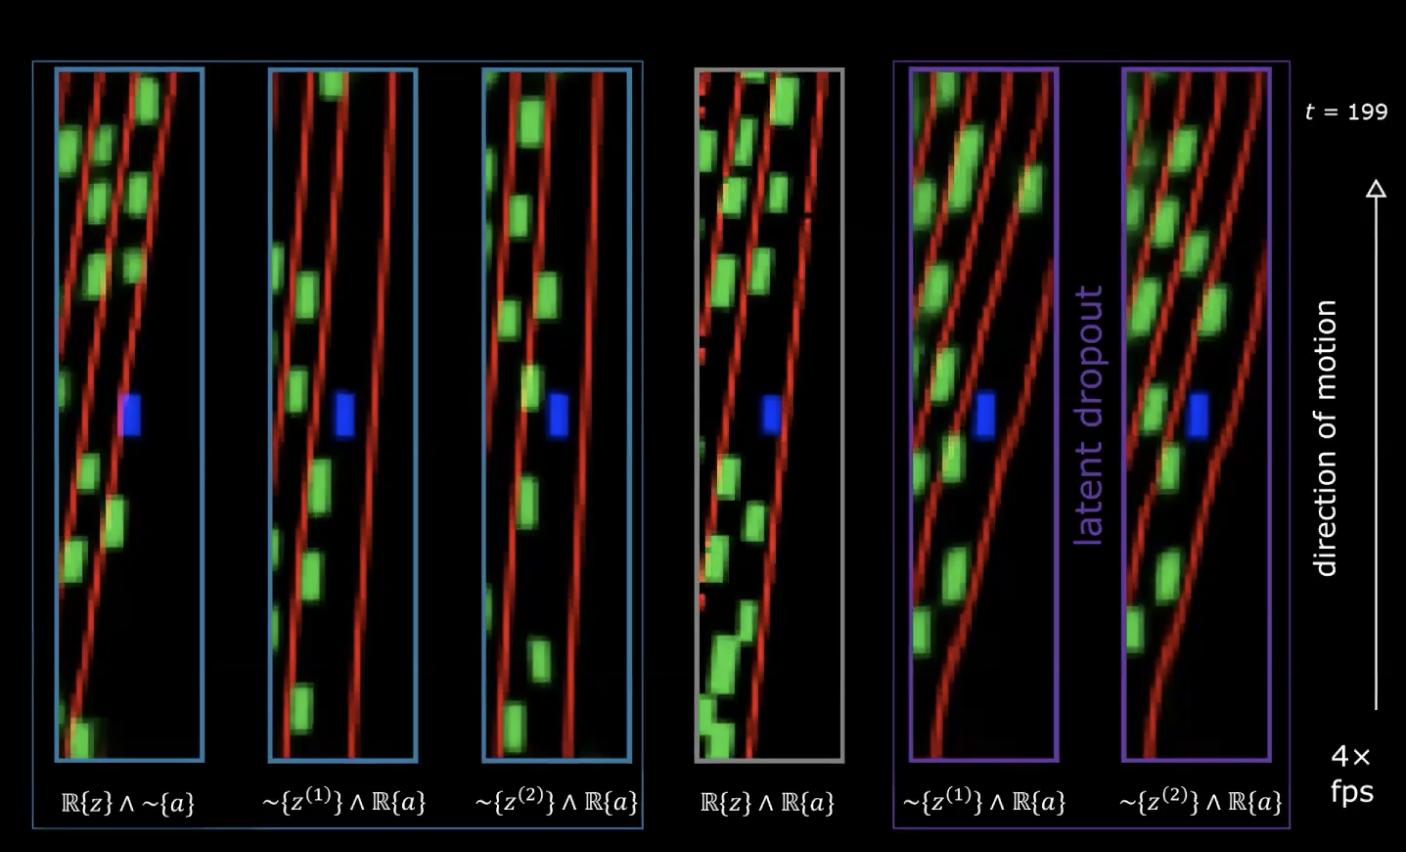
ফিগার ১৮: লেটেন্ট ড্রউপাউট ব্যবহারে কার্য্যক্ষমতা
ডান পাশের শেষ দুটি ছবিতে আমরা দুই সেট লেটেন্ট ভেরিয়েবল দেখতে পাই যাদের আসল এ্যাকশনের ক্রম আছে এবং এই নেটওয়ার্কগুলো লেটেন্ট ড্রপয়াউট ট্রিক ব্যবহার করে ট্রেইন করা হয়েছে। এখন আমরা দেখতে পাই যে, রোটেশন এখন এ্যাকশন দ্বারা এনকোডেড হয়েছে এবং লেটেন্ট ভেরিয়েবল দ্বারা হচ্ছে না।
এজেন্টকে ট্রেইন করা
পূর্বের অধ্যায়ে আমরা দেখেছি, বাস্তব বিশ্বের অভিজ্ঞতাকে সিমুলেট করার মাধ্যমে আমরা একটি ওয়ার্ল্ড মডেল পেতে পারি। এই অধ্যায়ে আমরা আমাদের এজেন্টকে ট্রেইন করার জন্য এই ওয়ার্ল্ড মডেলটি ব্যবহার করব। আমাদের লক্ষ্য হল, পূর্বের স্টেটের ইতিহাস থেকে একটি এ্যাকশন নেওয়ার পলিসি লার্ন করা। একটি স্টেট $s_t$ (বেগ, অবস্থান এবং প্রসঙ্গ ছবি) দেওয়া আছে, এজেন্টটি একটি এ্যাকশন $a_t$ (ত্বরণ, ব্রেক এবং স্টিয়ারিং) নেয়, ওয়ার্ল্ড মডেলটি পরবর্তী স্টেট এবং তার কস্ট $(s_t, a_t)$ আউটপুট দেয়, যেটি প্রক্সিমিট কস্ট এবং লেন কস্ট এর সমন্বয়।
\[c_\text{task} = c_\text{proximity} + \lambda_l c_\text{lane}\]পূর্বের অধ্যায়ে আলোচিত, অস্পষ্ট প্রেডিকশন এড়াতে, আমাদের ফিউচার স্টেট $s_{t+1}$ অথবা পূর্বেকার বিন্যাস $P(z)$ থেকে লেটেন্ট ভেরিয়েবল $z_t$ কে স্যাম্পল করতে হবে। পরবর্তী স্টেট $\hat s_{t+1}$ এবং কস্টকে প্রেডিক্ট করার জন্য ওয়ার্ল্ড মডেলটি পূর্বের স্টেট $s_{1:t}$ এবং এজেন্টের এ্যাকশনটি পায়। এটি একটি মডেল গঠন করে যেটির একাধিকবার প্রতিলিপি (ফিগার ১৯) তৈরী করা হয়, যা অপ্টিমাইজেশনের জন্য আমাদের চূড়ান্ত প্রেডিকশন এবং লস দেয়।
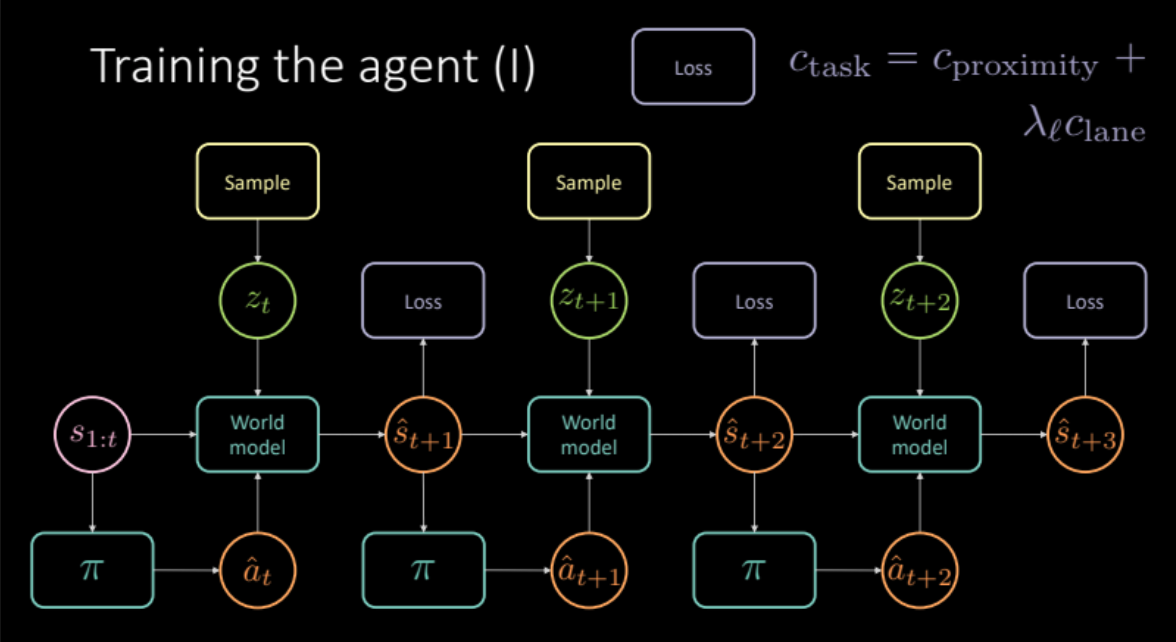
Fফিগার ১৯: নির্দিষ্ট কাজের জন্য মডেল আর্কিটেকচার
আমাদের মডেল প্রস্তুত আছে। চলো এটি কেমন দেখায় দেখি!!
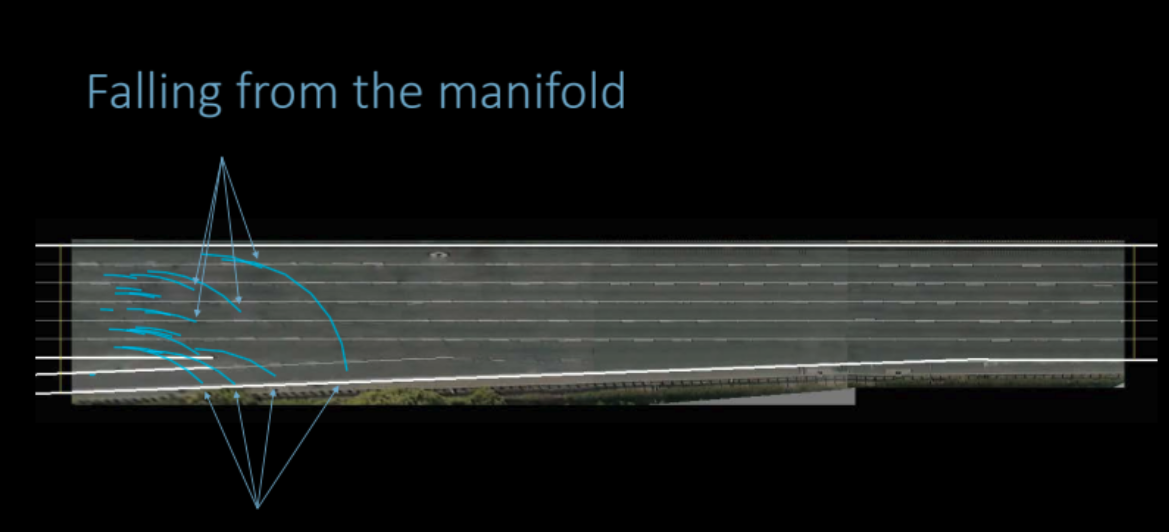
ফিগার ২০: লার্ন্ড পলিসিঃ এজেন্ট সুংঘর্ষ করে অথবা রাস্তা থকে সরে যায়।
দূর্ভাগ্যবশত এটি কাজ করেনা। এভাবে পলিসি ট্রেইন করা কার্যকর নয় কারন এটি সব কালো প্রেডিক্ট করা শিখছে যেহেতু এটি করলে কস্ট শূন্য হচ্ছে।
এই সমস্যা কিভাবে সমাধান করতে পারি ? প্রেডিকশনের উন্নতি করার জন্য আমরা কি অন্য গাড়ি গুলোকে অনুকরণ করতে পারি ?
অভিজ্ঞকে অনুকরণ
এখানে আমরা কিভাবে অভিজ্ঞদের অনুকরণ করতে পারি? আমরা চাই, কোন একটি স্টেট থেকে একটি নির্দিষ্ট এ্যকশন নেওয়ার পর যেন আমাদের মডেলের প্রেডিকশন ফিউচারের যতোটা সম্ভব কাছাকাছি হয়। এটি আমাদের ট্রেইনিংয়ের জন্য এক্সপার্ট রেগুলারাইজারের মত কাজ করে। এখন আমাদের কস্ট ফাংশনে নির্দিষ্ট কাজের জন্য কস্ট (প্রক্সিমিটি এবং লেন কস্ট) এবং এক্সপার্ট রেগুলারাইজার টার্ম উভয়ই আছে। এখন যেহেতু আমরা আসল ফিউচারের সাপেক্ষেও কস্ট গনণা করছি, আমাদেরকে মডেল থেকে লেটেন্ট ভেরিয়েবলটি সরিয়ে ফেলতে হবে কারন লেটেন্ট ভেরিয়েবল আমাদের নির্দিষ্ট প্রেডিকশন দেয়, কিন্তু এই সেটিংস গড় প্রেডিকশনের জন্য ভালো কাজ করে।
\[\mathcal{L} = c_\text{task} + \lambda u_\text{expert}\]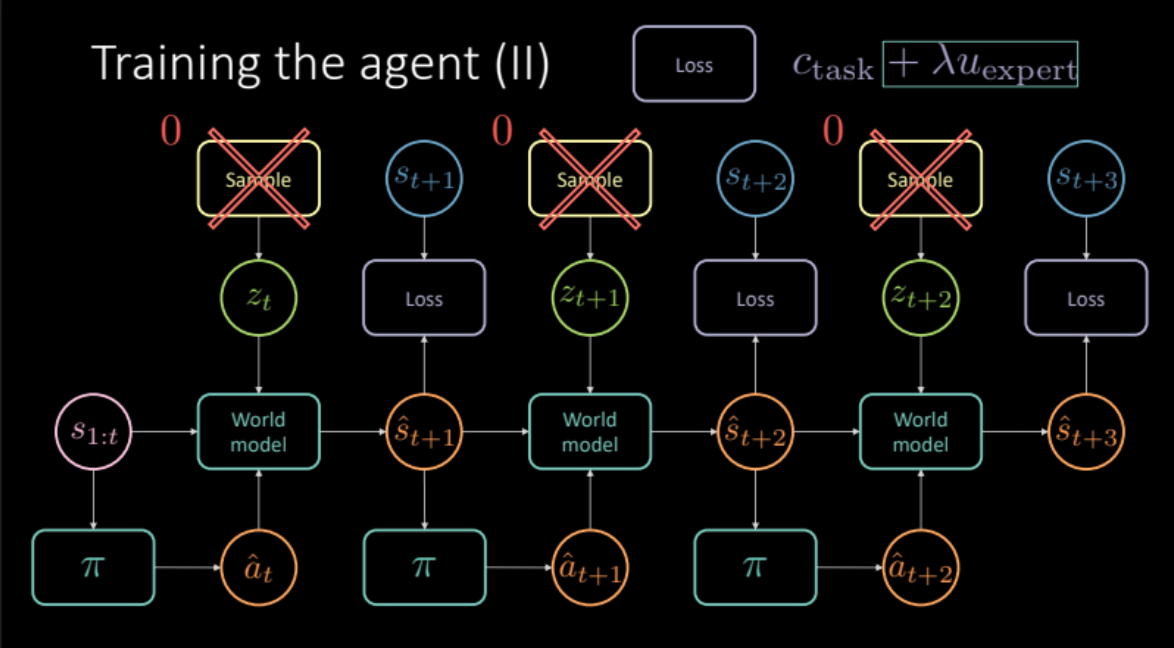
ফিগার ২১: এক্সপার্ট রেগুলারাইজেশন ভিত্তিক মডেল প্রেডিকশন
এই মডেলটি কেমন পারফর্ম করে ?
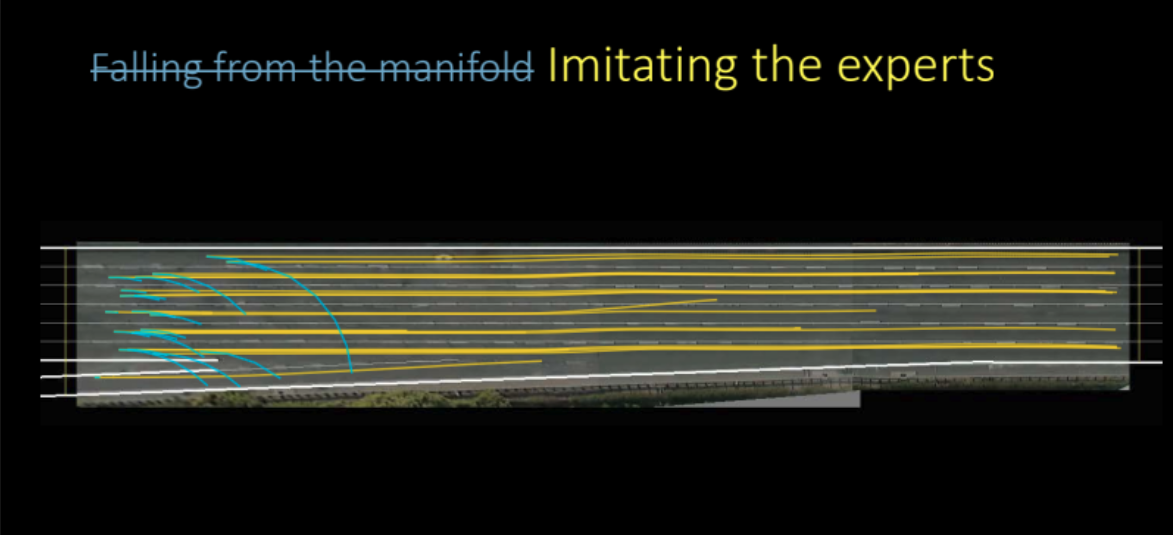
ফিগার ২২: অভিজ্ঞদের অনুকরণ করে পলিসি লার্ণ করা।
আমরা উপরের ছবিতে দেখতে পাচ্ছি, এই মডেলটি আসলে অবিশ্বাস্য রকমের ভালো করছে এবং খুবই ভালো প্রেডিকশন করতে লার্ন করেছে। এটি অনুকরণ ভিত্তিক মডেল লার্নিং, আমরা চেষ্টা করেছি আমাদের মডেল যেন অন্যদের অনুকরণের চেষ্টা করে।
কিন্তু আমরা কি আরো ভালো করতে পারি ? আমরা কি শেষে বাদ দেয়ার জন্য ভেরিয়েশনাল অটোএনকোডার ট্রেইন করলাম?
এটি দেখা যাচ্ছে যে আমরা আরো ভালো করতে পারি যদি আমরা ফরওয়ার্ড মডেল প্রেডিকশনের অনিশ্চয়তাকে হ্রাস করার চেষ্টা করি।
ফরওয়ার্ড মডেলের অনিশ্চয়তাকে হ্রাস করা
ফরোয়ার্ড মডেলের অনিশ্চয়তা হ্রাস বলতে আমরা কি বুঝি এবং এমরা এটি কিভাবে করবো ? প্রশ্নটির উত্তর দেয়ার আগে আমরা তৃতীয় সপ্তাহের অনুশীলন পুনরাবৃত্তি করি।
আমরা যদি একই ডাটার উপর একাধিক মডেল ট্রেইন করি, সব মডেল ট্রেইনিং রিজিওনের পয়েন্টগুলোতে (লাল রঙে দেখানো হয়েছে) একমত হয় যার ফলে ট্রেইনিং রিজিওনে ভেরিয়েন্স শূন্য হয়। কিন্তু আমরা ট্রেইনিং রিজিওন থেকে যত দূরে সরতে থাকি, এই মডেলগুলোর লস ফাংশনের ট্রিজেকটরি ডাইভার্জ হতে থাকে এবং ভেরিয়েন্স বারতে থাকে। এটি ফিগার ২৩ এ দেখানো হয়েছে। যেহেতু ভেরিয়েন্স ডিফারেন্সিয়েবল, আমরা ভেরিয়েন্স হ্রাস করার উদ্দ্যেশ্য এর উপর গ্রেডিয়েন্ট ডিসেন্ট চালাতে পারি।
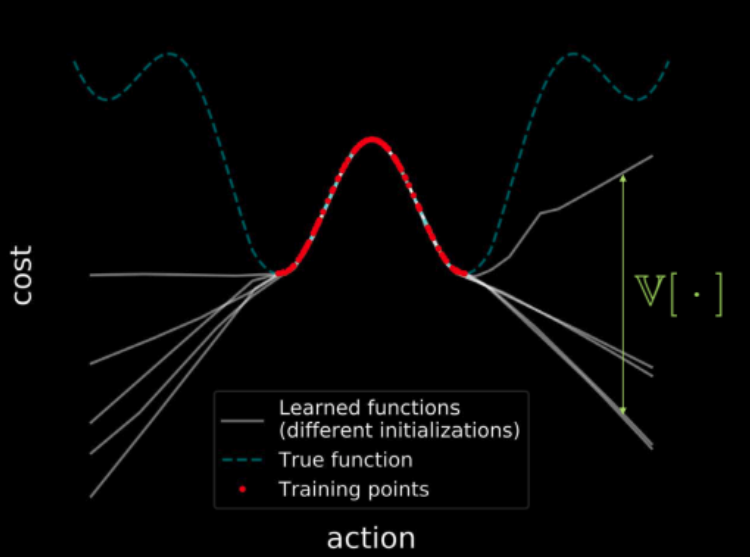
ফিগার ২৩: পুরো ইনপুট স্পেসের উপর কস্ট এর ভিজুয়ালাইজেশন
আবারো আলোচনায় ফিরে আসি, শুধুমাত্র পর্যবেক্ষণ ডাটার উপর নির্ভর করে পলিসি লার্নিং চ্যালেঞ্জিং, কারন এক্সিকিউশনের সময় স্টেটসমূহের বিন্যাস ট্রেনিংয়ের সময়কার পর্যেবেক্ষিত বিন্যাস থেকে আলাদা হতে পারে। ওয়ার্ল্ড মডেলটি যেই ডোমেইনে ট্রেইন করা হয়েছিলো, এর বাইরে দৈবভাবে প্রেডিকশন করতে পারে, যার ফলে ভুলভাবে নিম্ন কস্ট হতে পারে। পলিসি নেটওয়ার্ক তখন এই ভুলগুলোকে কাজে লাগাইয়ে এ্যাকশন দিতে পারে যা ভুল অপ্টিমিস্টিক স্টেটে নিয়ে যেতে পারে।
এই সমস্যার মোকাবেলায় আমরা আরেকটি কস্ট যোগ করবো যা ডাইনামিক্স মডেলের নিজের অনিশ্চয়তাগুলোকে পরিমাপ করবে। একই ইনপুট এবং এ্যাকশন অনেকগুলো ড্রপআউট মাস্কের মধ্য দিয়ে চালনা করে এবং বিভিন্ন আউটপুটের মধ্যেকার ভেরিয়েন্স গনণা করার মাধ্যমে এটি গনণা করা যায়। এটি পলিস নেটওয়ার্ককে মডেলটি যে এ্যাকশনগুলোর জন্য অত্মবিশ্বাসী শুধুমাত্র সেগুলো আউটপুট দিতে উৎসাহ দেয়।
\[\mathcal{L} = c_\text{task} + \lambda c_\text{uncertainty}\]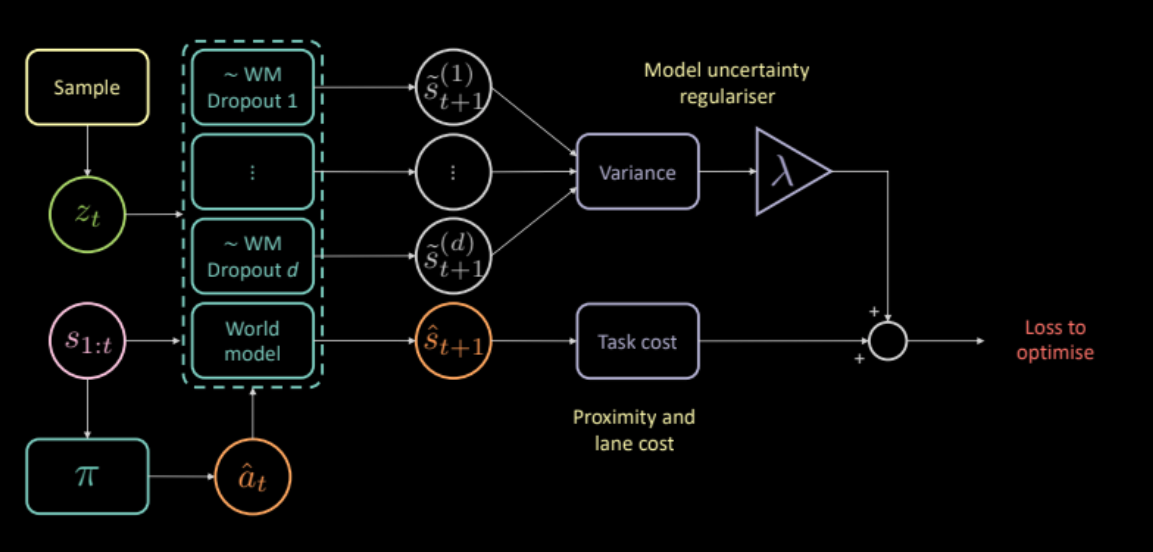
ফিগার ২৪: অনিশ্চয়তা রেগুলারাইজার ভিত্তিক মডেল আর্কিটেকচার
অনিশ্চয়তা রেগুলারাইজার কি আমাদের ভালো পলিসি লার্নিং এ সাহায্য করে ?
হ্যাঁ, এটি করে। আগের মডেলের চেয়ে এভাবে পলিসি লার্ন করা ভালো।
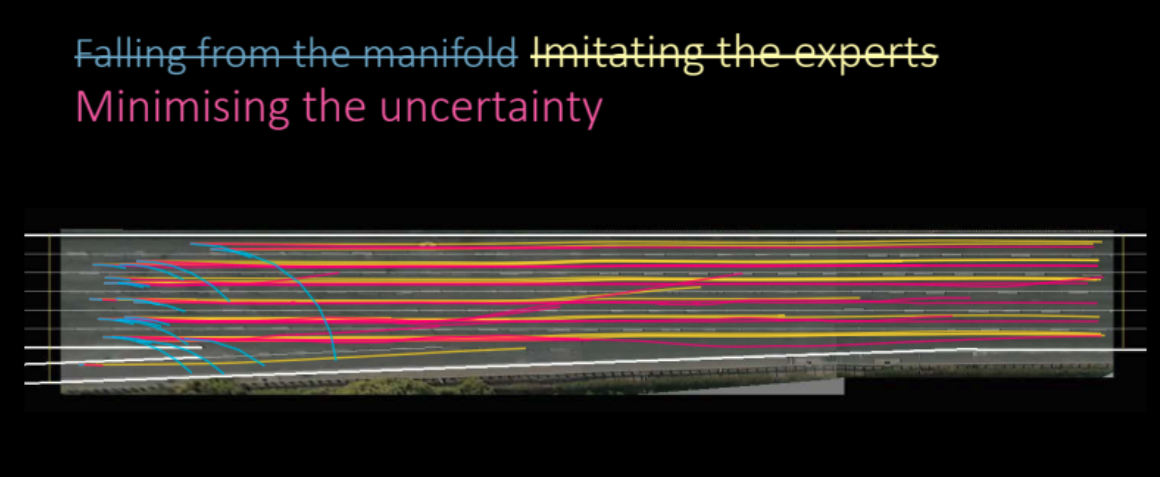
ফিগার ২৫: অনিচশ্চয়তা রেগুলারাইজার ভিত্তিক লার্নিং পলিসি
মূল্যায়ন
ফিগার ২৬ এ দেখা যাচ্ছে ঘন ট্রাফিকে এজন্টটি কত ভালো গাড়ি চালানো শিখেছে। হলুদ গাড়িটি আসল ড্রাইভার, নীল গাড়িটি আমাদের লার্ন্ড এজেন্ট এবং বাকি সকল সবুজ গাড়ি আমাদের কাছে অন্ধ (এদের নিয়ন্ত্রণ করা যাবে না)
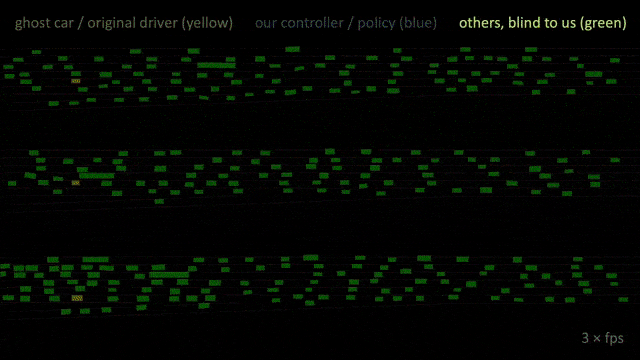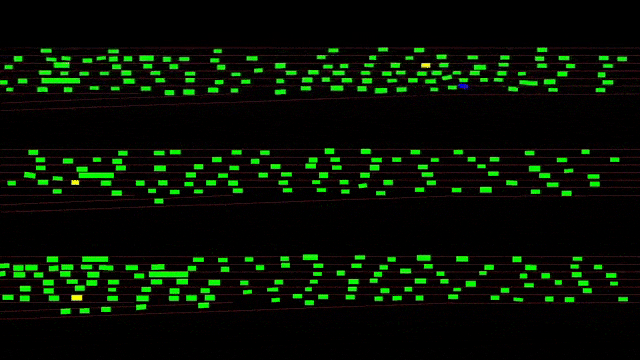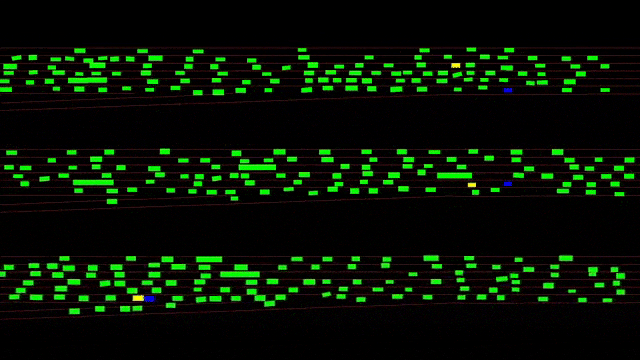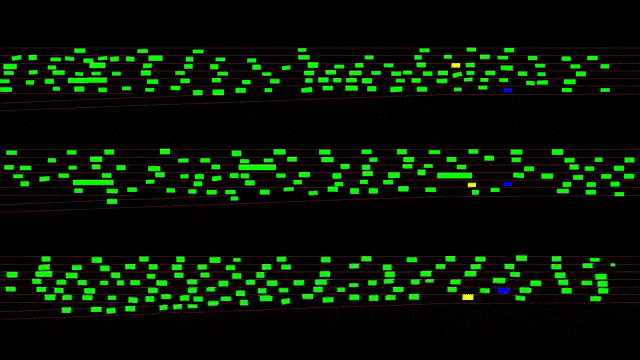
ফিগার ২৬: আনসার্টেনিটি রেগুলারাইজার দিয়ে মডেলটির কর্মক্ষমতা।
📝 Anuj Menta, Dipika Rajesh, Vikas Patidar, Mohith Damarapati
Aditya Chakma
14 Apr 2020