এক্টিভেশন এবং লস ফাংশন (প্রথম অংশ)
🎙️ Yann LeCunএক্টিভেশন ফাংশনসমূহ
আজকের লেকচারে আমরা পাইটর্চে কিছু গুরুত্বপূর্ন এক্টিভাশন ফাংশন এবং তাদেরকে কিভাবে বাস্তবায়ন করা যায় সে সম্পর্কে পর্যালোচনা করবো। এগুলো অনেকগুলো পেপার থেকে এসেছে, যেখানে দাবি করা হয়েছে এই ফাংশনগুলো নির্দিষ্ট কিছু সমস্যার ক্ষেত্রে ভালো কাজ করে।
ReLU - nn.ReLU()
\[\text{ReLU}(x) = (x)^{+} = \max(0,x)\]
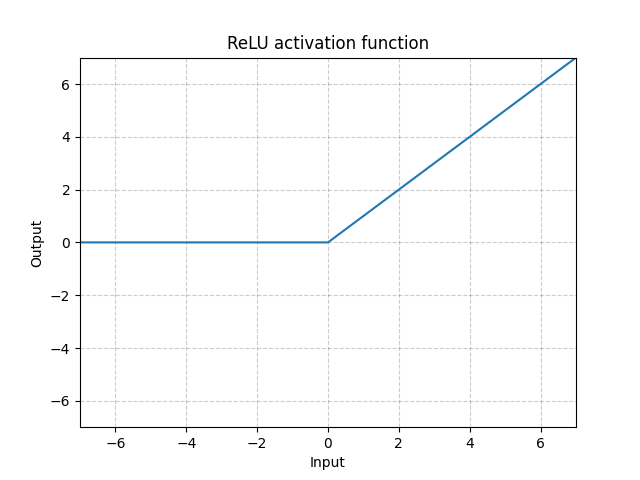
Fig. 1: ReLU
RReLU - nn.RReLU()
অনেক প্রকারের ReLU রয়েছে। র্যান্ডম ReLU(RReLU) এর সংজ্ঞা হলোঃ
\[\text{RReLU}(x) = \begin{cases} x, & \text{if} x \geq 0\\ ax, & \text{otherwise} \end{cases}\]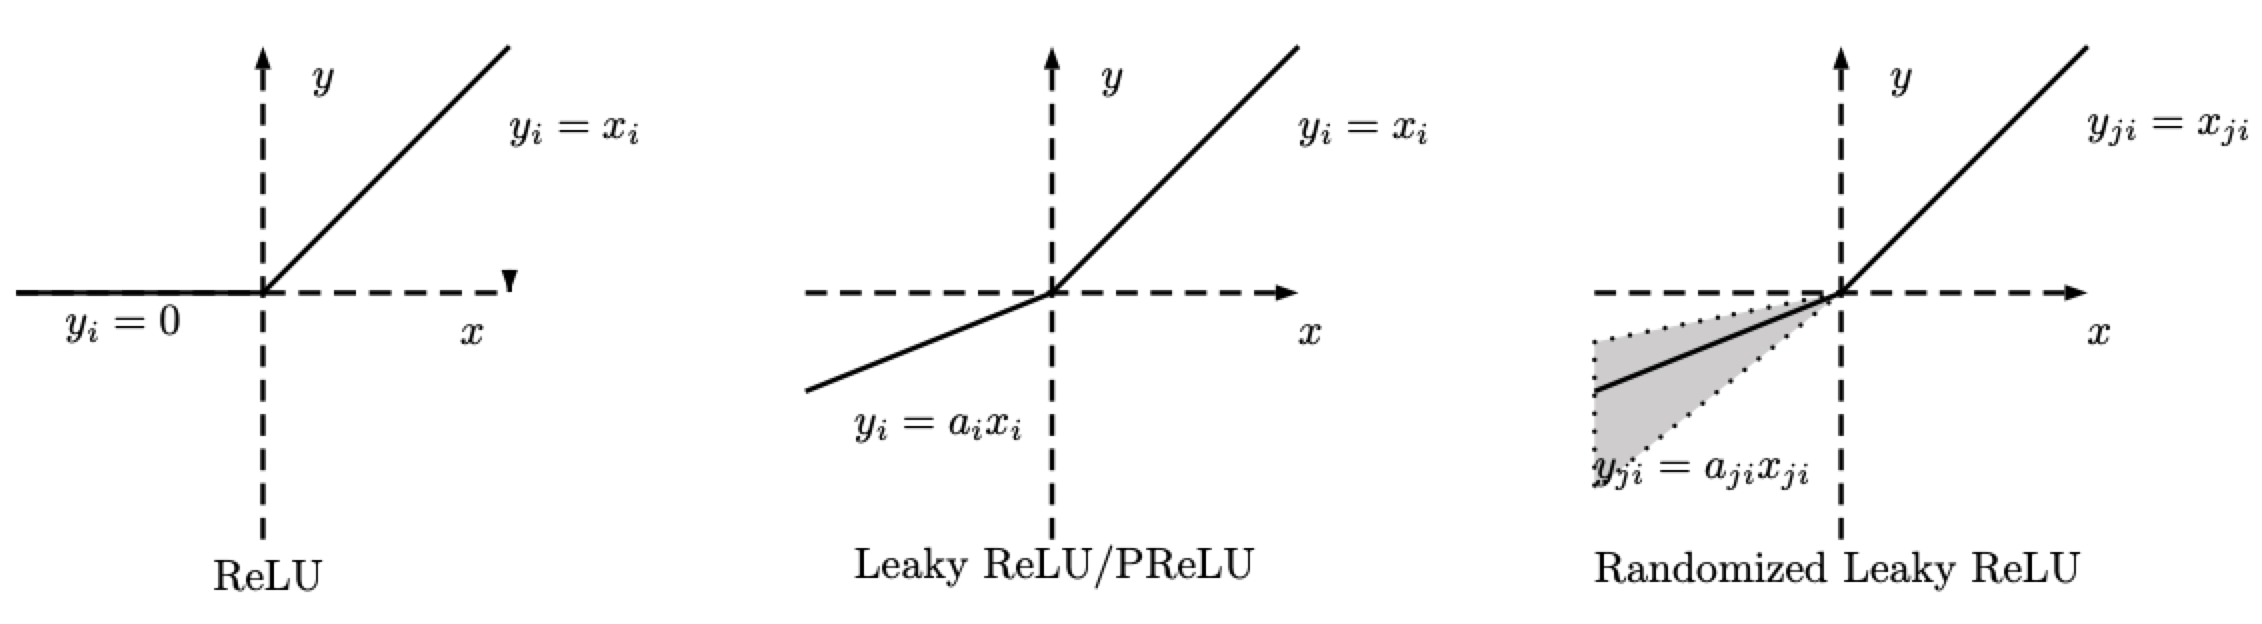
Fig. 2: ReLU, Leaky ReLU/PReLU, RReLU
খেয়াল কর, $a$ RReLU এর জন্য একটি র্যান্ডম ভারিয়েবল যেটি ট্রেইনিংয়ের সময় একটি নির্দিষ্ট সীমার মাঝে স্যামপ্লিং করতে থাকে এবং টেস্ট করার সময় নির্দিষ্ট থাকে। PReLU এর ক্ষেত্রে $a$ লার্ন করে। কিন্তু Leaky ReLU এর জন্য $a$ নির্দিষ্ট থাকে।
LeakyReLU - nn.LeakyReLU()
\[\text{LeakyReLU}(x) = \begin{cases}
x, & \text{if} x \geq 0\\
a_\text{negative slope}x, & \text{otherwise}
\end{cases}\]
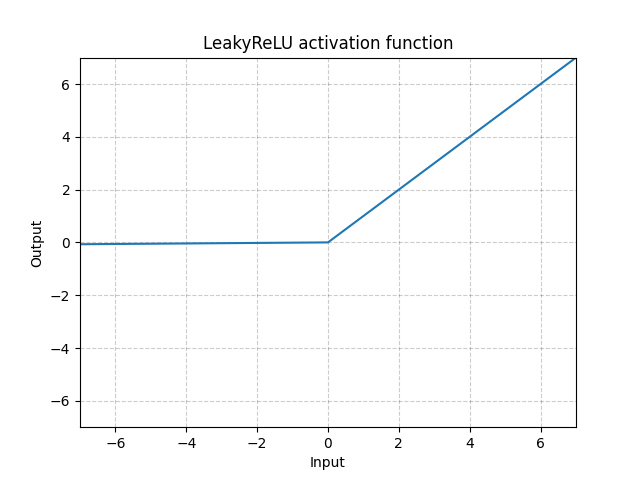
Fig. 3: LeakyReLU
এখানে $a$ একটি নির্দিষ্ট প্যারামিটার। সমীকরণটির নিচের অংশ dying ReLU সমস্যাটিকে প্রতিরোধ করে, যেটি ReLU গুলো নিষ্ক্রিয় হয়ে গেলে তৈরী হয়, এবং যেকোন ইনপুটের জন্য আউটপুট ০ দেয়। অতএব এটির গ্রেডিয়েন্ট ০। ঋণাত্মক ঢাল ব্যবহারে করলে এটি নেটওয়ার্কটিকে ব্যাক প্রোপাগেট করতে এবং নতুন দরকারী কিছু শিখতে সহায়তা করে।
চিকন নেটয়ার্কের ক্ষেত্রে LeakyReLU প্রয়োজন, কেননা vanilla ReLU ব্যবহার করে গ্রেডিয়েন্টের ফ্লো ব্যাক পাওয়া অনেকটা অসম্ভব। আমরা যদি এমন অংশেও থাকি যেখানে সবকিছু শূন্য হয়ে গিয়েছে, সেখানেও LeakyRelU দিয়ে গ্রেডিয়েন্ট পওয়া সম্ভব।
PReLU - nn.PReLU()
\[\text{PReLU}(x) = \begin{cases}
x, & \text{if} x \geq 0\\
ax, & \text{otherwise}
\end{cases}\]
এখানে $a$ একটি লার্নেবল প্যারামিটার।
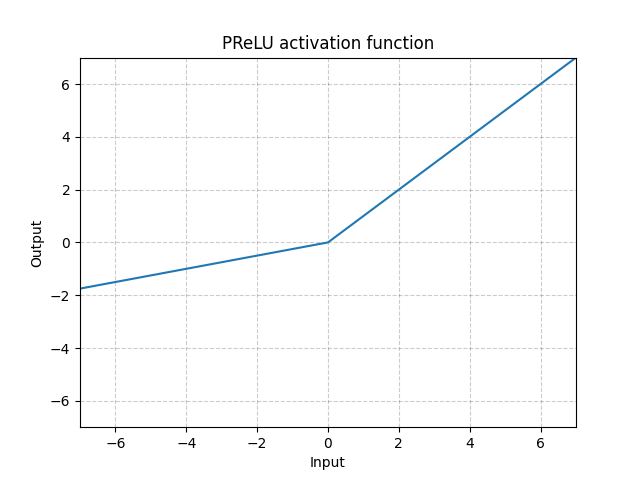
Fig. 4: ReLU
উপরের এক্টিভেশন ফাংশনগুলো(i.e. ReLU, LeakyReLU, PReLU) স্কেলের উপর নির্ভর করে না।
Softplus - Softplus()
\[\text{Softplus}(x) = \frac{1}{\beta} * \log(1 + \exp(\beta * x))\]
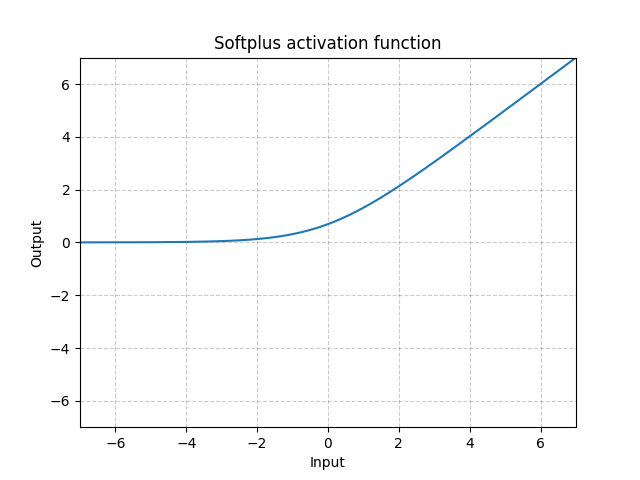
Fig. 5: Softplus
SoftPlus, ReLU ফাংশনের এর একটি কাছাকাছি অনুমান(অ্যপ্রোক্সিমেশন) যা একটি মেশিনের আউটপুট সবসময় ধনাত্মক করার জন্য ব্যবহার করা যায়।
$\beta$ যত বড় হতে থাকবে ফাংশনটি ততই ReLU এর মত হতে থাকবে।
ELU - nn.ELU()
\[\text{ELU}(x) = \max(0, x) + \min(0, \alpha * (\exp(x) - 1)\]
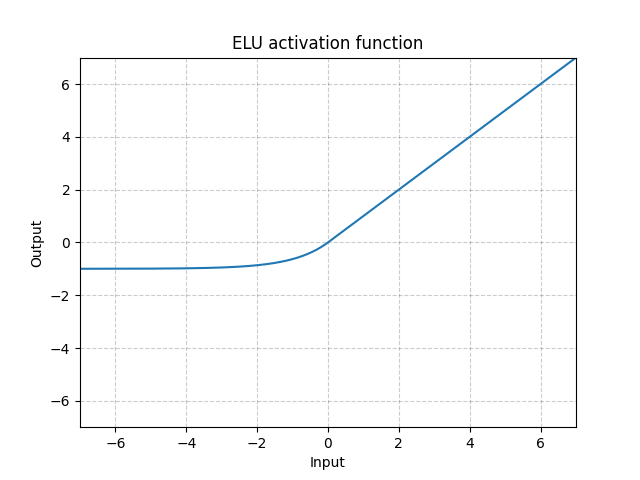
Fig. 6: ELU
এটি শূন্যের চেয়ে ছোট হতে পারে, ফলে সিস্টেমের গড় আউটপুট শূন্য হতে পারে। যার ফলে মডেলটি দ্রুত করভার্জ করতে পারে। এটির অন্য প্রকরণগুলোর (CELU, SELU) সাথে এটির পার্থক্য শুধু ভিন্ন প্যারামিটারাইজেশনে।
CELU - nn.CELU()
\[\text{CELU}(x) = \max(0, x) + \min(0, \alpha * (\exp(x/\alpha) - 1)\]
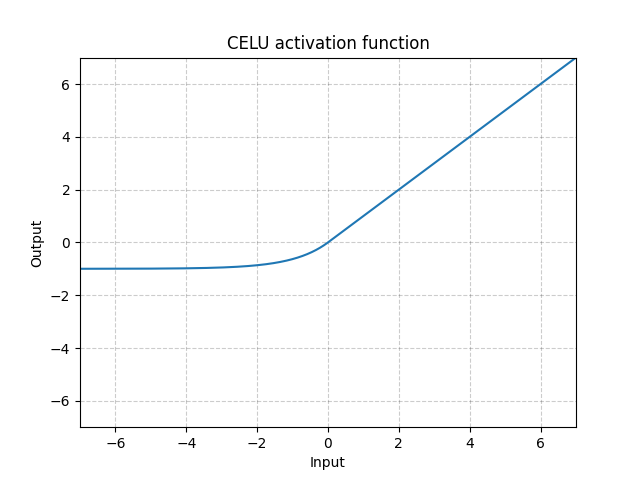
Fig. 7: CELU
SELU - nn.SELU()
\[\text{SELU}(x) = \text{scale} * (\max(0, x) + \min(0, \alpha * (\exp(x) - 1))\]
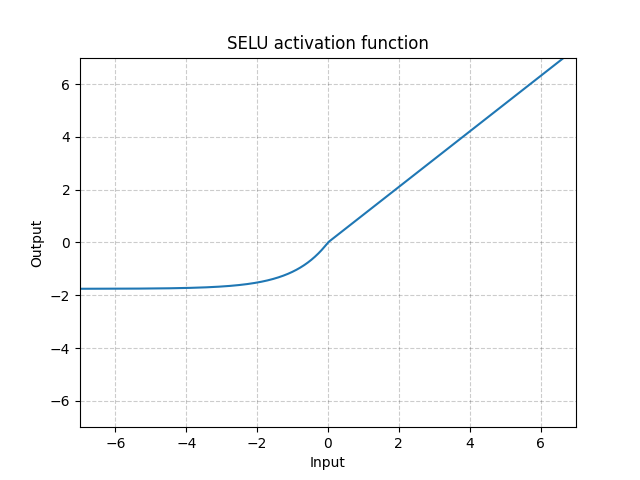
Fig. 8: SELU
GELU - nn.GELU()
\[\text{GELU(x)} = x * \Phi(x)\]
যেখানে $\Phi(x)$ গসিয়ান ডিস্ট্রিবিউসনের কিউমুলেটিভ ডিস্ট্রিবিউশন ফাংশন।
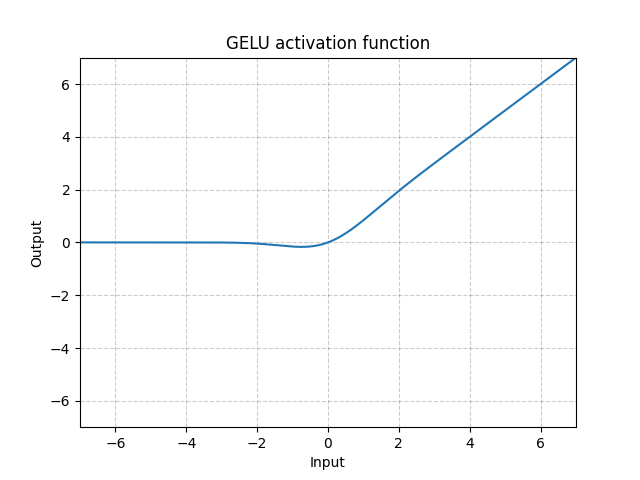
Fig. 9: GELU
ReLU6 - nn.ReLU6()
\[\text{ReLU6}(x) = \min(\max(0,x),6)\]
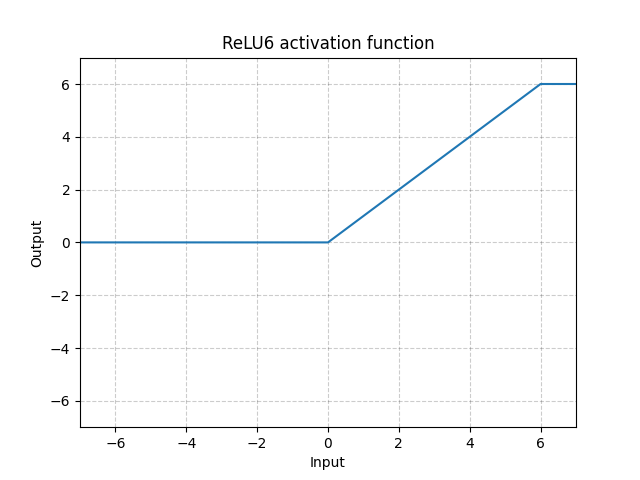
Fig. 10: ReLU6
এই ReLU টির ৬ এ সম্পৃক্তি হয়েছে। কিন্তু ৬ এ সম্পৃক্তি হওয়ার আসলে কোন নির্দিষ্ট কারণ নেই, সুতরাং আমরা নিচের Sigmoid ফাংশন ব্যবহার করে আরো ভালো ফল পেতে পারি।
Sigmoid - nn.Sigmoid()
\[\text{Sigmoid}(x) = \sigma(x) = \frac{1}{1 + \exp(-x)}\]
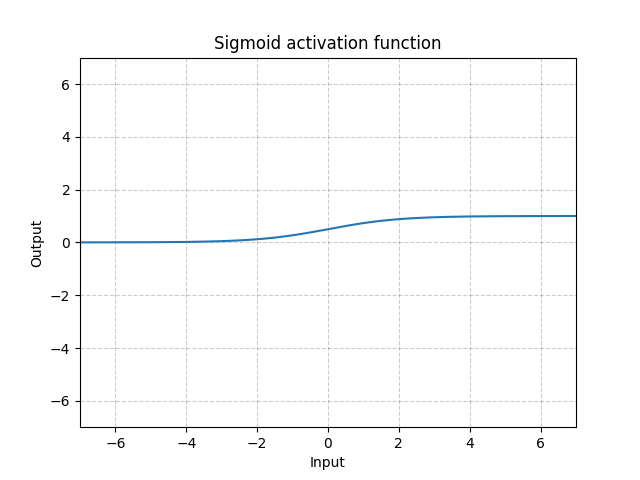
Fig. 11: Sigmoid
আমরা যদি Sigmoid ফাংশনগুলোকে একাধিক লেয়ার এ স্তূপ করি, তাহলে সিস্টেম শিখতে অদক্ষ হয়ে যেতে পারে এবং এক্ষেত্রে যত্নের সাথে ইনিসিয়ালাইজেশনের প্রয়োজন হয়। এর কারন হল ইনপুট যদি অনেক বড় বা খুব ছোট হয় তবে সিগময়েড ফাংশনের গ্রেডিয়েন্ট ০’র কাছাকাছি হয়। এক্ষেত্রে প্যারামিটারগুলোর আপডেটের জন্য কোন গ্রেডিয়েন্ট ফ্লো ব্যাক হয় না, এটি গ্রেডিয়েন্ট সাচ্যুরেটিং প্রব্লেম নামে পরিচিত। এজন্য ডিপ নিউরাল নেটয়ার্কের ক্ষেত্রে একটি কিঙ্ক ফানশনের(যেমন ReLU) ব্যবহারকে বেশি পছন্দ করা হয়।
Tanh - nn.Tanh()
\[\text{Tanh}(x) = \tanh(x) = \frac{\exp(x) - \exp(-x)}{\exp(x) + \exp(-x)}\]
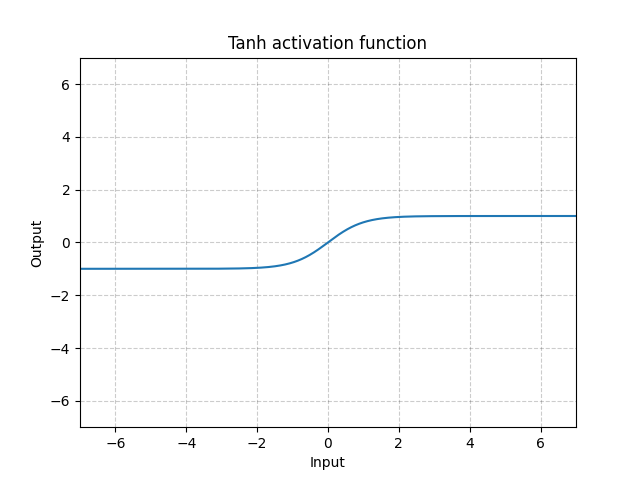
Fig. 12: Tanh
Tanh এবং Sigmoid মূলত একই, পার্থক্য হলো, Tanh এর কেন্দ্র শূন্য তে থাকে এবং এর সীমা -১ থেকে ১ পর্যন্ত। ফাংশনটির আউটপুট মুটামুটিভাবে গড়ে শূন্যের কাছাকাছি হয়। এজন্য মডেলটি তাড়াতাড়ি কনভার্জ করবে। খেয়াল করার মত বিষয় হলো, ইনপুটের গড় যদি শূন্যের কাছাকাছি হয় তবে মডেলটি অনেক তাড়াতাড়ি কনভার্জ করে। এর একটি উদাহরণ হলো ব্যাচ-নরমালাইজেশন।
Softsign - nn.Softsign()
\[\text{SoftSign}(x) = \frac{x}{1 + |x|}\]
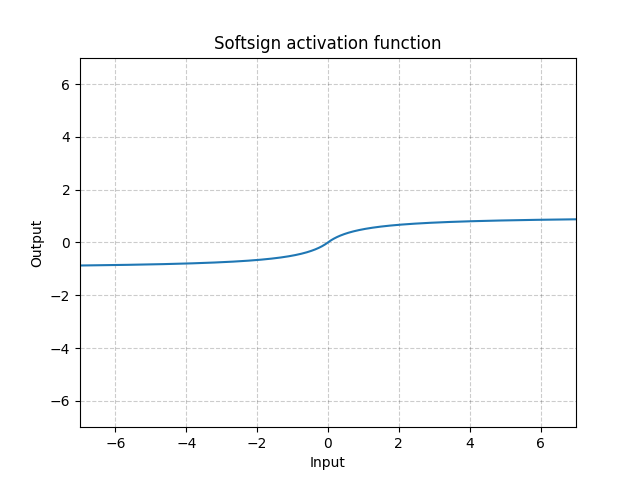
Fig. 13: Softsign
এটি Sigmod ফাংশনের মতই, তবে এটি অসীমতত এর দিকে ধীরে অগ্রসর হয় এবং গ্র্যাডিয়েন্ট ভ্যানিশিং সমস্যাকে (কিছুটা হলেও) লাঘব করে।
Hardtanh - nn.Hardtanh()
\[\text{HardTanh}(x) = \begin{cases}
1, & \text{if} x > 1\\
-1, & \text{if} x < -1\\
x, & \text{otherwise}
\end{cases}\]
রৈখিক অংশটূকুর সীমা [-১, ১], min_val এবং max_val ব্যবহার করে বিন্যাস্ত করা যেতে পারে।
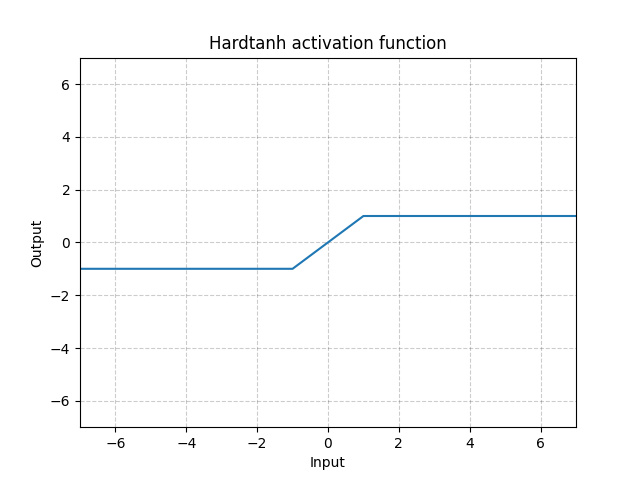
Fig. 14: Hardtanh
এটি অদ্ভুটভাবে খুবই ভালো কাজ করে বিশেষত যদি ওয়েটগুলোর মান ছোট রাখা হয়।
Threshold - nn.Threshold()
\[y = \begin{cases}
x, & \text{if} x > \text{threshold}\\
v, & \text{otherwise}
\end{cases}\]
এটির ব্যবহার খুবই বিরল কারন এটি দিয়ে আমরা গ্রেডিয়েন্ট ব্যাক প্রোপাগেট করতে পারি না। এবং ৬০ ও ৭০ এর দশকে মানুষ যখন বাইনারি নিউরণ ব্যবহার করছিলো, তখন এটি তাদের ব্যাক প্রোপাগেশন ব্যবহারে বাধা দিচ্ছিলো।
Tanhshrink - nn.Tanhshrink()
\[\text{Tanhshrink}(x) = x - \tanh(x)\]
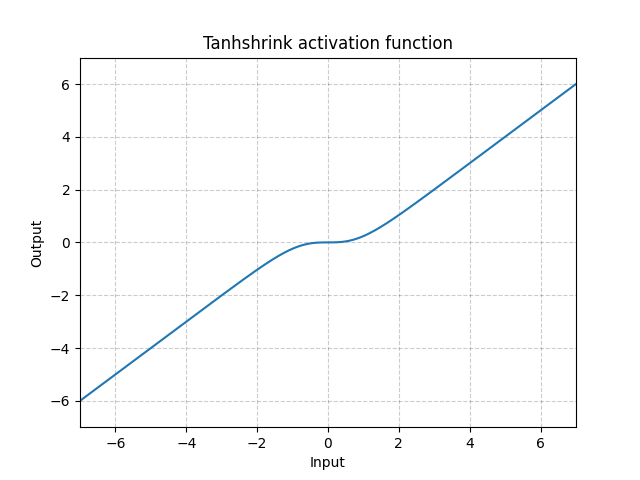
Fig. 15: Tanhshrink
ল্যাটেন্ট ভ্যারিয়েবলের মান গণনা করা ছাড়া এটি খুব একটা ব্যবহার করা হয় না।
Softshrink - nn.Softshrink()
\[\text{SoftShrinkage}(x) = \begin{cases}
x - \lambda, & \text{if} x > \lambda\\
x + \lambda, & \text{if} x < -\lambda\\
0, & \text{otherwise}
\end{cases}\]
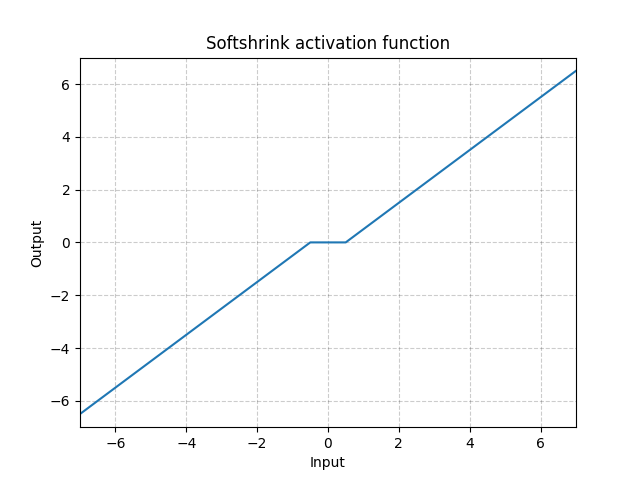
Fig. 16: Softshrink
এটি মূলত ভেরিয়েবলটিকে ধ্রুবকতার সাথে শুন্যের দিকে সঙ্কুচিত করে, এবং যদি ভেরিয়েবলটি শুন্যের কাছাকাছি হয় তবে এর মানকে শুন্য করে দেয়। $\ell_1$ এর মানদন্ড হিসেবে এটিকে তুমি গ্রেডিয়েন্টের এক ধাপ হিসেবে ধরে নিতে পারো এটি ইটেরেটিভ স্রিংকেজ-থেরেসহোল্ডিং এ্যলগরিদমেরও (ISTA) একটি ধাপ। কিন্তু এটি সাধারণত স্ট্যান্ডার্ড নিউরাল নেটয়ার্কের এক্টিভেশন হিসেবে ব্যবহৃত হয়না।
Hardshrink - nn.Hardshrink()
\[\text{HardShrinkage}(x) = \begin{cases}
x, & \text{if} x > \lambda\\
x, & \text{if} x < -\lambda\\
0, & \text{otherwise}
\end{cases}\]
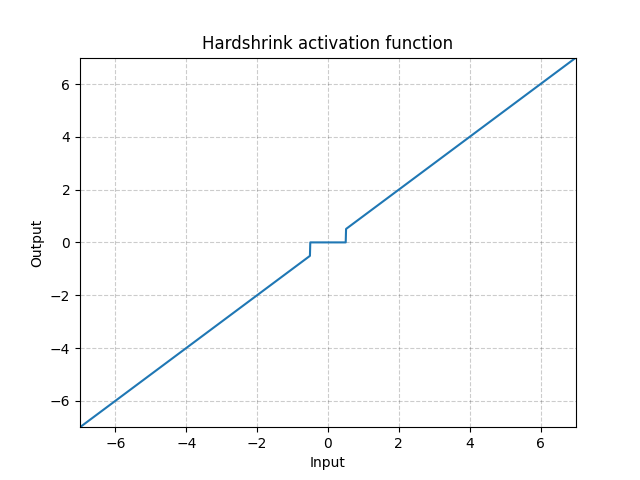
Fig. 17: Hardshrink
স্পার্স কোডিং ছাড়া এটি খুব একটা ব্যবহৃত হয় না।
LogSigmoid - nn.LogSigmoid()
\[\text{LogSigmoid}(x) = \log\left(\frac{1}{1 + \exp(-x)}\right)\]
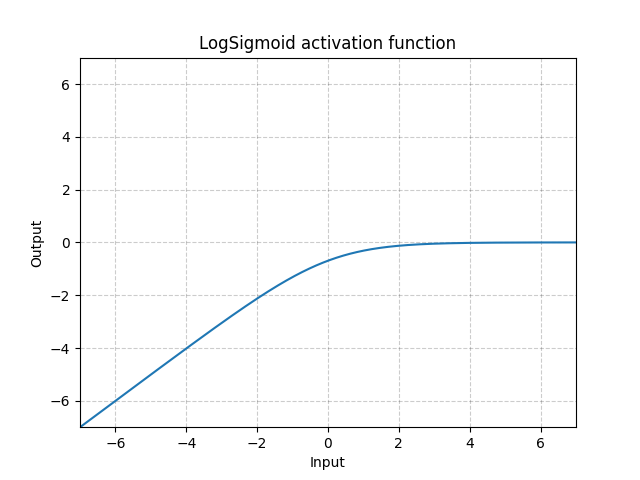
Fig. 18: LogSigmoid
এটি বেশিরভাগ সময় লস ফাংশন হিসেবে ব্যবহৃত হয় কিন্তু এক্টিভেশনে সাধারণত ব্যবহৃত হয়না।
Softmin - nn.Softmin()
\[\text{Softmin}(x_i) = \frac{\exp(-x_i)}{\sum_j \exp(-x_j)}\]
এটি সংখ্যাকে প্রোবাবিলিটি ডিস্ট্রিবিউশনে পরিবর্তন করে।
Soft(arg)max - nn.Softmax()
\[\text{Softmax}(x_i) = \frac{\exp(x_i)}{\sum_j \exp(x_j)}\]
LogSoft(arg)max - nn.LogSoftmax()
\[\text{LogSoftmax}(x_i) = \log\left(\frac{\exp(x_i)}{\sum_j \exp(x_j)}\right)\]
এটি মূলত লস ফাংশনে ব্যবহার করা হয়, কিন্তু এ্য্যাক্টিভেশন হিসেবে নয়।
প্রশ্ন-উত্তর এক্টিভেশন ফাংশন
nn.PReLU() সম্পর্কিত প্রশ্ন
-
আমরা কেন সব চ্যানেল এর জন্য , $a$ একই মানটি চাই?
বিভিন্ন চ্যানেলে বিভিন্ন $a$ থাকতে পারে। তুমি $a$ কে সব ইউনিটের জন্য প্যারামিটার হিসেবে ব্যবহার করতে পারো এটি ফিচার ম্যাপ হিসেবেও বন্তন করা যেতে পারে।
-
আমরা কি $a$ শিখেছি ? $a$ শিখা কি সুবিধাজনক ?
আপনি $a$ শিখতে পারেন, বা একে ঠিক করতে পারেন। এটিকে ঠিক করার কারনটি হচ্ছে, নন-লিনিয়ারিটি যাতে আমাদের ঋনাত্মক অংশেও অশূন্য গ্রেডিয়েন্ট দেয় সেটি নিশ্চিত করা। $a$ কে লার্নেবল করলে এটি সিস্টেমকে নন-লিনিয়ারকে, লিনিয়ার ম্যাপিং বা ফুল রেক্টিফিকেশনে পরিবর্তন করতে সাহায্য করে। এটির কিছু ব্যবহারিতা রয়েছে, যেমন এজ পোলারিটি নির্বিশেষে, এজ ডিটেক্টর।
-
আপনি আপনার নন-লিনিয়ারটিকে কতটা জটিল করতে চান ?
তাত্ত্বিকভাবে আমরা, একটা পুরো নন-লিনিয়ার মডেলকে খুবই জটিল পদ্ধতিতে প্যারামিটারাইজ করতে পারি। যেমনঃ স্প্রিং প্যারামিটার, চেবিশেভ পোলিনমিয়াল ইত্যাদি। প্যারামিটারাইজ করাটা লার্নিং প্রক্রিয়ার একটা অংশ হতে পারে।
-
আপনার সিস্টেমে অনেকগুলো ইউনিট থাকার চেয়ে, প্যারামিটারাইজ করার সুবিধা কি?
এটি আসলে নির্ভর করে আপনি কি চান। যেমন, নিম্ন মাত্রার স্পেসে রিগ্রেশন করার সময় প্যারামিটারাইজেশন সাহায্য করতে পারে। কিন্তু আপনার কাজটি যদি উচ্চ ডাইমেনশনাল স্পেসে হয়; যেমন ইমেজ রেকগনিশন, শুধু একটি নন-লিনিয়ারিটিই প্রয়োজন এবং মনোটনিক নন-লিনিয়ারিটি এক্ষেত্রে ভালো কাজ করবে। সংক্ষেপে, আপনি যেকোন ফাংশনকে চাইলে প্যারামিটারাইজ করতে পারবেন, কিন্তু এটি সবসময় সুবিধা দিবে না।
কিঙ্ক সম্পর্কিত প্রশ্ন।
- একক কিঙ্ক বনাম দ্বৈত কিঙ্ক
দ্বৈত কিঙ্ক এর একটি অন্তরনির্মিত পরিমাপক আছে। যার মানে হচ্ছে, ইনপুট লেয়ারকে যদি দুই দিয়ে গুণ করা হয় (অথবা, সিগনাল এর মানকে দুই দিয়ে গুণ করা হয়), তবে আউটপুট পুরোপুরি আলাদা হবে। সিগনালটি নন-লিনিয়ার হবে, যার ফলে তুমি পুরো আলাদা ধরনের আউটপুট পাবে। কিন্তু তুমি যদি এক কিঙ্ক এর ফাংশন ব্যবহার কর তবে, ইনপুটকে দুই দিয়ে গুণ করলে, আউটপুট ও দুই দিয়ে গুণ হয়ে যাবে।
- কিঙ্ক যুক্ত নন-লিনিয়ার এক্টিভেশন এবং স্মুথ নন-লিনিয়ার এক্টিভেশনের পার্থক্য। কেন/কখন একটিকে পছন্দ করা হয়?
এটি একটি পরিমাপক সাম্যটার ব্যাপার। কিঙ্ক যদি অনেক কঠিন হয়, তবে ইনপুটকে দুই দিয়ে গুণ করলে আউটপুট ও দুই দিয়ে গুণ হবে। তোমার যদি একটি স্মুথ রুপান্তর থাকে, যেমন তুমি যদি ইনপুটকে ১০০ দিয়ে গুণ কর, আউটপুট দেখে মনে হবে এটি একটি কঠিন কিঙ্ক, কারুন স্মুথ অংশটুকু ১০০র গুণকে সঙ্কুচিত হয়েছে। তুমি যদি ইনপুটকে ১০০ দিয়ে ভাগ কর, তবে কিঙ্কটি একটি স্মুথ কনভেক্স ফাংশনের মত হয়ে যাবে। তাই, ইনপুটের পরিমাপ পাল্টে তুমি, এক্টিভেশন ফাংশনের ধর্ম পাল্টাতে পারো।
অনেকসময় এটি একটি সমস্যা হয়ে যেতে পারে। উদাহরণ স্বরূপ, তুমি একটি মাল্টি-লেয়ার নিউরাল নেট ট্রেইন করছো এবং তোমার কাছে দুটি পাশাপাশি লেয়ার আছে। একটি লেয়ারের ওয়েট আরেকটি লেয়ারের ওয়েট থেকে কত বড় হতে পারে, তার ভালো নিয়রন্ত্রণ তোমার হাতে নেই। তোমার কাছে যদি নন-লিনিয়ারিটি থাকে যা স্কেলকে গ্রাহ্য করে, তোমার নেটয়ার্কের কাছে প্রথম লেয়ারে কত আকারের ওয়েট ম্যাট্রিক্স ব্যবহার করা হবে তার জন্য কোন অভিমত নেই, কারন তাহলে এটি তার পুরো ধর্ম কে বদলে দিবে।
সমস্যাটিকে ঠিক করার একটি উপায় হচ্ছে, ওয়েট গুলোর উপর হার্ড ওয়েট ঠিক করা যাতে তুমি লেয়ার গুলোর ওয়েটকে নরমালাইজ করতে পারো, যেমন ব্যাচ নর্মালাইজেশন। এটে ইউনিটে যে ভ্যারিয়েন্স থাকে তা ধ্রুবক হয়ে যায়। তুমি যদি স্কেল স্থির করে দাও তবে, দ্বৈত কিঙ্ক সিস্টেমের নন-লিনিয়ারিটির কোন অংশ ব্যবহার করা হবে তা বাছাইয়ে কোন উপায় থাকবে না। এই ‘স্থির’ অংশ যদি অনেক ‘লিনিয়ার’ হয়ে যায় তবে এটি একটি সমস্যা হয়ে যেতে পারে। যেমন, সিগময়েড অনেকটা শূন্যের কাছাকাছি লিনিয়ার হয়ে যায়, এতে ব্যাচ নর্মালাইজেশনের আউটপুট ‘নন-লিনিয়ার’ ভাবে এক্টিভ (শুন্যের কাছাকাছি) করা যায় না।
ডিপ নেটয়ার্ক কেন একক কিঙ্কে ভালো কাজ করে এটি এখনো পরিষ্কার না। এটি স্কেল সাম্যতা ধর্মের জন্য হতে পারে।
soft(arg)max ফাংশনে একটি তাপমাত্রা গুণাঙ্ক
-
কখন আমরা তাপমাত্রা গুণাঙ্কা ব্যবহার করি, এবং কেন?
কিছুটা হলেও, আগত ওয়েটগুলোর সাথে তাপমত্রা অপ্রয়োজনীয়। Softmax এ যদি তোমার ওয়েটেড যোগফল গুলো আসে, তাহলে $\beta$ প্যারামিটারটি ওয়েটের আকারের সাথে অপ্রয়োজন।
তাপমাত্রা নিয়ন্ত্রণ করে, আউটপুটের বিন্যাস কেমন হবে। $\beta$ যখন অনেক বড় হয়, তখন এটি শুন্য বা একের খুব কাছাকাছি হয়। $\beta$ ছোট হলে, এটি অনেক সফট হয়। $\beta$ এর লিমিট যখন শুন্যের সমান হয়, তখন এটি অনেকটা গড়ের মত হয়। $\beta$ যখন অসীম হয়, তখন এটি argmax এর মত আচরণ করে। এটি তখন আর সফট ভার্সনের মত আচরণ করেনা। তাই, softmax এর আগে যদি তোমার কোন নরমালাইজেশন থাকে, তাহলে প্যারামিটার টিউনিং তোমাকে হার্ডনেস নিয়ন্ত্রনে সহায়তা করে। অনেকসময়, তুমি চেকটি ছোট $\beta$ দিয়ে শুরু করতে পারো যাতে তুমি একটি ভালো গ্রেডিয়েন্ট ডিসেন্ট পাও, এবং তারপর চলমান অবস্থায় তুমি যদি তোমার এ্যাটেনশান ম্যাকানিজমে কঠিন সিদ্ধান্ত চাও তবে $\beta$ এর মান বাড়াতে পারো। এভাবে তুমি সিদ্ধাতগুলোকে তীক্ষ্ণ করতে পারো। এই কৌশলটিকে বলা হয় এ্যানেলিং। এটি সেলফ এ্যাটেনশান ম্য্যাকানিজম এর মত মিশ্র বিশেষজ্ঞের ক্ষেত্রে উপকারি হতে পারে।
লস ফাংশন্সমূহ
পাইটর্চে অনেক ফানশনই ইমপ্লিমেন্ট করা আছে। এখানে আমরা তাদের কয়েকটির মধ্য দিয়ে যাবো।
nn.MSELoss()
এই ফাংশনটি প্রত্যেক ইনপুট $x$ এবং $y$ এর মধ্যে গড় বর্গ ত্রুটি (mean squared error) দেয়। একে L2 লস ও বলা হয়।
আমরা যদি $n$ স্যাম্পলের জন্য মিনিব্যাচ ব্যবহার করি, তাহলে সেখানে মিনিব্যাচের প্রত্যেক স্যাম্পলের জন্য একটি করে, $n$ সংখ্যক লস থাকবে।। লস ফাংশনটি আমরা ভেক্টর হিসেবে রেখে দিতে অথবা একে হ্রাস করতে বলতে পারি।
যদি হ্রাস করা না হয় ( সেট reduction='none'), তাহলে লস
যেখানে $n$ হলো ব্যাচ সাইজ, এবং $x$ ও $y$ হলো আরবিটারি আকৃতির টেন্সর যার প্রত্যেকটির n সংখ্যক উপাদান আছে।
\[l(x,y) = \begin{cases}\text{mean}(L), \quad &\text{if reduction='mean'}\\ \text{sum}(L), \quad &\text{if reduction='sum'} \end{cases}\]যোগফল এখনো সব উপাদানের উপর ক্রিয়া করে এবং $n$ দ্বারা ভাগ করে।
reduction = 'sum' সেট করে $n$ দ্বারা ভাগ করাকে এড়ানো যেতে পারে।
nn.L1Loss()
এটী প্রত্যেক ইনপুটের $x$ এবং $y$(অথবা কাঙ্ক্ষিত আউটপুত ও আসল আউটপুট) এর মধ্যে গড় পরম ত্রুটি( mean absolute error-MAE) পরিমাপ করে।
যদি হ্রাস করা না হয় ( সেট reduction='none'), তাহলে লস
যেখানে $n$ হলো ব্যাচ সাইজ, এবং $x$ ও $y$ হলো আরবিটারি আকৃতির টেন্সর যার প্রত্যেকটির n সংখ্যক উপাদান আছে।
nn.MSELoss() এর মতই এটিরও 'mean' এবং 'sum', reduction অপশন আছে।
ব্যবহার ক্ষেত্রঃ Outliers এবং Noise এর বিরুদ্ধে L2 এর তুলনায় L1 অনেক বেশি বলিষ্ঠ। L2 তে noise/outlire পয়েন্ট গুলো স্কোয়ার্ড হয়ে যায়, যার কারনে outlire গুলোর প্রতি কস্ট ফাংসশনটি অনেক বেশী সেন্সিটিভ হয়ে থাকে।
সমস্যাঃ পাদদেশে (০) তে L1 লসটি ডিফারেনশিয়েবল নয়
nn.SmoothL1Loss()
যদি উপাদান-ভিত্তিক পরম ত্রুটি ১ এর চেয়ে কম হয় তাহলে এই ফাংশনটি L2 লস ব্যবহার করে, আর তা নাহলে L1 লস ব্যবহার করে।
\(\text{loss}(x, y) = \frac{1}{n} \sum_i z_i\) , where $z_i$ is given by
\[z_i = \begin{cases}0.5(x_i-y_i)^2, \quad &\text{if } |x_i - y_i| < 1\\ |x_i - y_i| - 0.5, \quad &\text{otherwise} \end{cases}\]এটিরও reduction অপশন আছে।
রস গ্রিশিক এটি এ্যাডভারটাইজ করেন (Fast R-CNN)। L1 লস যখন একটি অব্জেক্টিভ ফাংশন হিসেবে ব্যবহার করা হয় তখন এটিকে হুবার লস বা ইলাস্টিক লসও বলা হয়।
ব্যবহার ক্ষেত্রঃ এটি MSELoss এর তুলনায় outlier এর প্রতি কম সংবেসদনশীল এবং এটি পাদদেশে মসৃণ। এই ফাংশনটিকে প্রায়ই outlier থেকে সুরক্ষায়, কম্পিউটার ভিশনে ব্যবহার করা হয়।
কম্পিউটার ভিশনে L1 বনাম L2
প্রেডিকশনের সময় যখন আমাদের কাছে অনেকগুলো বিভিন্ন ধরনের $y$ তাছেঃ
- আমরা যদি MSE (L2 লস) ব্যবহার করি তাহলে এটি সকল $y$ এর গড় দেয়, CV তে যার মানে হলো আমরা একটি ঝাপসা ছবি পাবো।
- আমরা যদি L1 লস ব্যবহার করি, $y$ মানটি হলো মধ্যমা যা L1 দূরত্বকে হ্রাস করে, যা ঝাপসা নয়। কিন্তু একাধিক মাত্রায় মধ্যমা বের করা কঠিন।
প্রেডিকশনে L1 ব্যবহারে তীক্ষ্ণ ছবি পাওয়া যায়।
nn.NLLLoss()
যখন C ক্লাসে ক্লাসিফাই করার সমস্যাকে ট্রেইন করা হয়, তখন ঋণাত্মক লগ সাম্ভব্যতাকে ব্যবহার করা হয়।
মনে রাখবে, গাণিতিকভাবে NLLLoss এর ইনপুট (লগ) সাম্ভব্যতা হওয়া উচিত, কিন্তু পাইটর্চে সেটা বাধ্যতামূলক নয়। সুতরাং, কাঙ্ক্ষিত উপাদানটিকে যত সম্ভব বড়া করায় এর আসল প্রভাব।
লসকে হ্রাস ( উদাহরণ স্বরূপঃ attr:reduction এ 'none' সেট করা ) করে প্রকাশ করা যায়ঃ
,যেখানে $N$ হলো ব্যাচ সাইজ।
যদি reduction 'none' না হয় (ডিফল্ট 'mean'), তবে
এই ফাংশনের একটি অপশনাল আর্গুমেন্ট আছে weight, যা একটি এক মাত্রিক টেনশর ব্যবহার করে পাশ করা যায়, যা প্রত্যেক ক্লাসে ওয়েট এসাইন করে। ভারসাম্যহীণ ট্রেইনিং সেট এর সাথে কাজ করার সময় এটি দরকারি।
ওয়েট এবং ভারসাম্যহীন ক্লাসসমূহঃ
প্রত্যেক বিভাগ/ক্লাসের ফ্রিকোয়েন্সি আলাদা হলে ওয়েট ভেক্টর দরকারি। উদাহরণ স্বরূপ, ফুসফুস ক্যান্সারের তুলনায় সাধারণ ফ্লুর ফ্রিকোয়েন্সি অনেক বেশি। আমরা সহজেই যে বিভাগ গুলোর স্যাম্পল কম তাদের ওয়েট বাড়িয়ে দিতে পারি।
যাহোক, ওয়েট সেট না করে, ফ্রিকুয়েন্সি সমান করা উত্তম যাতে আমরা স্টকাসিট গ্রেডিয়েন্টগুলোকে আরো ভালো এক্সপ্লয়েট করতে পারি।
ট্রেনিংয়ের ক্লাস গুলোকে সমান করার জন্য, আমরা প্রত্যেক ক্লাসের স্যাম্পলকে বিভিন্ন বাফারে রাখতে পারি। তারপর প্রত্যেক বাফার থেকে সমান সংখ্যক স্যাম্পল নিয়ে প্রত্যেক মিনিব্যাচ তৈরি কর। যদি ছোট বাফারের সবগুলো স্যাম্পল শেষ হয়ে যায়, আমরা ছোট বাফারের আবার প্রথম থেকে স্যাম্পল নেব যতক্ষণ না পর্যন্ত বড় ক্লাসের সব স্যম্পল ব্যবহৃত হচ্ছে। এভাবে আমরা বৃত্তাকার বাফারের মাধ্যমে সব বিভাগের জন্য সমার ফ্রিকুয়েন্সি পেতে পারি। আমাদের কখনো বড় ক্লাসের সব স্যাম্পল ব্যবহার না করে সহজ পদ্ধতিতে ফ্রিকুয়েন্সি সমান করা উচিত নয়। ডাটা মেঝেতে ফেলে রেখো না!
উপরের পদ্ধতির একটি স্পষ্ট সমস্যা হচ্ছে আমাদের NN মডেল আসল স্যম্পলগুলোর আপেক্ষিক ফ্রিকুয়েন্সি জানতে পারবে না। এটির সমাধানের জন্য আমরা শেষের কয়েক এপক আসল ফ্রিকুয়েন্সিটে চালানোর মাধ্যমে সিস্টেমটিকে ফাইন-টিউন করে নিতে পারি, যাতে সিস্টমটি একপাক্ষিক আউটপুট লেয়ারের সাথে অভিযোজিত হয় এবং যেগুলো বেশি ফ্রিকুয়েন্ট তাদের অনুগ্রহ করে।
পদ্ধতিটি অনুধাবন করতে, মেডিকেল স্কুলের উদাহরণে ফিরে যাইঃ ছাত্ররা সাধারণ রোগে যে সময় ব্যয় করে একই সে একই সময় বিরল রোগ গুলোয় ব্যয় করে (অথবা আরো বেশি, কারন বিরল রোগগুলো বেশি জটিল হয়)। তারা এদের সকল বৈশিষ্ট্যের শিখে, তারপর কোনটি বিরল সে সম্পর্কে জানে।
nn.CrossEntropyLoss()
এই ফাংশনটি nn.LogSoftmax এবং nn.NLLLoss ফাংশন দুটিকে একটি ক্লাসে একত্র করে। এই দুটির মিশ্রণ সঠিক ক্লাসের স্কোরকে যততা সম্ভব বড় করে।
ফাংশন দুটিকে একত্র করার কারন হচ্ছে, গ্রেডিয়েন্ট গণনার সংখ্যাগত স্থিতিশীলতা। যখন সফট্ম্যাক্স এর পরবর্তী মান ১ বা ০ এর কাছাকাছি হয়, লগ এর মান তখন ০ বা $-\infty$। লগের ঢাল ০ এর কাছাকাছি যা $\infty$ এর কাছাকাছি, যা ব্যাকপ্রোপাগেশনের মধ্যবর্তী ধাপগুলো সংখ্যাগত সমস্যার সৃষ্টি করে। ফাংশন দুটিকে একত্র করার ফলে, গ্রেডিয়েন্ট গুলো পরিপূর্ণ হয় যার ফলে শেষে আমরা একটি যুক্তিসঙ্গত সংখ্যা পাই।
প্রত্যেক ক্লাসের জন্য কাঙ্ক্ষিত ইনপুট হলো আন-নরমালাইজড স্কোর।
লসটিকে এভাবে প্রকাশ করা যায়ঃ
\[\text{loss}(x, c) = -\log\left(\frac{\exp(x[c])}{\sum_j \exp(x[j])}\right) = -x[c] + \log\left(\sum_j \exp(x[j])\right)\]অথবা weight আর্গুমেন্টটি নির্দিষ্ট করে দেওয়া হলেঃ
লসগুলো প্রত্যেক মিনিব্যাচের জন্য পুরো পর্যবেক্ষণ জুড়ে গড় করা হয়।
ক্রস এনট্রপি লসের একটি ফিজিকাল ইন্টারপ্রিটেশন কালব্যাক-লেইবলার ডাইভারজেন্স (KL divergence) এর সাথে সম্পর্কিত, যেখানে আমরা দুটি বিন্যাসের মাঝে ডাইভার্জেন্স পরিমাপ করছি। এখানে (quasi) বিন্যাসগুলো x ভেক্টর(প্রেডিকশন গুলো) এবং লক্ষ্য বিন্যাস (একটি ওয়ান হট ভেক্টর যার ভুল ক্লাসগুলো ০ এবং সঠিক ক্লাসগুলো ১) দ্বারা উপস্থাপন করা হয়েছে
গাণিতিকভাবে,
\[H(p,q) = H(p) + \mathcal{D}_{KL} (p \mid\mid q)\]যেখানে \(H(p,q) = - \sum_i p(x_i) \log (q(x_i))\) হলো ক্রসএন্ট্রপি (দুটি বিন্যাসের মধ্যে) , \(H(p) = - \sum_i p(x_i) \log (p(x_i))\) হলো এন্ট্রপি, এবং \(\mathcal{D}_{KL} (p \mid\mid q) = \sum_i p(x_i) \log \frac{p(x_i)}{q(x_i)}\) হলো KL ডাইভারজেন্স।
nn.AdaptiveLogSoftmaxWithLoss()
অনেকগুলো ক্লাসের জন্য (যেমন, লক্ষাধিক ক্লাস) এটি সফট্ম্যাক্স এর একটি দক্ষ সফট্ম্যাক্স অনুমান। গণনার গতি বাড়ানোর জন্য এটি কিছু কৌশল বাস্তবায়ন করে।
এই পদ্ধতিটির খুঁটিনাটি Efficient softmax approximation for GPUs](https://arxiv.org/abs/1609.04309) এ এদয়ার্ড গ্রেভ, আরমান্ড জোউলিন, মোস্তফা সিজ, ডেভিড গ্রেঞ্জার, হার্ভে জাগো দ্বারা বর্ণনা করা হয়েছে।
📝 Haochen Wang, Eunkyung An, Ying Jin, Ningyuan Huang
Aditya Chakma
13 Apr 2020