Artificial neural networks (ANNs)
🎙️ Alfredo Canzianiশ্রেণিবিন্যাস (ক্লাসিফিকেশন) এর জন্য সুপারভাইজড লার্নিং
- নিচের চিত্র ১(ক) লক্ষ্য কর। এই গ্রাফের বিন্দুগুলো একটি স্পাইরাল (পেঁচানো আকৃতি) এর শাখায় অবস্থান করছে, এবং এগুলো $\R^2$ এর। প্রতিটি রং ই একেকটি শ্রেণী (ক্লাস) বুঝাচ্ছে। একক (ইউনিক) শ্রেণীর সংখ্যা এখানে $K = 3$। গাণিতিকভাবে সমীকরণ সমীকরণ ১(ক) তে এটি তুলে ধরা হয়েছে।
-
চিত্র ১(খ) তেও আরেকটি স্পাইরাল দেখানো হয়েছে, যেখানে গাউসিয়ান নয়েয (একরকম হ্রাসবৃদ্ধি/অস্থিরতা) অতিরিক্ত যুক্ত করা হয়েছে। এটির গাণিতিক রূপটি তোমরা সমীকরণ ১(খ) তে দেখতে পারো।.
উভয় ক্ষেত্রেই, চিত্রের বিন্দুগুলি লিনিয়ারলী সেপারেবল নয় (অর্থাৎ, রৈখিকভাবে পৃথক করা সম্ভব হয় না)।
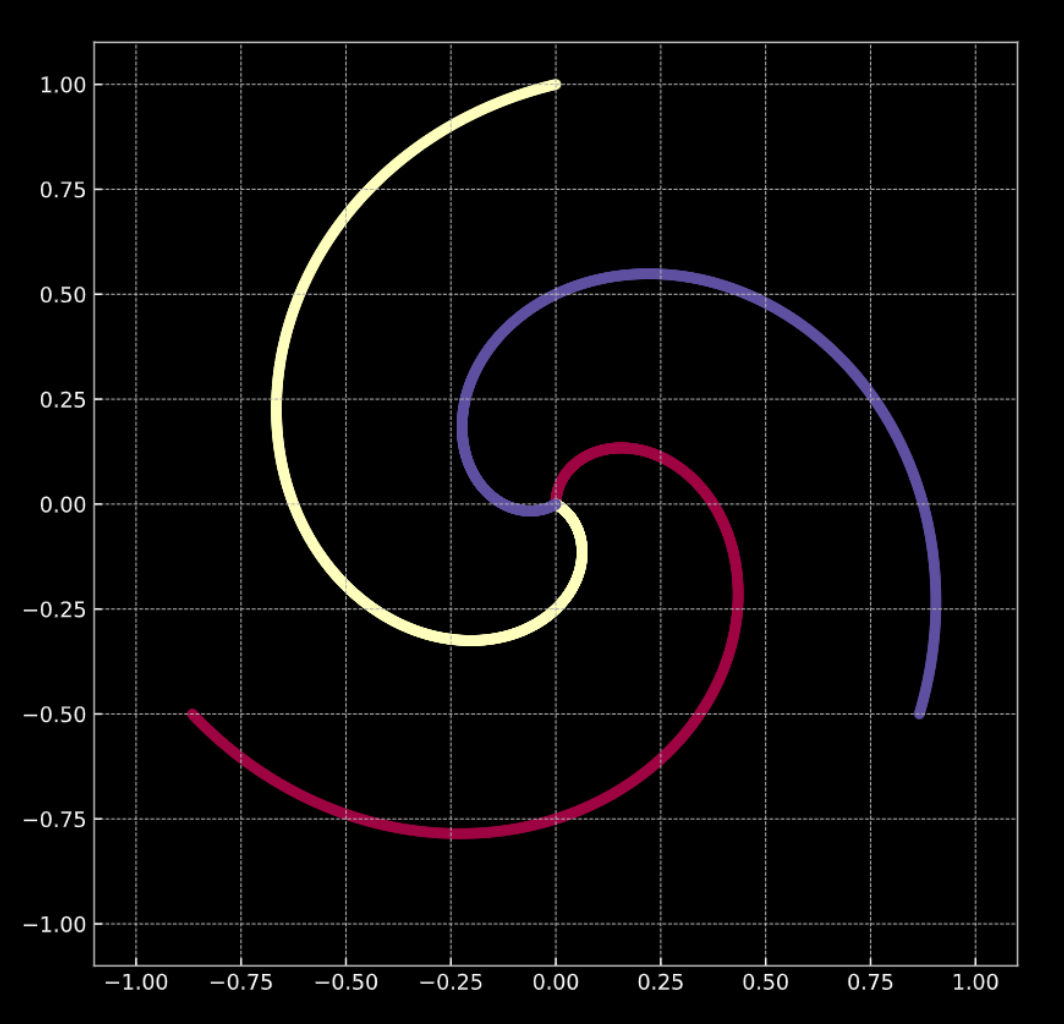
চিত্র ১(ক) "সুগঠিত" 2D (দ্বিমাত্রিক) স্পাইরাল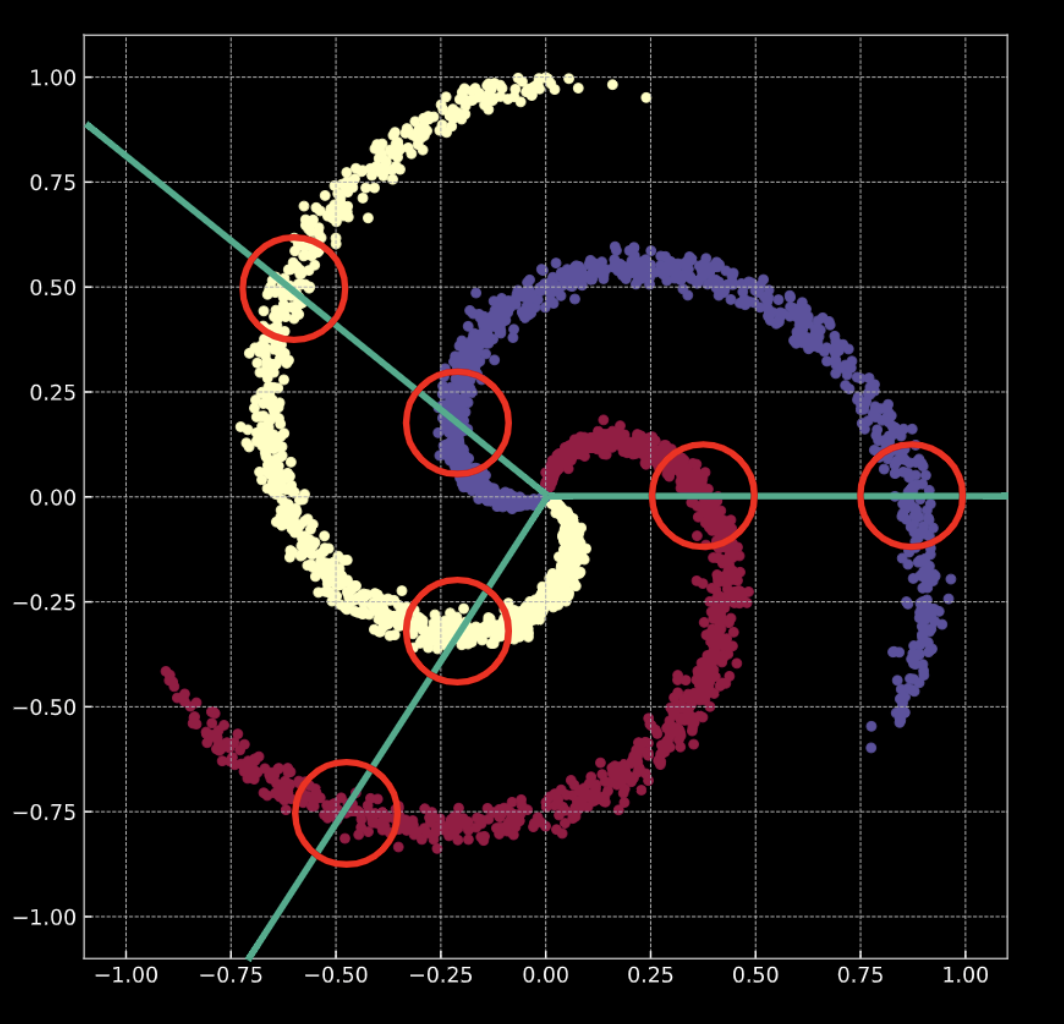
Fig. 1(b) "নয়েয সম্পন্ন" 2D (দ্বিমাত্রিক) স্পাইরাল
শ্রেণিবিন্যাস (ক্লাসিফিকেশন) সম্পাদন করার অর্থ কী? লজিস্টিক রিগ্রেসশনের এর ক্ষেত্রে যদি লক্ষ্য কর, এই ডাটা (স্পাইরাল) এর উপর যদি লজিস্টিক রিগ্রেশন ব্যবহার করা হয় ক্লাসিফিকেশন এর জন্য, সেক্ষেত্রে ডাটাগুলোকে তাদের নির্দিষ্ট শ্রেণীতে (ক্লাসে) বিন্যস্ত/আলাদা করতে এটি কিছু লিনিয়ার প্লেইন (ডিসিশন বাউন্ডারি) তৈরী করবে। কিন্তু এই সমাধানে সমস্যাটি হচ্ছে, এখানে প্রতিটি অংশেই একাধিক ক্লাসের পয়েন্ট (বিন্দু) অবস্থান করে। অর্থাৎ, স্পাইরালটির শাখাগুলি লিনিয়ার ডিসিশন বাউন্ডারিগুলোকে ছেদ করে। কাজেই, এটি ভালো কোনো সমাধান নয়।
এটা আমরা কিভাবে ঠিক করতে পারি? আমরা ইনপুট স্পেসকে এমনভাবে ট্রান্সফর্ম (রূপান্তর) করবো যাতে করে ডাটাগুলো লিনিয়ারলি সেপারেবল হওয়ায় বাধ্য হয়। এটি করার জন্য, ট্রেনিং এর সময় নিউরাল নেটয়ার্কটির ডিসিশন বাউন্ডারি (যা এটি শিখে) পর্যায়ক্রমে ট্রেনিং ডাটার ডিস্ট্রিবিউশনের (বিন্যাসের) সাথে মানিয়ে নেয়ার চেষ্টা করতে থাকে।
লক্ষ্য করো: একটি নিউরাল নেটওয়ার্ক সবসময় বটম আপ (নিচ থেকে উপরে) এভাবে তুলে ধরা হয়। প্রথম লেয়ারটি একেবারে নিচে এবং সর্বশেষ লেয়ারটি সবার উপরে অবস্থান করে। এর কারণ ধারণাগতভাবে, ইনপুট ডাটাগুলো হচ্ছে নিম্ন মানের ফিচার (বৈশিষ্ট) যা নিউরাল নেটওয়ার্কটি শেখার চেষ্টা করে। ডাটাগুলো নেটওয়ার্কের মধ্য দিয়ে যত উপরের দিকে পার হতে থাকে, একই সাথে প্রতিটি লেয়ার সেখান থেকে আরও উচ্চ মানের ফিচার বের করে নেয়।
ট্রেনিং ডাটা
গত সপ্তাহে আমরা দেখেছিলাম, প্রাথমিকভাবে যখন নিউরাল নেটওয়ার্কটি তৈরী করা হয়, সেটি ইনপুটটিকে একপ্রকার ইচ্ছামতো/এলোমেলো উপায়ে ট্রান্সফর্ম করে। যদিও এই ট্রান্সফরমেশনটি প্রথম প্রথম আমরা এটাকে যা করবে বলে আশা করি (প্রতিটি ক্লাসের ডাটাকে আলাদা করা) সেরকম কিছু করেনা, তবে আমরা এই ট্রান্সফরমেশনটিকে বাধ্য করতে পারি যাতে করে এটি অর্থবহ কিছু করে যেটি আমাদের উদ্দেশ্যকে সফল করবে। একটি নেটওয়ার্কের ট্রেনিং ডাটা হিসেবে নিম্নলিখিত ডাটা ব্যবহৃত হয়।
- $\vect{X}$ দ্বারা ইনপুট ডাটা বুঝানো হয়েছে, যা একটি $m$ (ট্রেনিং ডাটার সংখ্যা) x $n$ ডাইমেনশন (আকৃতির) ম্যাট্রিক্স। চিত্র ১(ক) এবং চিত্র ১(খ) এর ডাটাগুলোর ক্ষেত্রে $n = 2$।
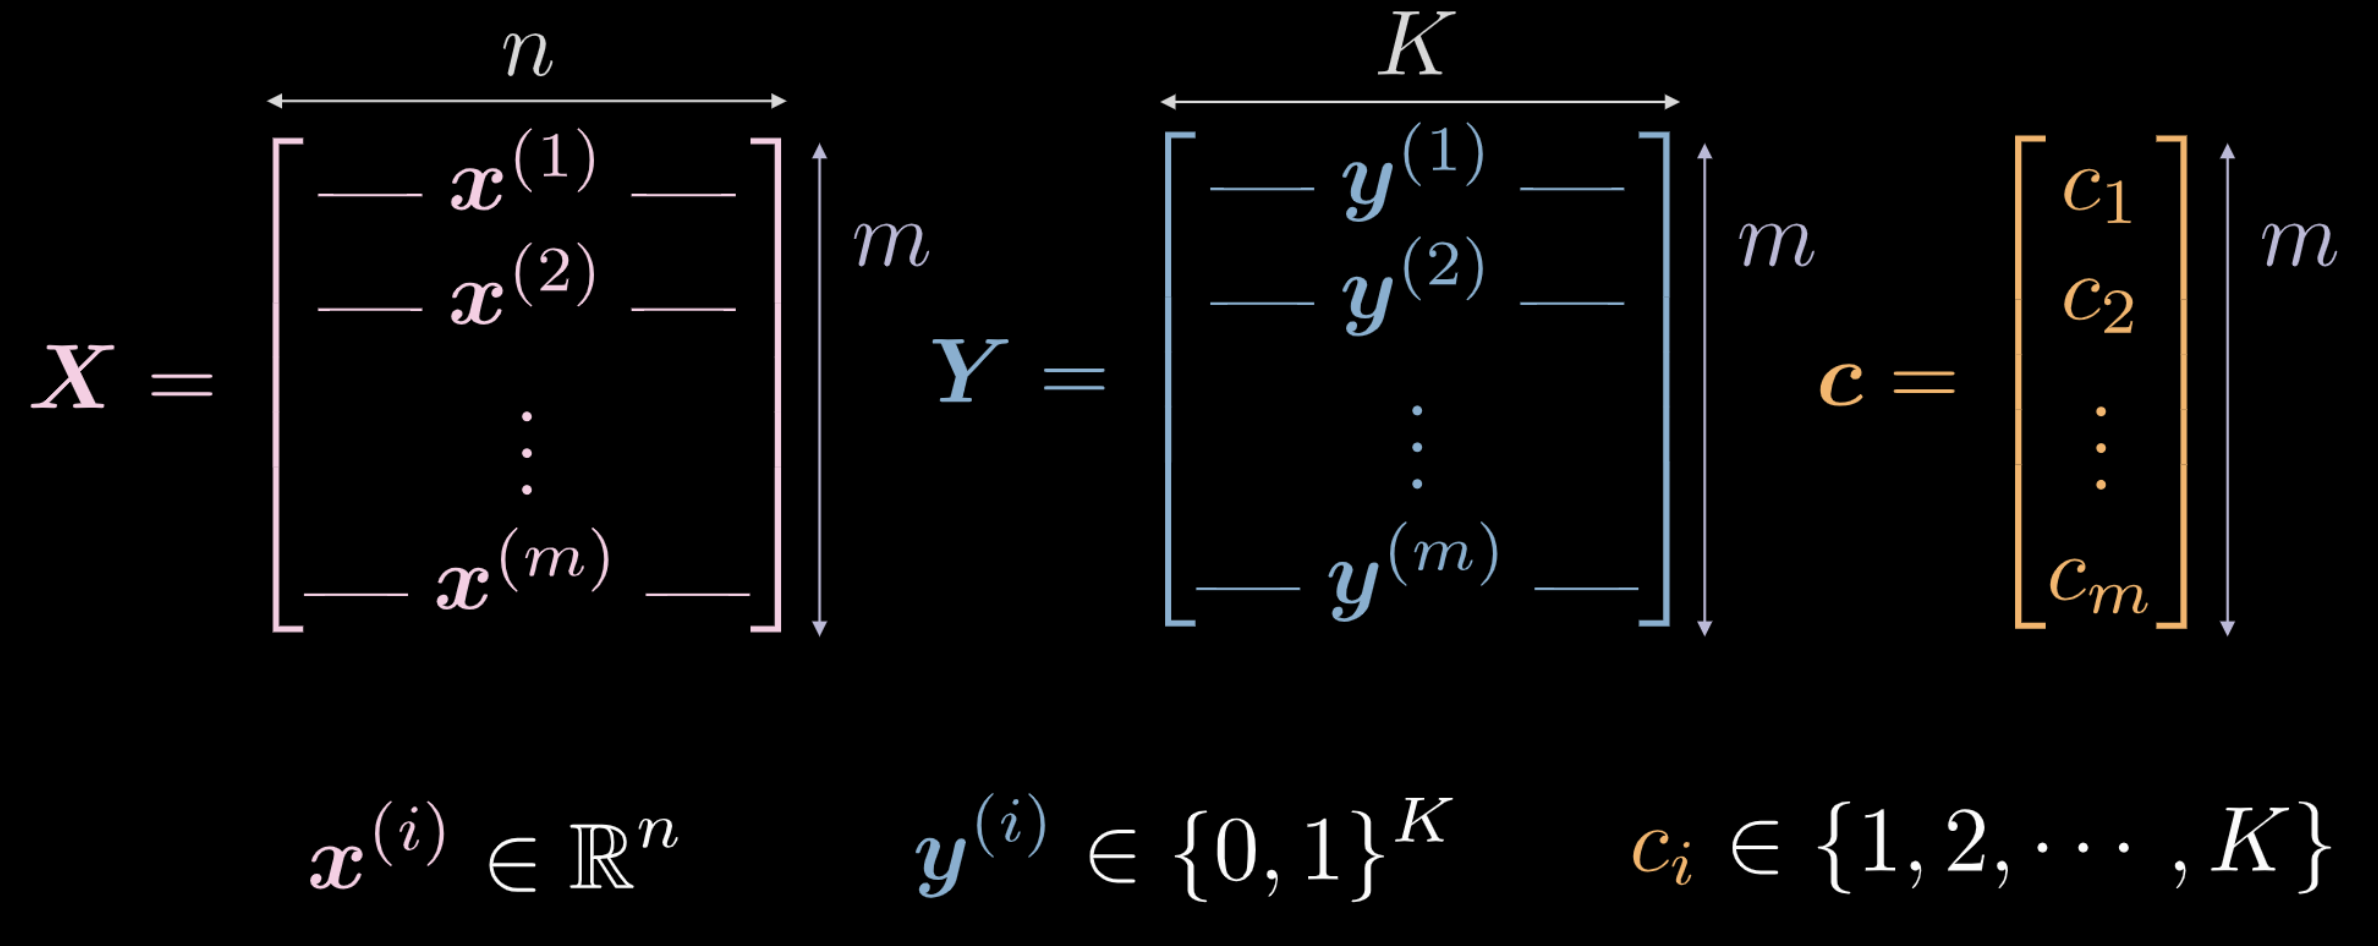
চিত্র ২ ট্রেনিং ডাটা
-
ভেক্টর $\vect{c}$ এবং ম্যাট্রিক্স $\boldsymbol{Y}$ উভয়ই $m$ টি ক্লাসের লেবেল প্রকাশ করে। উপরে উল্লেখিত উদাহরণটিতে $3$ টি পৃথক ক্লাস রয়েছে।
- $c_i \in \lbrace 1, 2, \cdots, K \rbrace$, এবং $\vect{c} \in \R^m$. তবে আমরা $\vect{c}$ কে ট্রেনিং ডাটা হিসেবে নাও ব্যবহার করতে পারি। আমরা যদি সংখ্যাসূচক আলাদা আলাদা ক্লাস লেবেল ব্যবহার করি $c_i \in \lbrace 1, 2, \cdots, K \rbrace$, সেটিকে নেটওয়ার্কটি ক্লাসগুলোর মধ্যে একপ্রকার অর্ডার (ক্রম) ধরে নিতে পারে যা আসলে ডাটা ডিস্ট্রিবিউশনের অংশ নয়।
- এই সমস্যাটিকে দূর করার জন্য আমরা একটি ওয়ান-হট এনকোডিং ব্যবহার করি। এখানে আমরা প্রতিটি লেবেল $c_i$ এর জন্য, একটি $K$ ডাইমেনশনাল জিরো-ভেক্টর $\vect{y}^{(i)}$ তৈরী করি, যেখানে শুধু $c_i$-তম অংশটিতে $1$ বসানো হয়। (নিচের চিত্র ৩ টি দেখো)।
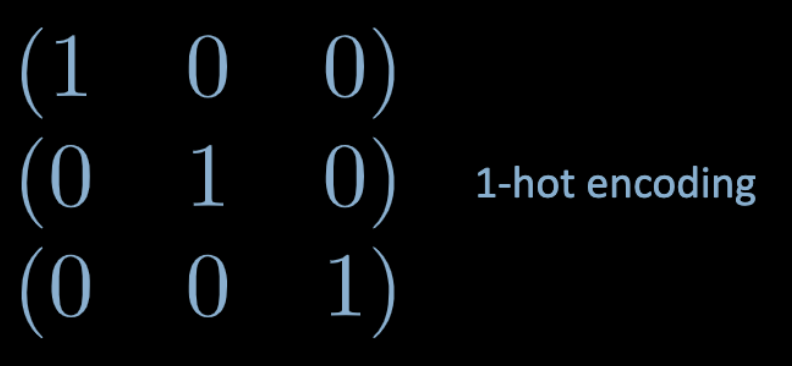
চিত্র ৩ ওয়ান-হট এনকোডিং
- অতএব, $\boldsymbol Y \in \R^{m \times K}$. এই ম্যাট্রিক্স টিকেও একটি প্রোবাবিলিস্টিক মাস্ হিসেবে চিন্তা করতে পারো, যার পুরো মান $K$ টি জায়গার মধ্যে শুধু একটিতেই ঘনীভূত
ফুল্লি কানেক্টেড (FC) লেয়ার্স
আমরা এখন দেখবো একটি ফুল্লি কানেক্টেড (FC) নেটওয়ার্ক কি এবং এটি কিভাবে কাজ করে।
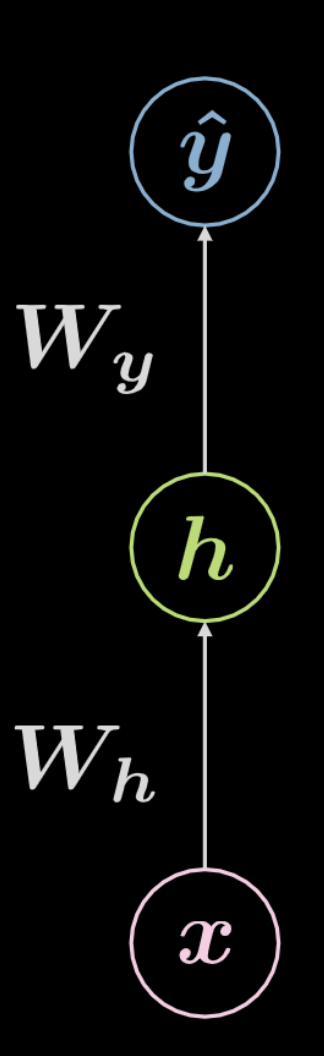
চিত্র ৪ ফুল্লি কানেক্টেড নিউরাল নেটওয়ার্ক
উপরের চিত্র ৪ এ দেখানো নেটওয়ার্কটি লক্ষ্য কর। ইনপুট ডাটা $\boldsymbol x$ কে একটি এফাইন ট্রান্সফরমেশন এবং এর পর একটি নন-লিনিয়ার ট্রান্সফরমেশনের মধ্য দিয়ে নেয়া হয়। এই নন-লিনিয়ার ট্রান্সফর্মেশনের ফলাফল $\boldsymbol h$ দ্বারা প্রকাশ করা হয়েছে, যা এখানে একটি হিডেন আউটপুট বুঝাচ্ছে, অর্থাৎ, যা নেটওয়ার্কের বাইরে থেকে দেখা যায়না। এরপর এই অউটপুটটিকে আরেকটি এফাইন ট্রান্সফরমেশন এবং আরেকটি নন-লিনিয়ার ট্রান্সফরমেশনের মধ্য দিয়ে নেয়া হয়। এটিই আমাদের সর্বশেষ আউটপুট $\boldsymbol{\hat{y}}$ তৈরী করে। এই নেটওয়ার্কটিকে আমরা নিচের সমীকরণ ২ দ্বারা গাণিতিকভাবে প্রকাশ করতে পারি। $f$ এবং $g$ উভয় দ্বারাই নন-লিনিয়ারিটি বুঝানো হয়েছে।
\[\begin{aligned} &\boldsymbol h=f\left(\boldsymbol{W}_{h} \boldsymbol x+ \boldsymbol b_{h}\right)\\ &\boldsymbol{\hat{y}}=g\left(\boldsymbol{W}_{y} \boldsymbol h+ \boldsymbol b_{y}\right) \end{aligned}\]উপরে যেমনটি দেখানো হয়েছে এরূপ সাধারণ একটি নিউরাল নেটওয়ার্ক কেবলই মাত্র সাক্সেসিভ পেয়ার্স (ধারাবাহিক যুগলের/জোড়ার) সমষ্টি, যার প্রতিটি পেয়ার এ (জোড়ায়) থাকে একটি এফাইন ট্রান্সফরমেশন এবং একটি নন-লিনিয়ার অপারেশন (স্কোয়াশিং)। নন-লিনিয়ার ফাংশন হিসেবে বেশিরভাগ ব্যবহৃত ফাংশনগুলো হচ্ছে রেলু (ReLU), সিগময়ড (sigmoid), হাইপারবোলিক টেনজেন্ট (hyperbolic tangent) এবং সফটম্যাক্স (softmax)।
উপরে উল্লেখিত নেটওয়ার্কটি হচ্ছে একটি ৩-লেয়ার বিশিষ্ট নেটওয়ার্ক”
<!– 1. input neuron
- hidden neuron
- output neuron –>
- ইনপুট নিউরন
- হিডেন নিউরন
- আউটপুট নিউরন
অতএব, একটি $৩$-লেয়ার বিশিষ্ট নেটওয়ার্কের মধ্যে $২$ টি এফাইন ট্রান্সফরমেশন সংগঠিত হয়। এই ধারণাটি একটি $n$-লেয়ার বিশিষ্ট নেটওয়ার্কের ক্ষেত্রেও ভাবা যেতে পারে।
চল আরেকটু জটিল অবস্থায় যাওয়া যাক।
৩ টি হিডেন লেয়ারের জন্য ভেবে দেখো, যার প্রতিটি লেয়ারই ফুল্লি কানেক্টেড। চিত্র ৫ এ এটি ছবি আকারে প্রকাশ করা হয়েছে।
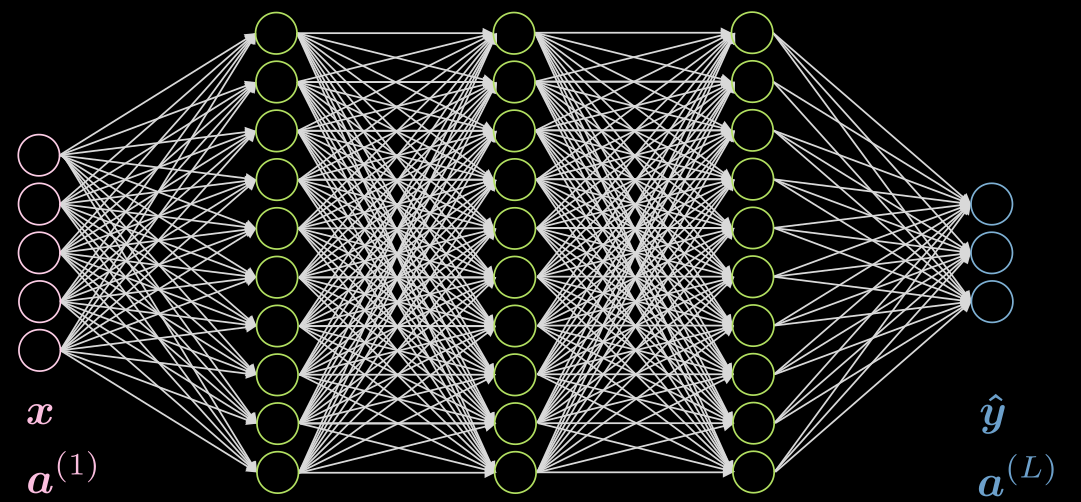
চিত্র ৫ ৩ টি হিডেন লেয়ার বিশিষ্ট নিউরাল নেট
২য় লেয়ারের $j$ নিউরনের কথা ধরে নেয়া যাক। এর এক্টিভেশন হচ্ছে:
\[a^{(2)}_j = f(\boldsymbol w^{(j)} \boldsymbol x + b_j) = f\Big( \big(\sum_{i=1}^n w_i^{(j)} x_i\big) +b_j ) \Big)\]যেখানে $\vect{w}^{(j)}$ হচ্ছে $\vect{W}^{(1)}$ এর $j$-তম সারি (row)
খেয়াল কর, এখানে ইনপুট লেয়ারের এক্টিভেশন হচ্ছে আইডেন্টিটি। অপরদিকে, হিডেন লেয়ারগুলোতে রেলু (ReLU), সিগময়ড (sigmoid), হাইপারবোলিক টেনজেন্ট (hyperbolic tangent) এবং সফটম্যাক্স (softmax) এর মতো ইত্যাদি এক্টিভেশন থাকতে পারে।
শেষ লেয়ারের এক্টিভেশন সাধারণত তোমার নির্দিষ্ট ব্যবহার এর উপর নির্ভর করে, যেমনটি এই পিয়াজ্জা পোস্টে বোঝানো হয়েছে।
নিউরাল নেটওয়ার্ক (ইনফারেন্স)
আরেকবার তিনটি লেয়ার (ইনপুট, হিডেন, আউটপুট) বিশিষ্ট নিউরাল নেটওয়ার্কের কথা চিন্তা করা যাক, চিত্র ৬ এ যেভাবে দেখানো হয়েছে।
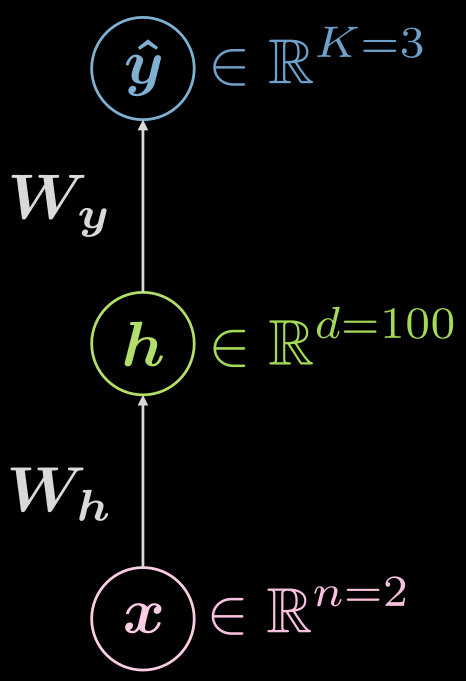
চিত্র ৬ তিনটি লেয়ার বিশিষ্ট নিউরাল নেটওয়ার্ক
এই নেটওয়ার্কের ফাংশনরূপ দেখতে কেমন?
\[\boldsymbol {\hat{y}} = \boldsymbol{\hat{y}(x)}, \boldsymbol{\hat{y}}: \mathbb{R}^n \rightarrow \mathbb{R}^K, \boldsymbol{x} \mapsto \boldsymbol{\hat{y}}\]তবে, এখানে যে একটি হিডেন লেয়ার রয়েছে এটি ভিজুয়ালাইজ করলে আমাদের সুবিধা হবে, এবং এর ম্যাপিং টিকে এভাবে প্রকাশ করা যেতে পারে:
\[\boldsymbol{\hat{y}}: \mathbb{R}^{n} \rightarrow \mathbb{R}^d \rightarrow \mathbb{R}^K, d \gg n, K\]উপরিউক্ত পরিস্থিতির জন্য একটি উদাহরণ কেমন হতে পারে? এই ক্ষেত্রে, ইনপুট ডাইমেনশন হবে দুই ($n=2$), একটি হিডেন লেয়ার রয়েছে সেটির ডাইমেনশন ১000 ($d = 1000$), এবং ৩টি ক্লাস রয়েছে ($C=3$)। একটি হিডেন লেয়ারে অনেক বেশি নিউরন না রাখার কিছু ভালো ব্যবহারিক কারণ রয়েছে, তাই আমরা এই একটি হিডেন লেয়ারকে ১0 নিউরন বিশিষ্ট ৩টি হিডেন লেয়ারে রূপান্তর করতে পারি ($1000 \rightarrow 10 \times 10 \times 10$)।
নিউরাল নেটওয়ার্ক (ট্রেনিং ১)
সাধরণত ট্রেনিং এর ধাপটি কেমন? এটাকে বোধগম্য হওয়ার জন্য আমরা লস এর পরিভাষায় বুঝার চেষ্টা করতে পারি।
প্রথমে, চলো সফ্ট (আর্গ) ম্যাক্স এর সাথে আমরা পুনরায় পরিচিত হই এবং সাধারণভাবে এটিই শেষ লেয়ারের এক্টিভেশন থাকে, যখন নেগেটিভ লগ-লাইকলিহুড লস হিসেবে ব্যবহার করি, দুই এর অধিক ক্লাস প্রেডিকশনের ক্ষেত্রে। যেমনটি প্রফেসর লেকুন (LeCun) তার লেকচারে বলেছেন, এটি ব্যবহারের কারণ হচ্ছে এভাবে আমরা সিগময়েড এবং স্কয়ার লসের থেকে আরো ভালো গ্রেডিয়েন্ট পেতে পারি, একইসাথে আমাদের শেষ লায়েরটিও নর্মালাইজ্ড হয়ে যাবে (অর্থাৎ, শেষ লেয়ারের সকল নিউরনের যোগফল ১ হয়), আলাদা করে নর্ম দিয়ে ভাগ করে শেষ লেয়ারটিকে নর্মালাইজ করার থেকে এটি গ্রেডিয়েন্ট মেথডগুলোর জন্য আরো ভালো।
সফ্ট (আর্গ) ম্যাক্স তোমাকে শেষ লেয়ারে যেই লজিট্সগুলো দিবে সেটি দেখতে অনেকটা এরকম:
\[\text{soft{(arg)}max}(\boldsymbol{l})[c] = \frac{ \exp(\boldsymbol{l}[c])} {\sum^K_{k=1} \exp(\boldsymbol{l}[k])} \in (0, 1)\]এখানে গুরুত্বপূর্ণ উল্লেখিত বিষয়টি হচ্ছে এক্সপোনেন্সিয়াল ফাংশনের কঠোর ধনাত্মক (পজিটিভ) প্রকৃতির কারণে সেটটি ক্লোস্ড নয়।
$\matr{\hat{Y}}$ সেট প্রেডিকশনের জন্য, লস হবে:
\[\mathcal{L}(\boldsymbol{\hat{Y}}, \boldsymbol{c}) = \frac{1}{m} \sum_{i=1}^m \ell(\boldsymbol{\hat{y}_i}, c_i), \quad \ell(\boldsymbol{\hat{y}}, c) = -\log(\boldsymbol{\hat{y}}[c])\]এখানে $c$ দ্বারা ওয়ান-হট এনকোডিং নয় বরং ইন্টিজার লেবেল বুঝানো হয়েছে
তাহলে, চলো দুটো উদাহরণ দেখে নেয়া যাক, যেখানে একটিতে ডাটা লেবেল সঠিকভাবে ক্লাসিফাই করা হয়েছে এবং আরেকটিতে সঠিকভাবে ক্লাসিফাই করা হয়নি।
ধরে নেয়া যাক
\[\boldsymbol{x}, c = 1 \Rightarrow \boldsymbol{y} = {\footnotesize\begin{pmatrix} 1 \\ 0 \\ 0 \end{pmatrix}}\]একেকটি ইনস্ট্যান্স এর জন্য লস?
কাছাকাছি নির্ভুল প্রেডিকশন এর জন্য ($\sim$ দিয়ে প্রায় বুঝানো হয়েছে):
\[\hat{\boldsymbol{y}}(\boldsymbol{x}) = {\footnotesize\begin{pmatrix} \sim 1 \\ \sim 0 \\ \sim 0 \end{pmatrix}} \Rightarrow \ell \left( {\footnotesize\begin{pmatrix} \sim 1 \\ \sim 0 \\ \sim 0 \end{pmatrix}} , 1\right) \rightarrow 0^{+}\]কাছাকাছি সম্পূর্ণ ভুল প্রেডিকশন এর জন্য:
\[\hat{\boldsymbol{y}}(\boldsymbol{x}) = {\footnotesize\begin{pmatrix} \sim 0 \\ \sim 1 \\ \sim 0 \end{pmatrix}} \Rightarrow \ell \left( {\footnotesize\begin{pmatrix} \sim 0 \\ \sim 1 \\ \sim 0 \end{pmatrix}} , 1\right) \rightarrow +\infty\]খেয়াল কর, উপরের উদাহরণটিতে $\sim 0 \rightarrow 0^{+}$ এবং $\sim 1 \rightarrow 1^{-}$। এরকমটি কেন হয়েছে? এক মিনিট ভেবে দেখ।
মনে রেখো: এটি জানা গুরুত্বপূর্ণ যে তুমি যদি CrossEntropyLoss ব্যবহার করো, তাহলে তুমি LogSoftMax এবং নেগেটিভ লগ লাইকলিহুড NLLLoss উভয়ই একসাথে পাবে, তাই এটি দুইবার করতে যেওনা!
নিউরাল নেটওয়ার্ক (ট্রেনিং ২)
ট্রেনিং এর জন্য, আমরা সকল ট্রেইনেবল প্যারামিটারগুলোকে – ওয়েট ম্যাট্রিস এবং বায়াসগুলো – একটি সমষ্টি আকারে একত্রিত করি, যেটিকে আমরা বলতে পারি $\mathbf{\Theta} = \lbrace\boldsymbol{W_h, b_h, W_y, b_y} \rbrace$ এখন অবজেক্টিভ ফাংশনটিকে আমরা এভাবে লিখতে পারি:
\[J \left( \mathbf{\Theta} \right) = \mathcal{L} \left( \boldsymbol{\hat{Y}} \left( \mathbf{\Theta} \right), \boldsymbol c \right) \in \mathbb{R}^{+}\]এটি আমাদের নেটওয়ার্কের লসকে আউটপুটের উপর ডিপেন্ডেন্ট করে তোলে $\boldsymbol {\hat{Y}} \left( \mathbf{\Theta} \right)$, তাই আমরা এখন এটিকে একটি অপটিমাইজেশন প্রব্লেমে রূপান্তর করতে পারি।
এটি কিভাবে কাজ করে তার একটি সংক্ষিপ্ত রূপ চিত্র ৭ এ তুলে ধরা হয়েছে, যেখানে $J(\vartheta)$ হচ্ছে ঐ ফাংশন যা আমরা মিনিমাইজ (হ্রাস) করবো এবং এর কেবল একটি স্কেলার প্যারামিটার $\vartheta$ রয়েছে।
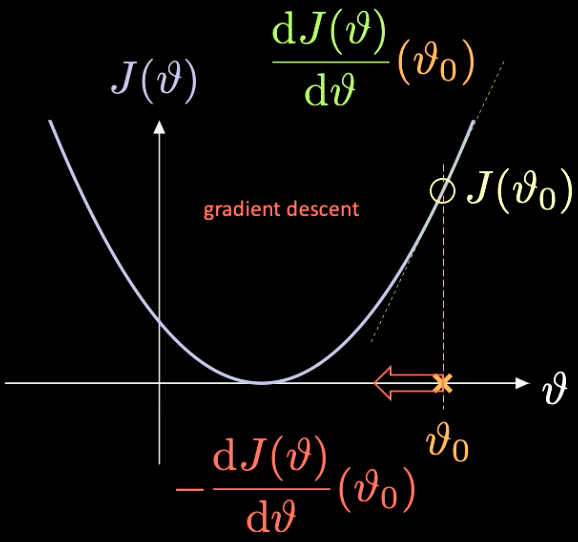
চিত্র ৭ গ্রেডিয়েন্ট ডিসেন্ট দিয়ে একটি লস ফাংশন অপ্টিমাইজ করা
প্রথমে আমরা একটি রেন্ডম ইনিশিয়ালাইজেশন পয়েন্ট ধরবো $\vartheta_0$ – ঐ পয়েন্টের লস হচ্ছে $J(\vartheta_0)$। এখন, ঐ পয়েন্টের আমরা ডেরিভেটিভ বের করতে পারি $J’(\vartheta_0) = \frac{\text{d} J(\vartheta)}{\text{d} \vartheta} (\vartheta_0)$। এক্ষেত্রে, ডেরিভেটিভটির স্লোপ (ঢাল) পজিটিভ। তাই আমাদেরকে স্টিপেস্ট ডিসেন্ট (সর্বোচ্চ নিম্নগামী) পথের দিকে এগোতে হবে। এক্ষেত্রে সেটি হচ্ছে $-\frac{\text{d} J(\vartheta)}{\text{d} \vartheta}(\vartheta_0)$
এই প্রক্রিয়াটির পর্যায়ক্রমিক পুনরাবৃত্তিই গ্রেডিয়েন্ট ডিসেন্ট নামে পরিচিত। গ্রেডিয়েন্ট মেথডগুলোই নিউরাল নেটওয়ার্ক ট্রেন করার প্রাথমিক টুল
প্রয়োজনীয় গ্রেডিয়েন্টগুলো বের করার জন্য আমাদেরকে ব্যাকপ্রোপাগেশন ব্যবহার করতে হবে।
\[\frac{\partial \, J(\mathbf{\Theta})}{\partial \, \boldsymbol{W_y}} = \frac{\partial \, J(\mathbf{\Theta})}{\partial \, \boldsymbol{\hat{y}}} \; \frac{\partial \, \boldsymbol{\hat{y}}}{\partial \, \boldsymbol{W_y}} \quad \quad \quad \frac{\partial \, J(\mathbf{\Theta})}{\partial \, \boldsymbol{W_h}} = \frac{\partial \, J(\mathbf{\Theta})}{\partial \, \boldsymbol{\hat{y}}} \; \frac{\partial \, \boldsymbol{\hat{y}}}{\partial \, \boldsymbol h} \;\frac{\partial \, \boldsymbol h}{\partial \, \boldsymbol{W_h}}\]স্পাইরাল ক্লাসিফিকেশন - জুপিটার নোটবুক
জুপিটার নোটবুকটি এখানে পেয়ে যাবে। নোটবুকটি রান করতে হলে, নিশ্চিত করবে যাতে the dl-minicourse এনভায়রনমেন্টটি ইনস্টল করা থাকে যেমনটি README.md তে বলা হয়েছে।
torch.device() কিভাবে ব্যবহার করতে হবে তার একটি ব্যাখ্যা গত সপ্তাহের নোট এ পাওয়া যাবে।
আগের মতোই, আমরা $\mathbb{R}^2$ এর পয়েন্টগুলো নিয়ে কাজ করবো যেখানে তিনটি ভিন্ন লেবেল – লাল, হলুদ, নীল – রয়েছে, যেমনটি চিত্র ৮ এ তোমরা দেখতে পারো।
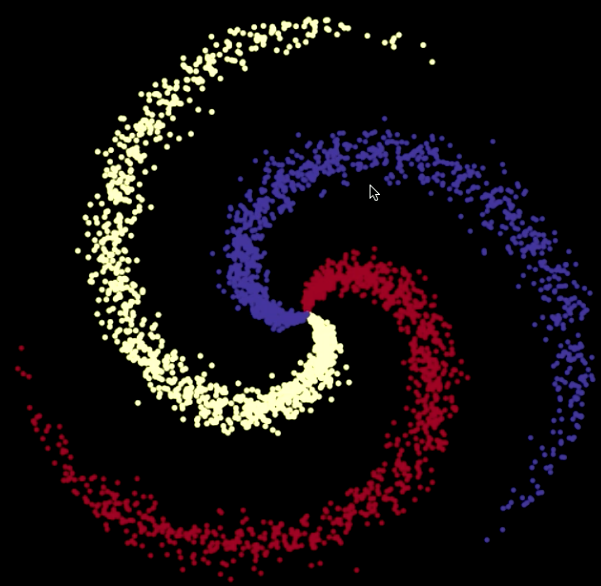
চিত্র ৮ স্পাইরাল ক্লাসিফিকেশনের ডাটা
nn.Sequential() টি হচ্ছে একটি ধারক, যেটি মডিউলগুলোকে যেই ক্রমে যোগ করা হয়েছে সেই একই ক্রমে কন্সট্রাক্টরে পাঠায়; nn.linear() নামটি বলা যায় একটু বিভ্রান্তিকর কেননা এটি এখানে পাঠানো ডাটাকে এফাইন ট্রান্সফরমেশনের মধ্য দিয়ে নেয়: $\boldsymbol y = \boldsymbol W \boldsymbol x + \boldsymbol b$। আরও জানতে, পাইটর্চ ডকুমেন্টেশন দেখতে পারো।
মনে রাখবে, একটি এফাইন ট্রান্সফরমেশনের মাধ্যমে ৫টি রূপান্তর সম্ভব: রোটেশন, রিফ্লেকশন, ট্রান্সলেশন, স্কেলিং, শিয়ারিং।
যেমনটি চিত্র ৯ এ দেখা যাচ্ছে, যখন স্পাইরাল ডাটাকে লিনিয়ার ডিসিশন বাউন্ডারির মাধ্যমে আলাদা করার চেষ্টা হয় - মাঝখানে কোনো নন-লিনিয়ারিটি না রেখে শুধুমাত্র nn.linear() মডিউল ব্যবহার করে - সর্বোচ্চ আমরা যেটি পেতে পারি সেটি হচ্ছে $৫0\%$ একুরেসি এর বেশি নয়।
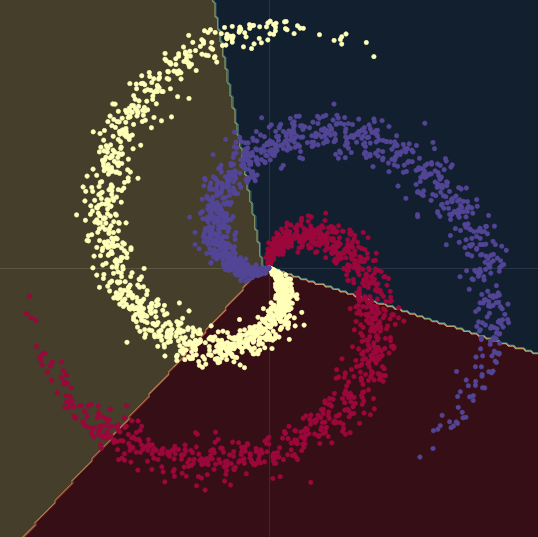
চিত্র ৯ লিনিয়ার ডিসিশন বাউন্ডারিগুলো
যখন আমরা এই একটি লিনিয়ার মডেল থেকে সরে এসে দুইটি nn.linear() মডিউল এবং মাঝখানে একটি nn.ReLU() সম্পন্ন মডেল ব্যবহার করি, একুরেসি $৯৫\%$ পর্যন্ত অর্জন করা যায়। এর কারণ হচ্ছে আমাদের ডিসিশন বাউন্ডারি তখন নন-লিনিয়ার হয়ে যায় যা স্পাইরাল আকৃতির ডাটা এর জন্য অনেক উপযোগী, যেমনটি চিত্র ১0 এ দেখা যাচ্ছে।
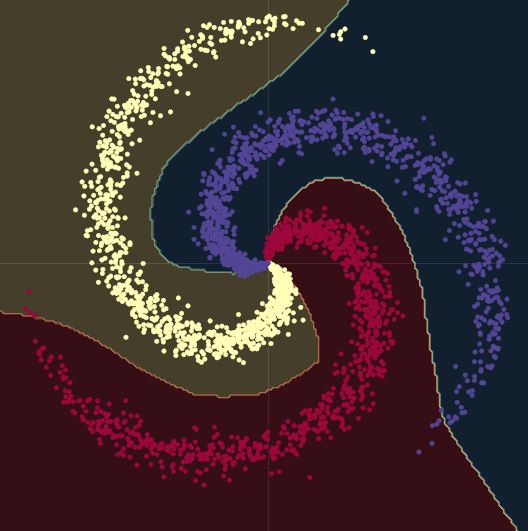
চিত্র ১0 নন-লিনিয়ার ডিসিশন বাউন্ডারিগুলো
একটি রিগ্রেশন প্রব্লেম যেটি লিনিয়ার রিগ্রেশন ব্যবহার করে সঠিকভাবে সমাধান করা সম্ভব হয়না, তবে নিউরাল নেটওয়ার্ক ব্যবহার করে সহজেই সমাধান করে ফেলা যায়, এর একটি উদাহরণ তোমরা এই নোটবুকটিতে পাবে এবং চিত্র ১১ তে, ১০টি ভিন্ন নেটওয়ার্ক তুলে ধরা হয়েছে, যার মধ্যে ৫ টিতে রয়েছে একটি করে nn.ReLU() ফাংশন এবং অপর ৫ টিতে একটি করে nn.Tanh()। এখানে প্রথমটি হচ্ছে একটি পিসওয়াইস লিনিয়ার ফাংশন এবং পরেরটি হচ্ছে একটি কন্টিনিউয়াস ও স্মুথ (মসৃণ) রিগ্রেশন।
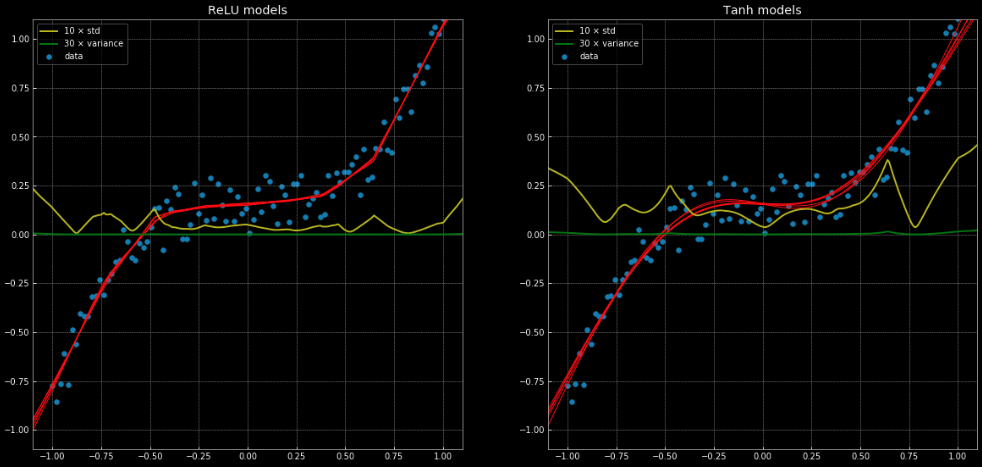
চিত্র ১১: ১০টি নিউরাল নেটওয়ার্কস, সাথে সেগুলোর ভ্যারিয়েন্স এবং স্ট্যান্ডার্ড ডেভিয়েশন
বামে: ৫টি
ReLU নেটওয়ার্কস। ডানে: ৫টি tanh নেটওয়ার্কস।
হলুদ এবং সবুজ রেখাগুলো নেটওয়ার্কগুলোর ভ্যারিয়েন্স এবং স্ট্যান্ডার্ড ডেভিয়েশন দেখাচ্ছে। “কনফিডেন্স ইন্টারভাল” এর মতোই এগুলোও আমাদের জন্য কার্যকরী – যেহেতু ফাংশনগুলো প্রতিটি আউটপুটের জন্য কেবল একটিই প্রেডিকশন দেয়, সেহেতু অনসম্বল ভ্যারিয়েন্স প্রেডিকশন ব্যবহারের মাধ্যমে আমরা অনুমান করতে পারি অনিশ্চয়তার সাথে প্রেডিকশনগুলো করা হচ্ছে। এর গুরুত্ব আমরা চিত্র ১২ তে দেখতে পাই, যেখানে আমরা ডিসিশন ফাংশনগুলোকে ট্রেনিং ইন্ট্রারভাল (ট্রেনিং এর ক্ষেত্র) এর বাইরে বর্ধিত করি যা $+\infty, -\infty$ পর্যন্ত বিস্তৃত।
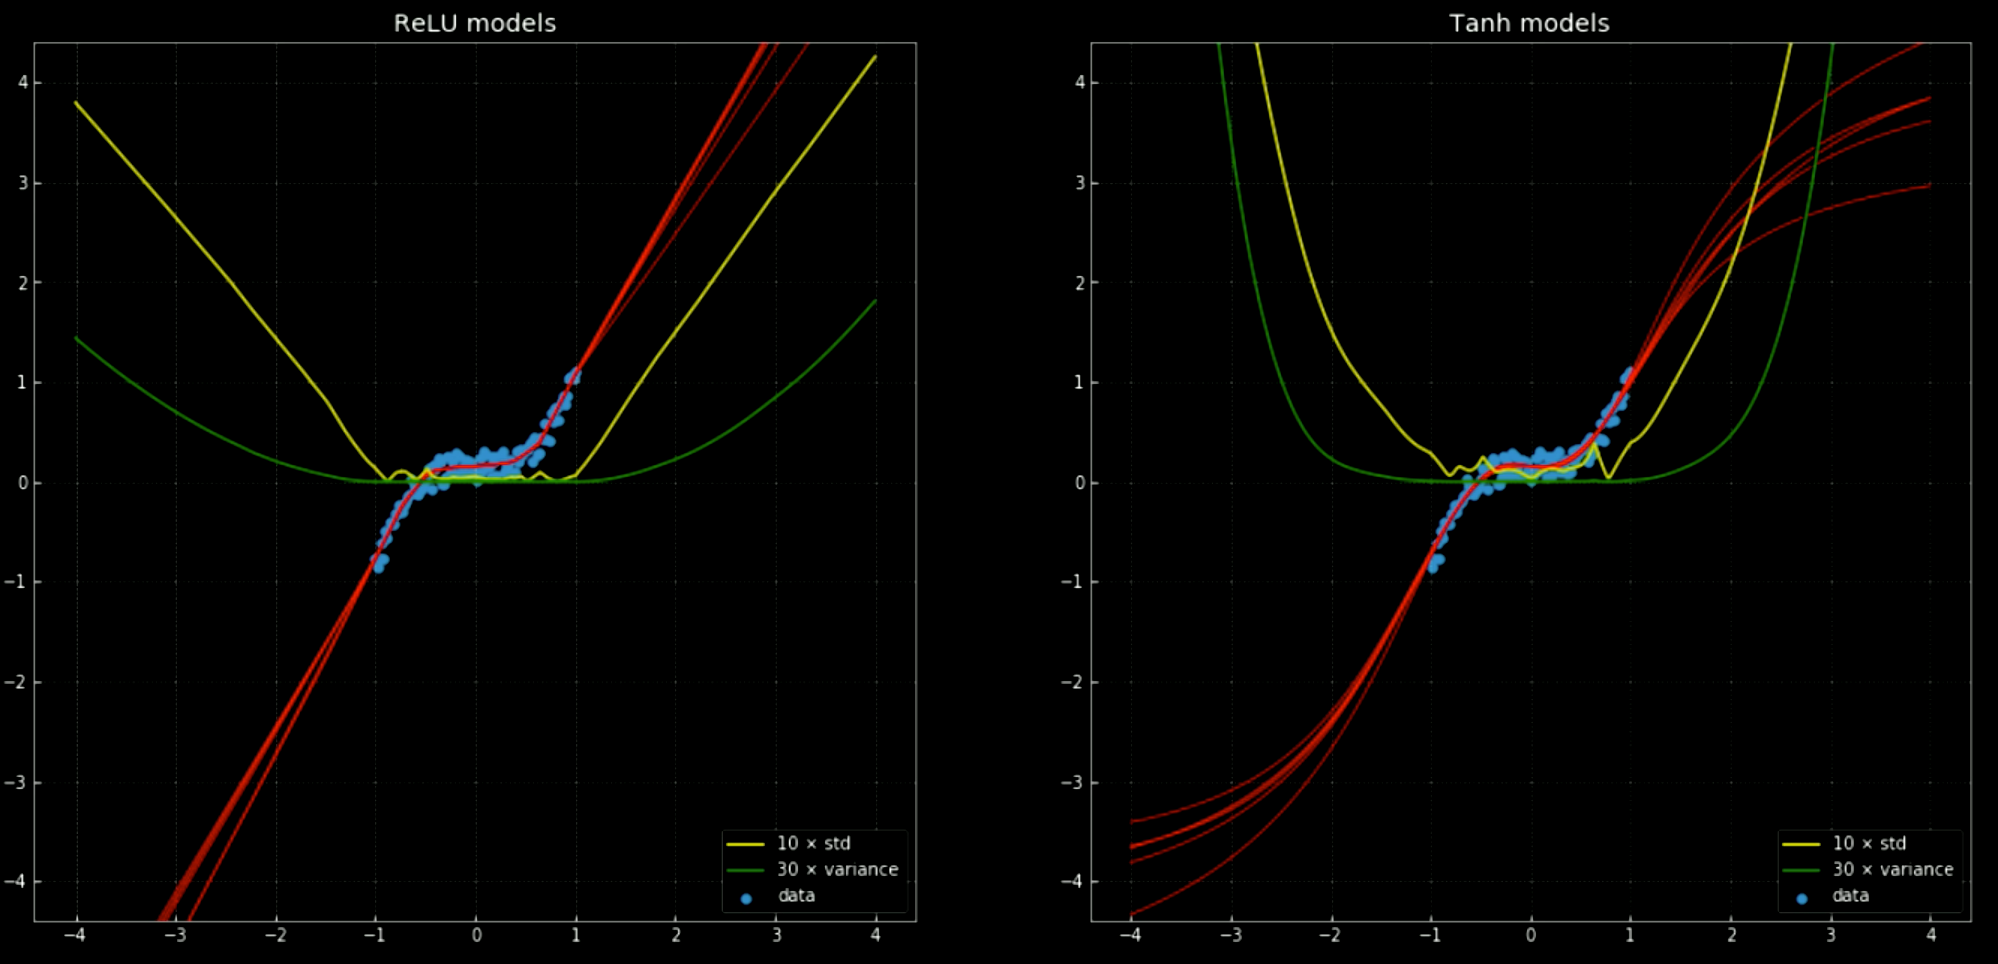
চিত্র ১২ নিউরাল নেটওয়ার্কস, সাথে সেগুলোর ভ্যারিয়েন্স এবং স্ট্যান্ডার্ড ডেভিয়েশন, ট্রেনিং ইন্টারভাল এর বাইরে
বামে: ৫টি
ReLU নেটওয়ার্কস। ডানে: ৫টি tanh নেটওয়ার্কস।
পাইটর্চ দিয়ে যেকোনো নিউরাল নেটওয়ার্ক ট্রেন করতে চাইলে, তোমাকে ট্রেনিং লুপে ৫টি মৌলিক ধাপ নিশ্চিত করতে হবে:
১. output = model(input) হচ্ছে মডেলের ফরওয়ার্ড পাস্ , যা ইনপুট নেয় এবং আউটপুট তৈরী করে।
২. J = loss(output, target <or> label) মডেলের আউটপুট কে নিয়ে প্রকৃত টার্গেট অথবা লেবেলের সাপেক্ষে ট্রেনিং লস বের করে।
৩. model.zero_grad() পূর্ববর্তী গ্রাডিয়েন্টসগুলোকে মুছে দেয়, যাতে করে সেগুলো পরবর্তী বারে একত্রিত না হয়ে যায়।
৪. J.backward() ব্যাকপ্রোপাগেশন এবং একত্রীকরণ: এটি প্রতিটি ভ্যারিয়েবল $\texttt{x}$ যার জন্য আমরা requires_grad=True করেছি সেগুলোর $\nabla_\texttt{x} J$ বের করে। এরপর এগুলো প্রতিটি ভ্যারিয়েবলের গ্রেডিয়েন্ট হিসেবে একত্র করা হয়: $\texttt{x.grad} \gets \texttt{x.grad} + \nabla_\texttt{x} J$.
৫. optimiser.step() গ্রাডিয়েন্ট ডিসেন্ট এ এক ধাপ অগ্রসর হয়: $\vartheta \gets \vartheta - \eta\, \nabla_\vartheta J$.
একটি NN (নিউরাল নেটওয়ার্ক) ট্রেনিং এর সময় বেশির সম্ভাবনা রয়েছে যে তোমার এই ৫টি ধাপ উপরিউক্ত ক্রমেই ব্যবহার করতে হবে।
Khalid Saifullah
4 Feb 2020