লফ ফাংশনসমূহ (চলমান) এবং এনার্জি বেজড মডেলের জন্য লস ফাংশন
🎙️ Yann LeCunবাইনারি ক্রস এন্ট্রপি (BCE) লস- nn.BCELoss()
\[\ell(x,y) = L = \{l_1,...,l_N\}^T, \qquad l_n = -w_n[y_n\log x_n+(1-y_n)\log(1-x_n)]\]
এটি ক্রস এন্ট্রপির একটি বিশেষ কেস, যখন তোমার শুধু দুইটি ক্লাস থাকে, তখন এটিকে একটি সরল ফাংশনে পরিবর্তন করা যায়। এটি রিকন্সট্রাকশনের এরর পরিমাপে ব্যবহার করা হয়, যেমন, অটো-এনকোডার। এই সুত্রটি ধরে নেয় $x$ এবং $y$ প্রোবাবিলিটি, তাই তারা কড়াকড়িভাবে ০ এবং ১ এর মাঝে থাকে।
Kullback-Leibler Divergence Loss - nn.KLDivLoss()
\[\ell(x,y) = L = \{l_1,...,l_N\}^T, \qquad l_n = y_n(\log y_n-x_n)\]
যখন টার্গেট একটি ওয়ান-হট ডিস্ট্রিবিউশান, তখন এর জন্য এটি একটি সরল লস ফাংশন (যেমন, $y$ একটি ক্যাটাগরি)। এটি ধরে নেয় $x$ এবং $y$ হলো প্রোপাবিলিটি। এটির অসুবিধা হলো এটি সফট্ম্যাক্স বা লগ-সফট্ম্যাক্স এর সাথে মার্জ করা না, যার ফলে এটির সংখ্যাগত স্থিতিশীলতাগত সমস্যা থাকতে পারে।
BCE লস এর সাথে লগিটস - nn.BCEWithLogitsLoss()
\[\ell(x,y) = L = \{l_1,...,l_N\}^T, \qquad l_n = -w_n[y_n\log \sigma(x_n)+(1-y_n)\log(1-\sigma(x_n))]\]
যে স্কোর গুলো সফট্ম্যাক্সের ভিতর দিয়ে যায়নি, সেগুলোকে নিয়ে বাইনারি ক্রস এনট্রপির এই ভার্সনটি কাজ করে, তাই এটি ধরে নেয় না যে x ০ এবং ১ এর মাঝামাঝি হবে। সীমা নিশ্চিত করার জন্য এটিকে এর পরে সিগময়েড দিয়ে চালনা করা হয়। লস ফাংশনটিকে এভাবে একত্রিত করা হলে সংখ্যাগতভাবে স্থিতিশীল হতে পারে।
মার্জিন র্যাংকিং লস - nn.MarginRankingLoss()
\[L(x,y) = \max(0, -y*(x_1-x_2)+\text{margin})\]
মার্জিন লস একটি গুরুত্বপূর্ণ ক্যাটগরির লস। তোমার কাছে যদি দুটি ইনপুট থাকে, এই লস ফাংশনটি বলছে যে তুমি চাও, যেন, একটি এনপুট আরেকটি এনপুটের থেকে কমপক্ষে একটি মার্জিনের সমান বা বড় হয়। এই ক্ষেত্রে $y$ একটি বাইনারি ভেরিয়েবল $\in { -1, 1}$। কল্পনা কর যে, ইনপুট দুটি, দুটি ভিন্ন ক্যাটাগরির। তুমি সঠিক ক্যাটাগরির জন্য, বেঠিক ক্যাটগরির থেকে কমপক্ষে একটি মার্জিন বজায় রেখে স্কোর করতে চাও। হিঞ্জ লসের মতই, যদি $y*(x_1-x_2)$ একটি মার্জিন থেকে বড় হয়, তাহলে কস্ট ০। এটি যদি ছোট হয় তবে, কস্ট রৈখিকভাবে বাড়োতে থাকে। তুমি যদি এটি ক্লাসিফিকেশনে ব্যবহার করতে চাও, তবে মিনি-ব্যাচে, $x_1$ হবে তোমার সঠিক উত্তরের জন্য স্কোর, এবং $x_2$ হবে বেঠিক উত্তরের জন্য সর্বোচ্চ স্কোর। যদি এটি এনার্জি বেজড মডেলে (পরে আলোচিত) ব্যবহার করা হয় তবে, এটি $x_1$ সঠিক উত্তরকে নিচে ঠেলে দেয় এবং $x_2$ বেঠিক উত্তরকে উপরের দিকে ঠেলে দেয়।
ট্রিপলেট মার্জিন লস - nn.TripletMarginLoss()
\[L(a,p,n) = \max\{d(a_i,p_i)-d(a_i,n_i)+\text{margin}, 0\}\]
এই লস ফাংশনটি বিভিন্ন স্যাম্পলের মাঝে সিমিলারিটি পরিমাপের জন্য ব্যবহার করা হয়। উদাহরণ স্বরূপ, তুমি CNN এ একই ক্যাটাগরির দুটি ছবি দিলে এবং দুটি ভেক্টর পেলে। তুমি চাও এই দুটি ভেক্টরের মধ্যে দূরত্ব যেন যতটা সম্ভব কম হয়। তুমি যদি দুটি ভিন্ন ক্যাটাগরির ছবি CNN মধ্যে রাখ, তবে তুমি চাও এদের মধ্যকার ভেক্টর এর দূরত্ব যতটা সম্ভব বেশী হয়। এই লস ফাংশনটি চেষ্টা করে, যেন প্রথম দূরত্বটি ০ এর কাছাকাছি হয় এবং দ্বিতীয়টি কোন এক মার্জিনের চেয়ে বড় হয়। কিন্তু আসলে যেটি গুরুত্বপূর্ণ তা হলো, একই ধরণের জোড়ের মধ্যে দূরত্ব ভিন্ন জোড়ের মধ্যকার দূরত্বের থেকে কম হবে।
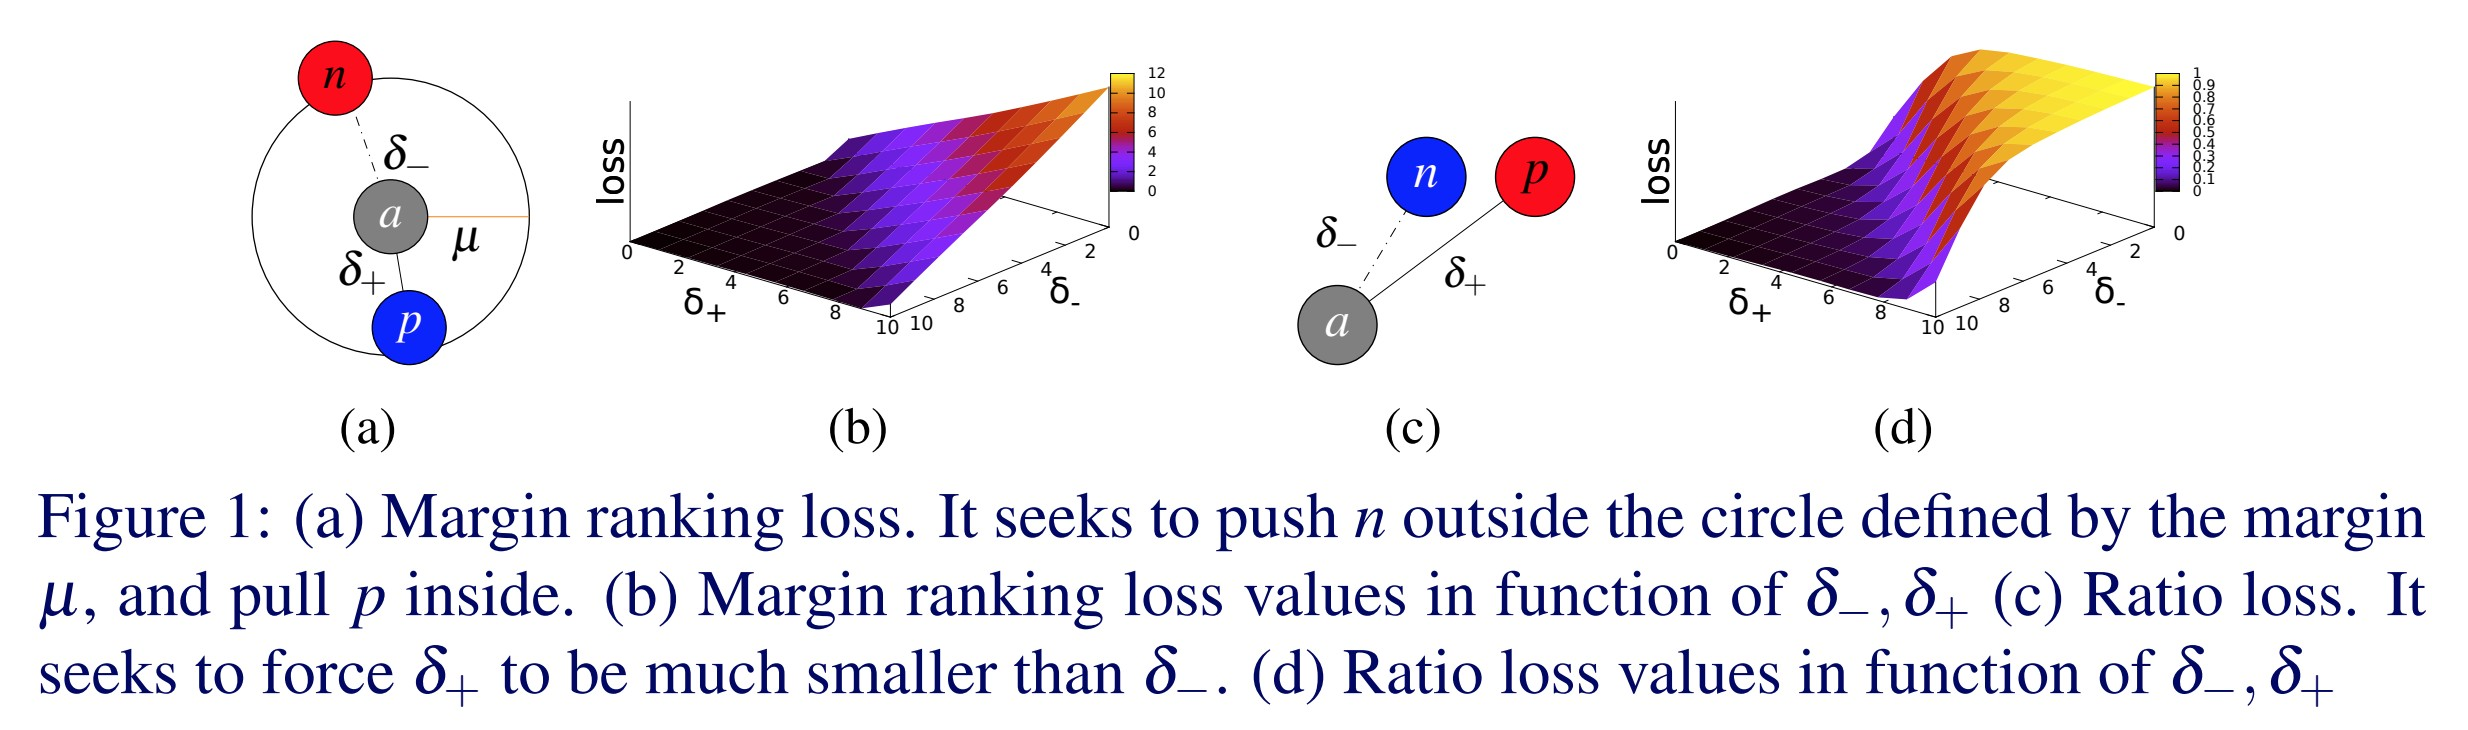
ফিগার ১: ট্রিপলেট মার্জিন লস
এটি মূলত গুগলের ইমেজ সার্চ সিস্টেম ট্রেইন করতে ব্যবহার করা হয়েছিলো। ওইসময়, তুমি গুগলে একটি কুয়েরি লিখবে এবং এটি ওই কুয়েরিকে একটি ভেক্টরে এনকোড করবে। এটি তখন কিছু ইমেজ থেকে তৈরি ভেক্টরের সাথে তুলনা করে দেখবে, যেগুলো পূর্বেই ইন্ডেক্স করা হয়েছিলো। গুগল তখন যে ছবিগুলো তোমার ভেক্টরের সবচেয়ে কাছাকাছি ছিলো সেগুলোকে বের করে আনবে।
Soft Margin Loss - nn.SoftMarginLoss()
\[L(x,y) = \sum_i\frac{\log(1+\exp(-y[i]*x[i]))}{x.\text{nelement()}}\]
একটি ক্রাইটেরিয়া তৈরী করে যা ইনপুট টেনসর $x$ এবং টার্গেট টেনসর $y$ (১ অথবা -১ সংবলিত) এর মধ্যে একটি দুই-ক্লাস ক্লাসিফিকেশান লজিস্টিক লসকে অপ্টিমাইজ করে।
- এটি মার্জিন লসের সফট্ম্যাক্স ভার্সন। তোমার কাছে কিছু পসিটিভ এবং কিছু নেগেটিভ আছে যা তুমি একটি সফট্ম্যাক্সের ভিতর দিয়ে পাস করতে চাও। এই লস ফাংশনটি তখন অন্য যেকোনটির চেয়ে সঠিক $x[i]$ এর জন্য $\text{exp}(-y[i]*x[i])$ তৈরি করতে চেষ্টা করে।
- তবে একটি হার্ড মার্জিনের বিপরীতে, লসের উপর কনটিনিউআস, এক্সপোনেন্সিয়ালি ডিকেয়িং ইফেক্টের সাথে এই লস ফাংশনটি $y[i]*x[i]$ এর পসিটিভ মানগুলোকে কাছে টানতে এবং নেগেটিভ মানগুলোকে দূরে রাখতে চায়।
মাল্ট-ক্লাস হিঞ্জ লস - nn.MultiLabelMarginLoss()
\[L(x,y)=\sum_{ij}\frac{\max(0,1-(x[y[j]]-x[i]))}{x.\text{size}(0)}\]
এই মার্জিন বেজড লস বিভিন্ন ইনপুটকে পরীবর্তনশীল টার্গেট রাখার অনুমতি দেয়। এই ক্ষেত্রে তোমার কিছু ক্যাটাগরি আছে যেগুলোয়ার জন্য তুমি হাই স্কোর চাও, এবং এটি সব ক্যাটাগরির উপর হিঞ্জ লসকে যোগ করে। ইবিএম এর জন্য এই লস ফাংশনটি কাঙ্ক্ষিত ক্যাটাগরিগুলোকে নিচে ঠেলে দেয় এবং অনাকাঙ্ক্ষিত ক্যাটাগরিগুলোকে উপরের দিকে ঠেলে দেয়।
হিঞ্জ এম্বেডিং লস - nn.HingeEmbeddingLoss()
\[l_n =
\left\{
\begin{array}{lr}
x_n, &\quad y_n=1, \\
\max\{0,\Delta-x_n\}, &\quad y_n=-1 \\
\end{array}
\right.\]
হিঞ্জ এম্বেডিং লস, দুটি ইনপুটের সাদৃশ্য বা বৈসাদৃশ্য পরিমাপের মাধ্যমে সেমি-সুপারভাইসড লার্নিং এর ক্ষেত্রে ব্যবহার করা হয়। এটি সদৃশ জিনিষগুলোকে কাছে টেনে রাখে এবং বিসদৃশ জিনিষগুলোকে দূরে ঠেলে দেয়। কোন জোড়া স্কোরকে কোন নির্দিষ্ট দিকে নিয়ে যাওয়ার প্রয়োজন কি না তা $y$ নির্দেশ করে। হিঞ্জ লস ব্যবহার করলে , যদি $y$ এর মান ১ হয়, তবে স্কোরটি ধণাত্মক এবং -১ হলে স্কোরটি কোন মার্জিন $\Delta$ এর সমান হয়।
কোসাইন এম্বেডিং লস - nn.CosineEmbeddingLoss()
\[l_n =
\left\{
\begin{array}{lr}
1-\cos(x_1,x_2), & \quad y=1, \\
\max(0,\cos(x_1,x_2)-\text{margin}), & \quad y=-1
\end{array}
\right.\]
কোসাইন দূরত্ব ব্যবহার করে, দুটি ইনপুট সদৃশ বা বিসদৃশ তা পরিমাপের জন্য এই লস ফাংশনটি ব্যবহার করা হয় এবং এটি সাধারণত নন-লিনিয়ার এম্বেডিং অথবা সেমি-সুপারভাইজড লার্নিং এ ব্যবহার করা হয়।
- যদিও অন্যভাবে, ১ বিয়োগ দুটি ভেক্টরের মধ্যকার কোসাইন কোণ, মূলত তাদের মধ্যকার ইউক্লিডীয়ান দূরত্ব।
- এটির সুবিধা হলো, যখনি তুমি চাইবে দুটি ভেক্টরের মধ্যকার দূরত্ব যতটা সম্ভব বড় করতে, ভেক্টরগুলোকে অনেক বড় করার মাধ্যমে নেটোওয়ার্কে এটি সহজেই অর্জন করা যায়। অবশ্যই, এটি অপ্টিমাল না। তুমি চাও না সিস্টেম ভেক্টর গুলোকে বড় করুক কিন্তু, ডান দিকে আবর্তিত করাক, তাই তুমি ভেক্টরগুলোকে নরমালাইজ কর এবং তাদের মধ্যকার নরমালাইজড দূরত্ব পরিমাপ কর।
- ধণাত্মক ক্ষেত্রে, এই লসটি ভেক্টর গুলোকে যতটা সম্ভব সারিবদ্ধ করার চেষ্টা করে। ঋণাত্মক ক্ষেত্রে, এই লস ফাংশনটি চেষ্টা করে কোসাইন যাতে একটি নির্দিষ্ট মার্জিনের চেয়ে কম হয়। মার্জিনটি এখানে একটি ছোট ধণাত্মক মান হওয়া উচিত।
- উচ্চ মাত্রার স্পেস এ, গোলকের নীরক্ষ রেখার আশেপাশে অনেক যায়গা আছে। নরমালিজেশানের পরে, সব পয়েন্ট গোলকের উপর নরমালাইজড হবে। তুমি চাও, যেসব স্যাম্পল আক্ষরিকভাবে একই , ওগুলো যাতে তোমার কাছাকাছি থাকে। যে স্যাম্পল গুলো ভিন্ন, সেগুলো যাতে লম্বভাবে থাকে। তুমি চাও না, এরা যাতে এক অপরের বিপরীতে থাকে, কারণ মেরুর কাছে শুধু একটি পয়েন্টই আছে। বরং, নীরক্ষরেখার উপরে অনেক যায়গা আছে, তাই তুমি চাও মার্জিন যাতে কোন ছোট ধণাত্মক মান হয় যাতে তুমি এই অঞ্চলের পুরো যায়গার সুবিধা নিতে পারো।
কানেকসনিস্ট টেম্পোরাল ক্লাসিফিকেশন (সিটিসি) লস - nn.CTCLoss()
নিরবিচ্ছিন্ন (অখন্ডিত) টাইম সিরিজ এবং একটি টার্গেট সিকুয়েন্সের মাঝে লস এর পরিমাপ।
- সিটিসি লস ইনপুট থেকে টার্গেটের সাম্ভব্য এলাইনমেন্টের প্রোবাবিলিটিগুলোকে যোগ করে, যা একটি লস মান দেয় যেটি প্রত্যেক ইনপুটের সাপেক্ষে ডিফারেন্সিয়েবল।
- ইনপুট থেকে টার্গেটের এলাইনমেন্টকে “মেনি টু ওয়ান” ধরে নেয়া হয়, যেটি টার্গেট সিকুয়েন্সের সীমা কে নির্দিষ্ট করে দেয় যাতে এটি অবশ্যই ইনপুটের দৈর্ঘ্যের সমান বা ছোট হতে হবে।
- আউটপুট যখন ভেক্টরের ক্রম হয় তখন এটি কার্যকর, যেটি ক্যাটাগরির স্কোরের অনুরূপ।

ফিগার ২: স্পিচ রিকগনিসনে সিটিসি লস।
প্রয়োগিক উদাহরণঃ স্পিচ রিকগ্নিশন সিস্টেম
- গোলঃ প্রতি ১০ মিলিসেকেন্ডে কোন শব্দটি উচ্চারিত হচ্ছে তা প্রেডিক্ট করা।
- প্রত্যেক শব্দকে কিছু ধ্বনির ক্রম হিসেবে উপস্থাপন করা হয়।
- লোকের কথা বলার গতির উপর নির্ভর করে, ভিন্ন দৈর্ঘ্যের শব্দ একই শব্দে ম্যাপ হয়ে যেতে পারে।
- ইনপুটের ক্রম থেকে আউটপুটে সবচেয়ে ভালো ম্যাপিং খুঁজে বের করতে হবে। মিনিমাম কস্ট পাথ খুঁজে বের করার সময় ডাইনামিক প্রোগ্রামিং এর ব্যবহার একটি ভালো উপায়।
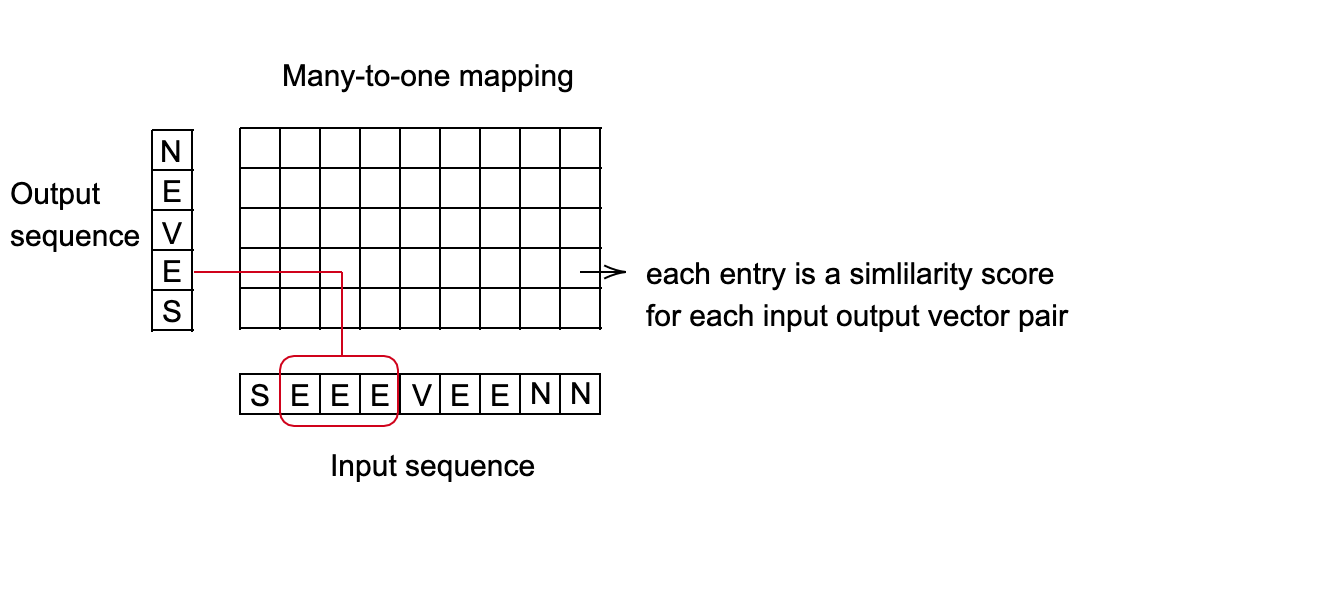
ফিগার ৩: "ম্যানি টু ওয়ান" ম্যাপিং সেটআপ।
এনার্জি-বেজড মডেল সমূহ ( পার্ট ৪ ) - লস ফাংশন
আর্কিটেকচার এবং লস ফাংশন
এনার্জি ফাংশনের ফ্যামিলিঃ $\mathcal{E} = {E(W,Y, X) : W \in \mathcal{W}}$
ট্রেইনিং সেটঃ $S = {(X^i, Y^i): i = 1 \cdots P}$
লস ফাংশনালঃ $\mathcal{L} (E, S)$
- ফাংশনাল মানে হলো আরেকটি ফাংশনের ফাংশন। এই ক্ষেত্রে, ফাংশনাল $\mathcal{L} (E, S)$ হলো এনার্জি ফাংশন্ন $E$ এর একটি ফাংশন।
-
$E$, $W$ দ্বারা প্যারামিটারাইজড হওয়ার কারণে, আমরা ফাংশনালটিকে $W$ এর একটি লস ফাংশনে পরিবর্তিত করতে পারিঃ $\mathcal{L} (W, S)$
- ট্রেনিং সেটে একটি এনার্জি ফাংশনের গুণাগুণ পরিমাপ করে।
- স্যাম্পলগুলোর বিন্যাস এবং পুনরাবৃত্তির ক্ষেত্রে এটি একটি ইনভ্যারিয়েন্ট।
ট্রেনিংঃ $W^* = \min_{W\in \mathcal{W}} \mathcal{L}(W, S)$.
লস ফাংশনাল থেকেঃ
- $L(Y^i, E(W, \mathcal{Y}, X^i))$ হলো পার-স্যাম্পল লস
- $Y^i$ হলো কাঙ্ক্ষিত উত্তর, যা ক্যাটাগরি বা একটি পুরো ছবি হতে পারে, ইত্যাদি।
- একটি প্রদত্ত $X_i$ এর জন্য $E(W, \mathcal{Y}, X^i)$ হলো এনার্জি সার্ফেস, যেখানে $Y$ পরিবর্তনশীল
- $R(W)$ হলো রেগুলারাইজার।
একটি ভালো লস ফাংশন ডিজাইন করা
একটি সঠিক উত্তরের এনার্জিকে নিচে ঠেলে দেওয়া।
বেঠিক উত্তরের এনার্জিকে উপরে ঠেলে দেওয়া, বিশেষত এগুলো যদি সঠিক উত্তরের চেয়ে ছোট হয়।
লস ফাংশনের উদাহরণ
এনার্জি লস
\[L_{energy} (Y^i, E(W, \mathcal{Y}, X^i)) = E(W, Y^i, X^i)\]এই লস ফাংশনটি সঠিক উত্তরের এনার্জিগুলোকে নিচে ঠেলে দেয়। যদি নেটয়ার্কটি ঠিকমত ডিজাইন করা না হয় তবে, অধিকাংশ ক্ষেত্রে সমতল এনার্জি ফাংশনের মত হয়ে যেতে পারে, যেহেতু তুমি শুধু সঠিক উত্তরের জন্য এনার্জি কমাতে চেষ্টা করছো কিন্তু অন্য কোন ক্ষেত্রে এনার্জি বাড়াতে চেষ্টা করছো না। তাই সিস্টেমটি ধ্বসে পড়তে পারে।
ঋণাত্মক লগ-লাইকলিহুড লস
\[L_{nll}(W, S) = \frac{1}{P} \sum_{i=1}^P (E(W, Y^i, X^i) + \frac{1}{\beta} \log \int_{y \in \mathcal{Y}} e^{\beta E(W, y, X^i)})\]এই লস ফাংশনটি সঠিক উত্তরের এনার্জিকে নিচে ঠেলে দেয়, যদিও সকল উত্তরের প্রোবাবিলিটির অনুপাতে তাদের উপরের দিকে ঠেলে। এটি পারসেপ্ট্রন লস হ্রাস করে যখন $\beta \rightarrow \infty$। এটি বিভিন্ন কমিউনিটিতে, স্ট্রাকচার্ড আউটপুটের সাথে ডিস্ক্রিমিনেটিভ আউটপুটের জন্য অনেক সময় ধরে ব্যবহৃত হয়ে আসছে।
একটি প্রোবাবিলিস্টিক মডেল হলো একটি ইবিএম যেখানেঃ
- এনার্জিকে Y( যে ভ্যারিয়েবলকে প্রেডিক্ট করা হবে ) এর সাপেক্ষে ইন্টিগ্রেট করা যায়।
- লস ফাংশনটি হলো ঋণাত্মক লগ-লাইকলিহুড।
পারসেপ্ট্রন লস
\[L_{perceptron}(Y^i,E(W,\mathcal Y, X^*))=E(W,Y^i,X^i)-\min_{Y\in \mathcal Y} E(W,Y,X^i)\]৬০+ বছর আগের পারসেপ্ট্রন লসের সাথে খুবই সদৃশ, এবং এটি সবসময় পসিটিভ কারন মিনিমামটিও $Y^i$ এর থেকে বড়, সুতরাং $E(W,Y^i,X^i)-\min_{Y\in\mathcal Y} E(W,Y,X^i)\geq E(W,Y^i,X^i)-E(W,Y^i,X^i)=0$। একই গণনা দেখায় যে, $Y^i$ সঠিক উত্তর হলে এটি একদম শুন্য দেয়।
এই লস ফাংশনটি সঠিক উত্তরের এনার্জিকে ছোট করে দেয়, এবং একই সময়, অন্য সকল উত্তরের এনার্জিকে যতটা সম্ভব বড় করে দেয়। যাহোক, এই লস ফাংশনটি সকল বেঠিক $Y^i$ কে একই মান দিতে বাধা দেয় না, সুতরাং নন-লিনিয়ার সিস্টেমের জন্য এই অর্থে এটি একটি খারাপ লস ফাংশন। এই লসকে আরো উন্নতি করার জন্য আমরা “মোস্ট অফেন্ডিং ইনকরেক্ট আন্সার”কে সঙ্গায়িত করবো।
Gজেনারালাইজড মার্জিন লস
মোস্ট অফেন্ডিং ইনকরেক্ট আন্সারঃ ডিসক্রিত ক্ষেত্রেধর ধরো $Y$ একটি ডিসক্রিট ভেরিয়েবল। তখন একটি ট্রেইনিং স্যাম্পল $(X^i,Y^i)$ এর জন্য, মোস্ট অফেন্ডিং ইনকরেক্ট আন্সার $\bar Y^i$ হলো সেই উত্তর যেটির সকল সাম্ভব্য বেঠিক উত্তরের মধ্য সবচেয়ে কম এনার্জি রয়েছে।
\[\bar Y^i=\text{argmin}_{y\in \mathcal Y\text{ and }Y\neq Y^i} E(W, Y,X^i)\]মোস্ট অফেন্ডিং ইনকরেক্ট আন্সার
ধর, $Y$ একটি কন্টিনিউয়াস ভেরিয়েবল। এরপর একটি ট্রেনিং স্যাম্পল $(X^i,Y^i)$ এর জন্য, যেসকল উত্তর সঠিক উত্তর থেকে কমপক্ষে $\epsilon$ দূরে অবস্থির, তাদের মধ্যে মোস্ট অফেন্ডিং ইনকরেক্ট আন্সার টি হলো $\bar Y^i$
\[\bar Y^i=\text{argmin}_{Y\in \mathcal Y\text{ and }\|Y-Y^i\|>\epsilon} E(W,Y,X^i)\]ডিসক্রিট এর ক্ষেত্রে, মোস্ট অফেন্ডিং ইনকরেক্ট আন্সার টি হলো সেটি বেঠিক উত্তরের মধ্যে যেটির এনার্জি সিবচেয়ে কম। কনটিনিউয়াস এর ক্ষেত্রে যেসকল $Y$ এর এনার্জি $Y^i$ এর খুব কাছাকাছি তাদের $E(W,Y^i,X^i)$ এর কাছাকাছি হওয়া উচিত। তদূপরী $\text{argmin}$ যেটি $Y$ ও $Y^i$ অসাম্যতার উপর মূল্যয়ন করা হয়েছে, তার মান ০ হবে। এরপর আমরা একটা দূরত্ব $\epsilon$ নিয় এবং সিদ্ধান্ত নিই যে, যেসকল $Y$ $Y_i$ থেকে কমপক্ষে $\epsilon$ দূরত্বে থাকবে সেগুলোই কেবল “বেঠিক উত্তর” হবে। এজন্য যেসকল $Y$ $Y^i$ থেকে কমপক্ষে $\epsilon$ দূরত্বে কেবল তাদেরই অপ্টিমাইজেশন করা হয়।
যদি এনার্জি ফাংশনটি নিশ্চিত করতে পারে যে মোস্ট অফেন্ডিং ইনকরেক্ট আন্সার এর এনার্জি সঠিক উত্তরের এনার্জির থেকে কমপক্ষে একটি মার্জিনে বড়, তাহলে এই এনার্জি ফানশনটি ভালো কাজ করবে।
জেনেরালাইজড মার্জিন লস ফাংশনের উদাহরণ
হিঞ্জ লস
\[L_{\text{hinge}}(W,Y^i,X^i)=( m + E(W,Y^i,X^i) - E(W,\bar Y^i,X^i) )^+\]যেখানে $\bar Y^i$ হলো মোস্ট অফেন্ডিং ইনকরেক্ট আন্সার। এই লস ফাংশনটি নিশ্চিত করে যে, সঠিক এবং বেঠিক উত্তরের মধ্যে পার্থক্য যেন কমপক্ষে $m$ হয়।

ফিগার ৪: হিঞ্জ লস
প্রশ্নঃ তুমি কিভাবে $m$ এর মান বাছাই করবে ?
উত্তরঃ এটি যেকোন কিছু হতে পারে, কিন্তু এটি সর্বশেষ লেয়ারের অয়েটগুলোকে প্রভাবিত করে।
লগ লস
\[L_{\log}(W,Y^i,X^i)=\log(1+e^{E(W,Y^i,X^i)-E(W,\bar Y^i,X^i)})\]একে “সফট” হিঞ্জ লসের মতো চিন্তা করা যেতে পারে। সঠিক এবং বেঠিক উত্তরের পার্থক্য হিঞ্জ এর মাধ্যমে নিরূপনের বদলে এটি একটি সফট হিঞ্জ এর সাথে সমন্বিত করা হয়েছে। এই লস ফাংশনটি “অসীম মার্জিন” বানানোর চেষ্টা করে, কিন্তু ঢালের এক্সপোনেনসিয়াল ডিকের জন্য এটি ঘটে না।

ফিগার ৫: লগ লস
স্কোয়ার-স্কোয়ার লস
\[L_{sq-sq}(W,Y^i,X^i)=E(W,Y^i,X^i)^2+(\max(0,m-E(W,\bar Y^i,X^i)))^2\]এই লসটি এনার্জি এর স্কোয়ারকে একটি হিঞ্জ স্কোয়ারের সাথে সমন্বয় করে। এই সমন্বয়টি এনার্জিকে কমানোর চেষ্টা করে কিন্তু মোস্ট অফেন্ডিং ইনকরেক্ট আন্সারের জন্য মার্জিনকে কমপক্ষে $m$ করে। এটি সামিজ নেটস এ ব্যবহৃত লস এর সাথে এটির অনেক মিল রয়েছে।
অন্যান্য লস
অনেক ধরনের লস রয়েছে। এখানে কিছু ভালো এবং খারাপ লস ফাংশনের সারসংক্ষেপ দেওয়া হলো।
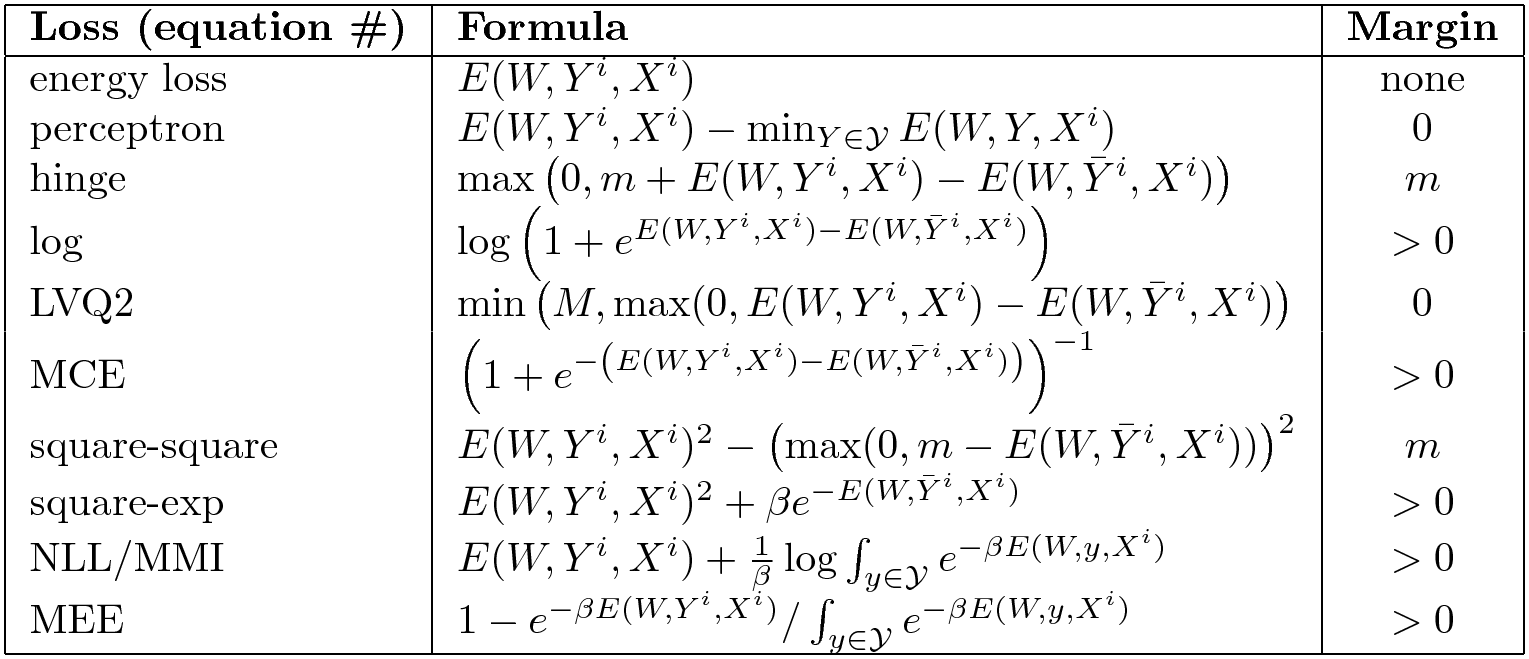
ফিগার ৬: ইবিএম লস ফানশনসমূহের বাছাই করা
ডান-হাতের কলামটি নির্দেশ করে এনার্জি ফাংশনটি মার্জিনকে চাপিয়ে দেয় কি না। পুরনো সরল এনার্জি লস কোথাও রেজল্টকে ঠেলে দেয় না, তাই এটির কোন মার্জিন নেই। এনার্জি লস সকল সমস্যার জন্য কাজ করেনা। পার্সেপট্রন লস কাজ করে, যদি তোমার এনার্জির একটি লিনিয়ার প্যারামিটারাইজেশন থাকে কিন্তু সাধারণ ক্ষেত্রে নয়। এদের কিছু কিছুর সিমীত মার্জিং থাকে, যেমন হিঞ্জ লস, আবার কিছু কিছুর অসীম মার্জিন থাকে, যেমন সফট হিঞ্জ।
প্রশ্নঃ কিভাবে মোস্ট অফেন্ডিং ইনকরেক্ট আন্সার কনটিনিউয়াস এর ক্ষেত্রে খুঁজে পারয়া গিয়েছে?
উত্তরঃ তুমি একটি পয়েন্টকে ঠেলতে চাও যেটি $Y^i$ থেকে যথেষ্ট দূরে রয়েছে, কারণ এটি যদি অনেক কাছে হয়, প্যারামিটারগুলোর বেশী পরিবর্তন নাও হতে পারে যেহেতু নিউরাল নেট সঙ্গায়িত ফাংশনটি অনেক দৃঢ়। কিন্তু সাধারণত, এটি কঠিন, এবং এই সমস্যাটিই মেথড সিলেক্টিং কস্ট্রাকটিভ স্যাম্পল সমাধানের চেষ্টা করে। এটির কোন সঠিক একক পদ্ধতি নেই।
হিঞ্জ ধরনের লসের আরেকটু সাধারন ধরণ হলোঃ
\[L(W,X^i,Y^i)=\sum_y H(E(W, Y^i,X^i)-E(W,y,X^i)+C(Y^i,y))\]আমরা ধরে নিই যে $Y$ ডিসক্রিট, কিন্তু এটি যদি কনটিনিউয়াস হতো, যোগফলটি একটি ইন্টিগ্রাল দ্বারা প্রতিস্থাপিত হবে। এখানে $E(W, Y^i,X^i)-E(W,y,X^i)$ হলো $E$ এর পার্থকে যেটি একটি সঠিক উত্তর এবং অন্য একটী উত্তেরের উপর মূল্যয়িত। $C(Y^i,y)$ হলো মার্জিন, এবং এটি সাধারণত $Y^i$ এবং $y$ এর মধ্যকার দূরত্বের পরিমাপ। এর প্রেরণ হলো যে, আমরা বেঠিক স্যাম্পল $y$ কে যে পরিমান ঠেলতে চাই, এটি $y$ সঠিক উত্তর $Y_i$ এর উপর নির্ভর করা উচিত। এটি অপ্টিমাইজেশনের জন্য আরো কঠিন লস হতে পারে।
📝 Charles Brillo-Sonnino, Shizhan Gong, Natalie Frank, Yunan Hu
Aditya Chakma
13 Apr 2020