গ্রেডিয়েন্ট ডিসেন্ট এবং ব্যাকপ্রোপ্যাগেশন অ্যালগরিদম
🎙️ Yann LeCunগ্রেডিয়েন্ট ডিসেন্ট অপ্টিমাইজেশন অ্যালগরিদম
প্যারামেট্রাইজড মডেল
\[\bar{y} = G(x,w)\]প্যারামেট্রাইজড মডেলগুলি এমন ফাংশন যা কেবল ইনপুট এবং ট্রেইনেবল প্য়ারামিটারগুলির উপর নির্ভর করে। ট্রেইনেবল প্য়ারামিটারগুলি ট্রেইনিং স্য়ম্পল এর মধ্যে শেয়ার করা হয় যেখানে ইনপুট স্য়ম্পল থেকে স্য়ম্পল এ পরিবর্তিত হয়, উভয়ের মধ্যে এছাড়া তেমন কোনও মৌলিক পার্থক্য নেই। বেশিরভাগ ডীপ লার্নিং ফ্রেমওয়ার্কগুলিতে প্যারামিটারগুলি অন্তর্নিহিত হয়, অর্থাৎ ফাংশনটি কল করার সময় সেগুলো পাস্ করা হয় না। এগুলিকে ফাংশনেরই একটি অংশ হিসেবে ভাবা হয়, অন্তত অবজেক্ট অরিয়েন্টেড মডেলগুলোতে তাই করা হয়ে থাকে।
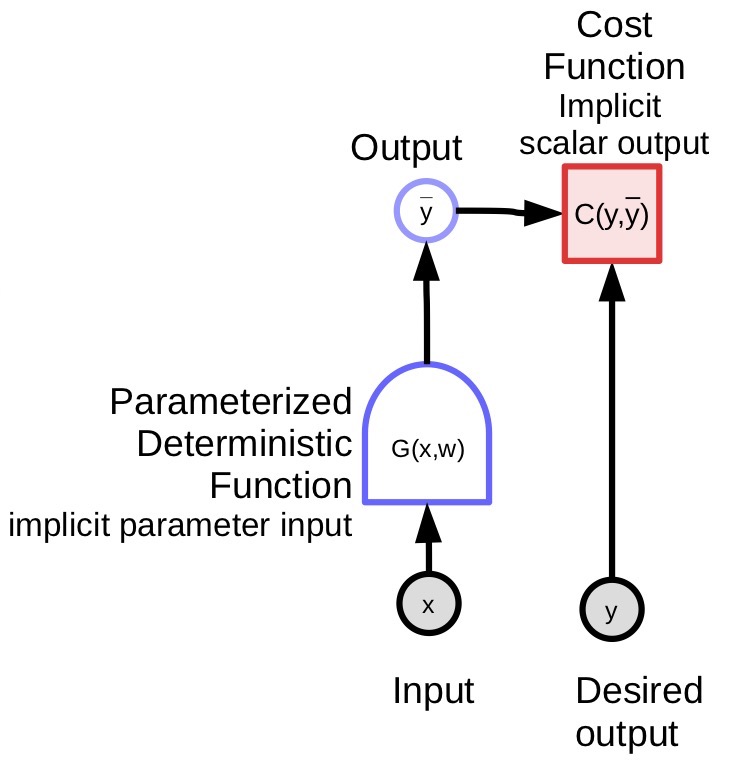
প্যারামেট্রাইজড মডেল (ফাংশন) একটি ইনপুট নেয়, এছাড়া এর একটি প্যারামিটার ভেক্টর থাকে এবং এটি একটি আউটপুট দেয়। সুপারভাইজড লার্নিং এ, এই আউটপুটটিকে এরপর কস্ট ফাংশন ($C(y,\bar{y}$)) এ পাঠানো হয় যা মডেল এর আউটপুট ($\bar{y}$) টিকে লেবেল/গ্রাউন্ড ট্রুথ (${y}$) এর সাথে তুলনা করে। এই মডেলটির কম্পিউটেশন গ্রাফ চিত্র ১ এ তুলে ধরা হয়েছে।
 |
প্যারামেট্রাইজড ফাংশন এর উদাহরণ -
-
লিনিয়ার মডেল - ইনপুট ভেক্টরের উপাদানগুলির ওয়েটেড সাম / সুষম যোগ :
\[\bar{y} = \sum_i w_i x_i, C(y,\bar{y}) = \Vert y - \bar{y}\Vert^2\] -
নিয়ারেস্ট নেইবার - এর ইনপুট হচ্ছে ইনপুট ভেক্টর $\vect{x}$ এবং ওয়েট ম্যাট্রিক্স $\matr{W}$ যার প্রতিটি সারি $k$ দ্বারা সূচিত (ইন্ডেক্সড)। $\matr{W}$ এর যেই সারি $\vect{x}$ এর সবচেয়ে নিকটবর্তী সেই সারির $k$ এর মান ই এই ফাংশন এর আউটপুট:
\[\bar{y} = \underset{k}{\arg\min} \Vert x - w_{k,.} \Vert^2\]জটিল ফাংশনগুলোও প্যারামিটারাইজড মডেল এর অন্তর্ভুক্ত হতে পারে।
কম্পিউটেশন গ্রাফগুলোর জন্য ব্লক ডায়াগ্রাম নোটেশন
- ভ্যারিয়েবল/চলক (টেনসর, স্কেলার, কন্টিনিউয়াস/অবিচ্ছিন্ন, ডিসক্রিট)
 হচ্ছে সিস্টেম এর একটি ইনপুট
 হচ্ছে একটি ডিটারমিনিস্টিক ফাংশন থেকে প্রাপ্ত গণনামূলক ভেরিয়েবল
-
ডিটারমিনিস্টিক ফাংশন
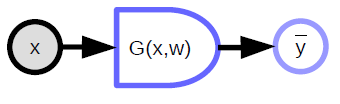
- একাধিক ইনপুট গ্রহণ করে এবং একাধিক আউটপুট দিতে পারে
- এটিতে একটি অন্তর্নিহিত প্যারামিটার ভেরিয়েবল রয়েছে (${w}$)
- বৃত্তাকার দিকটি সেই দিক নির্দেশ করে যেখানে এটির মান পাওয়া সহজ। উপরের চিত্রটিতে, ${x}$ থেকে ${\bar{y}}$ গণনা করা সহজ
-
স্কেলার-ভ্যালু ফাংশন
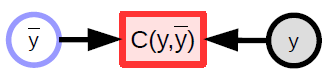
- কস্ট ফাংশন প্রকাশে ব্যাবহৃত হয়
- একটি অন্তর্নিহিত স্কেলার আউটপুট রয়েছে
- একাধিক ইনপুট নেয় এবং একক মান আউটপুট দেয় (যা সাধারণত ইনপুটগুলির মধ্যে দূরত্ব)
লস ফাংশন
লস ফাংশন এমন একটি ফাংশন যার মান ট্রেইনিং এর সময় হ্রাস করা হয়। লস ২ রকমের হয়ে থাকে:
1) স্যাম্পল প্রতি লস -
\[L(x,y,w) = C(y, G(x,w))\]2) এভারেজ/গড় লস -
স্যাম্পলগুলোর যেকোনো সেট এর জন্য
\[S = \lbrace(x[p],y[p]) \mid p \in \lbrace 0, \cdots, P-1 \rbrace \rbrace\]সেট $S$ এর জন্য এভারেজ/গড় লস হচ্ছে:
\[L(S,w) = \frac{1}{P} \sum_{(x,y)} L(x,y,w)\]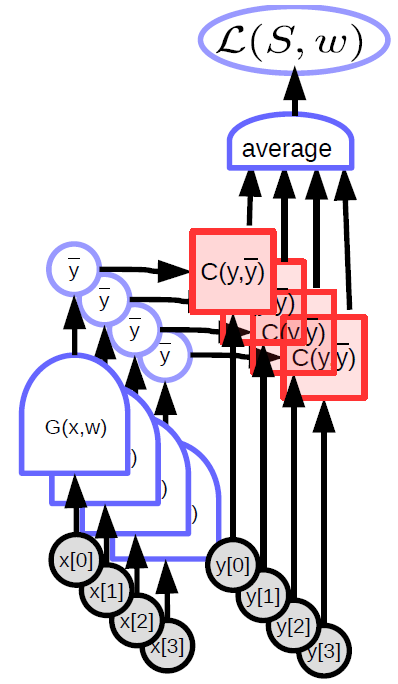 |
স্ট্যান্ডার্ড সুপারভাইজড লার্নিং প্যারাডাইম এ, লস (স্যাম্পল প্রতি) হচ্ছে কেবল কস্ট ফাংশন এর আউটপুট। মেশিন লার্নিং বেশিরভাগই অপ্টিমাইজিং ফাংশন গুলোকে ঘিরেই হয়ে থাকে (সাধারণত সেগুলোকে মিনিমাইজ/হ্রাস করার ব্যাপারে)। ২ টি ফাংশন এর মধ্যকার ন্যাশ ইকুইলিব্রিয়া খুঁজে বের করাও এর অন্তর্ভুক্ত হতে পারে, যেমনটি GANs এর ক্ষেত্রে। এটি একমাত্র গ্রেডিয়েন্ট ডিসেন্ট ই নয়, বরং গ্রেডিয়েন্ট বেসড মেথডিগুলোর মাধ্যমে করা হয়।
গ্রেডিয়েন্ট ডিসেন্ট
গ্রেডিয়েন্ট বেসড মেথড হ’ল একটি পদ্ধতি / অ্যালগরিদম যা কোনও ফাংশনের মিনিমা খুঁজে বের করে, যদি ধরে নেওয়া যায় যে ঐ ফাংশনটির গ্রেডিয়েন্ট কেউ সহজেই বের করতে পারে। অ্যালগরিদমটি ধরে নেয় যে ফাংশনটি সবজায়গায় কন্টিনিউয়াস এবং ডিফারেনশিয়েবল (যদিও এটি সর্বত্র কন্টিনিউয়াস হওয়ার দরকার নেই)।
গ্রেডিয়েন্ট ডিসেন্ট এর ধারণা - মনে কর একটি কুয়াশাচ্ছন্ন রাতে তুমি কোনো একটি পাহাড়ের উপর দাঁড়িয়ে আছো। যেহেতু তুমি পাহাড় থেকে নেমে নিচের জনবসতি এলাকায় যেতে চাও এবং তুমি চোঁখে তেমন কিছু দেখতে পাচ্ছনা তাহলে তুমি কি করবে? তুমি তোমার পায়ের কাছের সবচেয়ে নিম্নগামী যেই পথটি আছে সেদিকে পা বাড়াবে। গ্রেডিয়েন্ট ডিসেন্ট ও একই কাজ টি করে থাকে।
গ্রেডিয়েন্ট ডিসেন্ট এর বিভিন্ন মেথড
-
পূর্ণ (ব্যাচ) গ্রেডিয়েন্ট ডিসেন্ট আপডেট রুল :
\[w \leftarrow w - \eta \frac{\partial L(S,w)}{\partial w}\] -
SGD (স্টোকাস্টিক গ্রেডিয়েন্ট ডিসেন্ট) এর আপডেট রুল :
-
যেকোনো একটি $p \in \lbrace 0, \cdots, P-1 \rbrace$ ধরে নাও, এরপর আপডেট কর
\[w \leftarrow w - \eta \frac{\partial L(x[p], y[p],w)}{\partial w}\]
-
যেখানে ${w}$ হচ্ছে প্যারামিটার যা আমরা অপ্টিমাইজ করছি
$\eta$ এখানে একটি ধ্রুবক তবে আরও জটিল অ্যালগরিদমে এটি ম্যাট্রিক্স হতে পারে।
যদি এটি একটি পজিটিভ সেমি-ডেফিনিট ম্যাট্রিক্স হয়, সেক্ষেত্রেও আমরা নিম্নগামী পথেই অগ্রসর হবো তবে সেই পথটি সর্বোচ্চ নিম্নগামী (স্টিপেস্ট ডিসেন্ট) এর দিকে নাও হতে পারে। এমনকি সর্বোচ্চ নিম্নগামী (স্টিপেস্ট ডিসেন্ট) দিক আমাদের সবসময় প্রধান পছন্দ নাও হতে পারে।
যদি ফাংশনটি ডিফারেনশিয়েবল না হয়, অর্থাৎ এর গর্ত থাকে বা দেখতে সিঁড়ির মতো বা সমতল হয় যেখানে গ্রেডিয়েন্ট তোমাকে কোনও তথ্য দেয় না, তখন অন্য পদ্ধতি অবলম্বন করতে হয় - যার নাম 0-th Order Methods বা গ্রেডিয়েন্ট-ফ্রি মেথডস। ডিপ লার্নিং সম্পূর্ণ গ্রেডিয়েন্ট-বেসড মেথডস নিয়ে।
যদিও, RL (Reinforcement Learning) এ আমরা সরাসরি গ্রেডিয়েন্ট না বের করে গ্রেডিয়েন্ট অনুমান পদ্ধতি ব্যবহার করে থাকি. উদাহরণস্বরূপ ধরা যাক একটি রোবট বাইক চালানো শিখছে, এবং একটু পরপর রোবটটি পরে যাচ্ছে। এখানে আমাদের অবজেক্টিভ ফাংশনটি দেখে যে বাইকটি কতক্ষন না পড়ে দাঁড়িয়ে আছে। কিন্তু দুর্ভাগ্যবশত আমাদের এই অবজেক্টিভ ফাংশন এর কোনো গ্রেডিয়েন্ট নেই। তাই রোবট টিকে বিভিন্ন উপায়ে চেষ্টা করে যেতে হবে।
RL এর কস্ট ফাংশনটি বেশিরভাগ সময়ই ডিফারেনশিয়েবল হয় না তবে যেই নেটওয়ার্কটি আউটপুট দেয় সেটি গ্রেডিয়েন্ট বেসড। এটাই সুপারভাইজড লার্নিং এর সাথে রিইনফোর্সমেন্ট লার্নিং (RL) এর প্রধান পার্থক্য। শেষেরটিতে কস্ট ফাংশন ডিফারেনশিয়েবল নয়. এমনকি এটা সম্পূর্ণ অজানা। এটিতে কোনো ইনপুট দিলে, শুধুমাত্র আমরা আউটপুট পেয়ে থাকি, যা অনেকটা ব্ল্যাকবক্স এর মতো। এটিই RL এর অনেক বড় একটি অসুবিধা যা এটাকে অনেক ইনএফিসিয়েন্ট করে তোলে, বিশেষ করে যখন প্যারামিটার ভেক্টরটি হাই ডাইমেনশনাল হয় (যা আমাদের সমাধানের জায়গাকে (সল্যুশন স্পেস) অনেক বড় করে তোলে, ফলে যে কোনো দিকেই আগানো অনেক কঠিন হয়ে যায়)।
RL এর খুব জনপ্রিয় একটি টেকনিক হচ্ছে আর্কটিক ক্রিটিক মেথডস। আর্কটিক ক্রিটিক মেথডটিতে দ্বিতীয় আরেকটি C মডিউল যুক্ত থাকে যেটি একটি জানা, ডিফারেনশিয়েবল এবং ট্রাইনেবল মডিউল। তাই এই C মডিউল ব্যবহার করে কেউ চাইলে কস্ট ফাংশন / রিওয়ার্ড ফাংশন এর মান অনুমান করতে পারে। রিওয়ার্ড হচ্ছে একটি নেগেটিভ কস্ট যা অনেকটা পানিশমেন্ট এর মতো। এভাবেই আমরা কস্ট ফাংশনটিকে ডিফারেনশিয়েবল এ রূপান্তর করি অথবা আমরা অন্তত আমরা সেটার মান অনুমান করতে পারি অন্য একটি ডিফারেনশিয়েবল ফাংশন ব্যবহার করে যাতে করে আমরা ব্যাকপ্রোপাগেট করতে পারি।
নিউরাল নেটওয়ার্ক এর ক্ষেত্রে SGD এবং ব্যাকপ্রোপাগেসন এর সুবিধা
স্টোকাস্টিক গ্রেডিয়েন্ট ডিসেন্ট (SGD) এর সুবিধা
আমরা স্টোকাস্টিক গ্রেডিয়েন্ট ডিসেন্ট (SGD) দিয়ে প্যারামিটারগুলোর সাপেক্ষে অবজেক্টিভ ফাংশন এর গ্রেডিয়েন্ট বের করে থাকি। অবজেক্টিভ ফাংশনটির পূর্ণ গ্রেডিয়েন্ট বের না করে SGD তে আমরা শুধু একটি স্যাম্পল নেই, যার জন্য লস $L$ বের করে সেই লস এর গ্রেডিয়েন্ট ক্যালকুলেট করি প্যারামিটারগুলোর সাপেক্ষে, এরপর আমরা সেই গ্রেডিয়েন্ট এর বিপরীত দিকে এক ধাপ অগ্রসর হই।
\[w \leftarrow w - \eta \frac{\partial L(x[p], y[p],w)}{\partial w}\]ফর্মুলাটিতে $w$ এর আপডেট রুল দেখানো হয়েছে, যেখানে আমরা $w$ থেকে স্টেপ সাইজ ফ্র্যাকশন পরিমান প্যারামিটার এর সাপেক্ষে স্যাম্পল প্রতি লস ফাংশন এর গ্রেডিয়েন্ট যেকোনো একটি স্যাম্পল এর জন্য ($x[p]$,$y[p]$) বিয়োগ করছি।
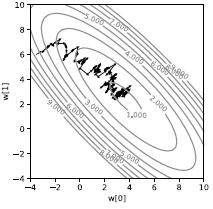
আমরা যদি এটি শুধুমাত্র একটি স্যাম্পল এর জন্য করে থাকি তাহলে আমরা খুবই কোলাহলপূর্ণ ট্র্যাজেক্টরি পাবো যেমনটি চিত্র 3 এ দেখানো হয়েছে। লস সম্পূর্ণ নিম্নগামী পথ অনুসরণ এর বদলে স্টোকাস্টিক আচরণ করে। একেকটি স্যাম্পল একেক দিকে লস কে অগ্রসর করাবে। গড় মান টিই মূলত আমাদেরকে মিনিমা এর দিকে পাঠায়। যদিও এটা দেখতে প্রচুর ইনেফিশিয়েন্ট মনে হয়, তবে এটা ফুল ব্যাচ গ্রেডিয়েন্ট ডিসেন্ট এর থেকে অনেক বেশি দ্রুত অন্তত মেশিন লার্নিং এ যখন স্যাম্পল গুলোর মাঝে কিছু রিডান্ডেন্সি থাকে।
 |
কিন্তু আমরা একটি স্যাম্পল এ স্টোকাস্টিক গ্রেডিয়েন্ট ডিসেন্ট (SGD) ব্যবহার করার থেকে বরং একটি ব্যাচ এর উপর তা ব্যবহার করি। একটি স্যাম্পল এর জন্য গ্রেডিয়েন্ট ক্যালকুলেট না করে পুরো একটু ব্যাচ এর গড় গ্রেডিয়েন্ট ক্যালকুলেট করি, এরপর সেইদিকে এক পা এগুই। এটি করার একমাত্র কারণ হলো আমাদের বিদ্যমান হার্ডওয়্যার এর (অর্থাৎ GPUs, multicore CPUs) সর্বোচ্চ শক্তি কে কাজে লাগানো। কারণ ব্যাচ হচ্ছে আমাদের কাজ কে প্যারালাইজ করার সবচেয়ে সহজ পদ্ধতি।
প্রচলিত নিউরাল নেটওয়ার্ক
প্রচলিত নিউরাল নেটওয়ার্কগুলো মূলত কিছু বিক্ষিপ্ত লেয়ার এর মধ্যকার লিনিয়ার অপারেশন এবং পয়েন্ট-ওয়াইজ নন-লিনিয়ার অপারেশন। লিনিয়ার অপারেশনটি হলো সহজভাবে বললে শুধুমাত্র ম্যাট্রিক্স-ভেক্টর গুণ। আমাদের ইনপুট ভেক্টরটিকে আমরা ম্যাট্রিক্স (যা ওয়েইট দিয়ে তৈরী) এর সাথে গুণ করি। দ্বিতীয় অপারেশনটি হচ্ছে এই ম্যাট্রিক্স-ভেক্টর গুণ করে পাওয়া সকল ওয়েইটেড সাম কে সাধারণ কোনো একটি নন-লিনিয়ারিটি এর মধ্য দিয়ে পাঠানো (যেমন $\texttt{ReLU}(\cdot)$, $\tanh(\cdot)$, …).
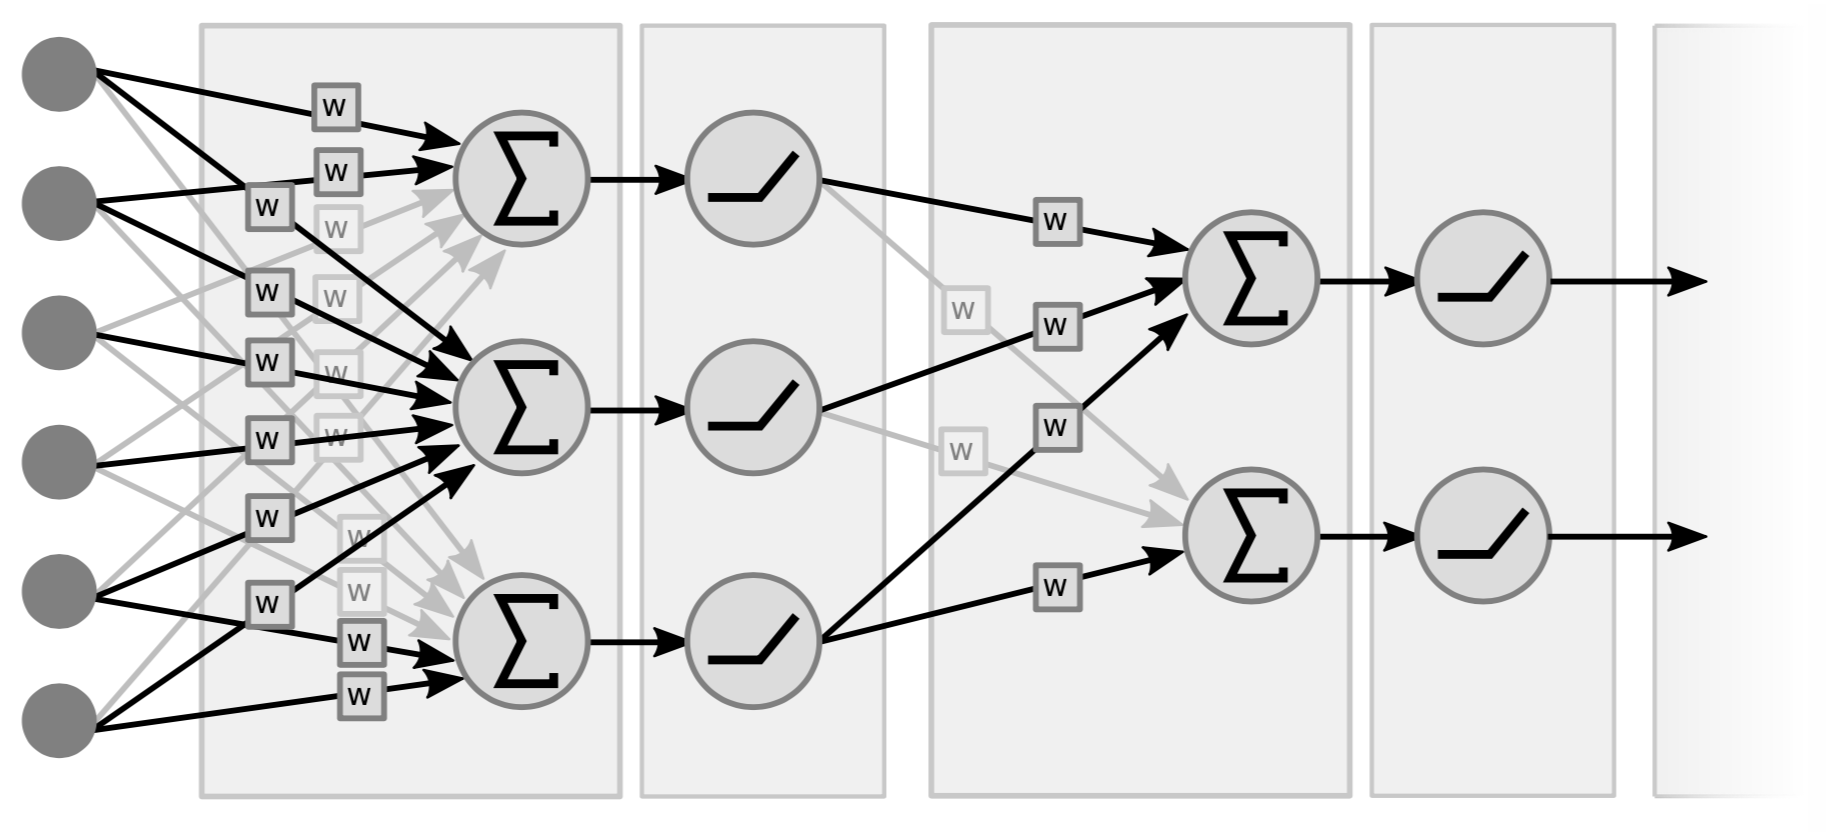 |
চিত্র ৪ হলো একটি ২ লেয়ার বিশিষ্ট নেটওয়ার্ক এর উদাহরণ, কারণ এখানে গুরুত্বপূর্ণ বেপারটি হচ্ছে (লিনিয়ার + নন-লিনিয়ার) এর একত্রিত হওয়া। কেউ কেউ এটাকে ৩ লেয়ার বিশিষ্ট নেটওয়ার্ক ও বলতে পারে কারণ তারা ইনপুট ভ্যারিয়েবলটিকেও হিসাব করে। মনে রাখবে, যদি মধ্যকার লায়েরটিতে কোনো নন-লিনিয়ারিটি না থাকে তাহলে এটা ১ টি লেয়ার বিশিষ্ট নেটওয়ার্ক এ পরিণত হবে, কারণ ২ টি লিনিয়ার ফাংশন এর প্রোডাক্ট ও একটি লিনিয়ার ফাংশনই ।
চিত্র ৫ এ আমরা দেখতে পাই কিভাবে নেটওয়ার্ক এর লিনিয়ার এবং নন-লিনিয়ার ফাংশনাল ব্লক একত্রিত হয়:
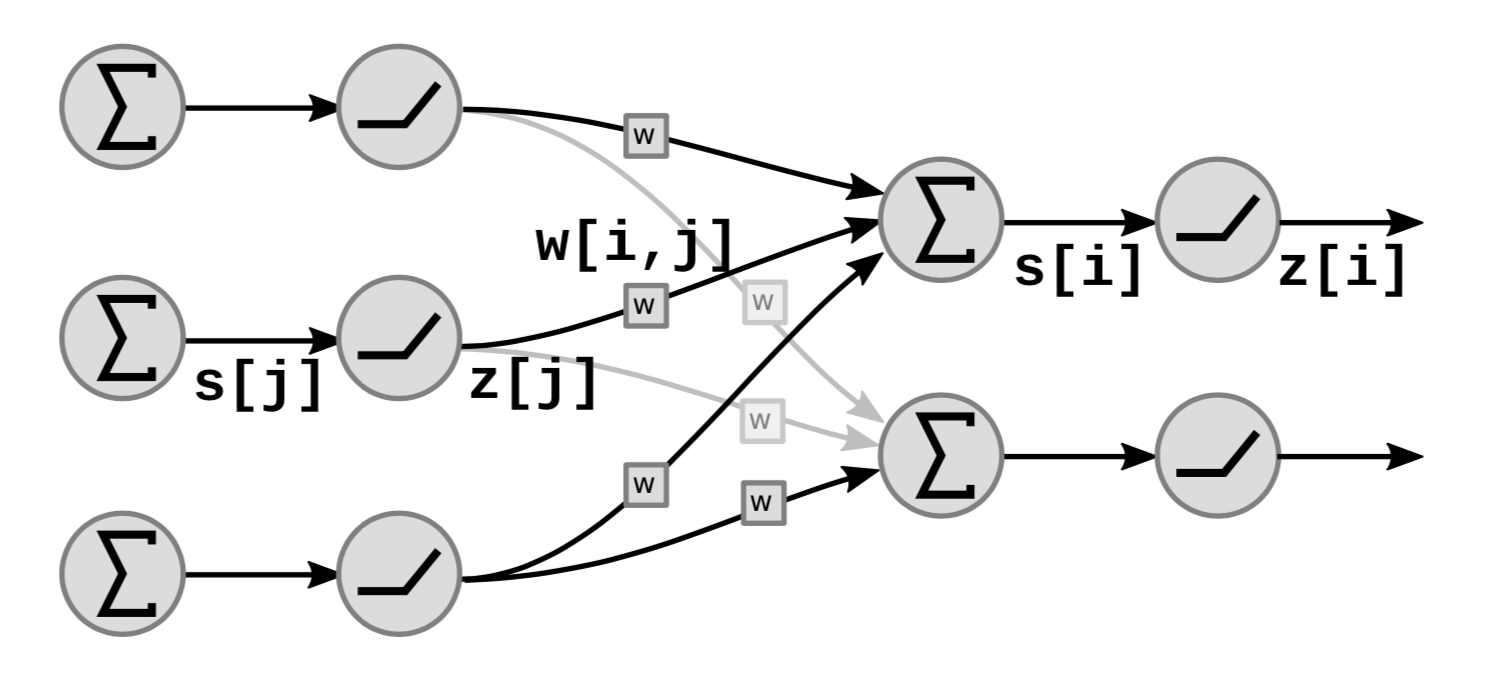 |
গ্রাফটিতে, $s[i]$ হচ্ছে ${i}$ ইউনিট এর ওয়েইটেড সাম যা নিম্নলিখিত উপায়ে বের করা হয়:
\[s[i]=\sum_{j \in UP(i)}w[i,j]\cdot z[j]\]where $UP(i)$ denotes the predecessors of $i$ and $z[j]$ is the $j$th output from the previous layer.যেখানে $UP(i)$ দ্বারা বুঝায় ${i}$ এর পূর্ববর্তী নোডগুলো এবং $z[j]$ হচ্ছে পূর্ববর্তী লেয়ার এর $j$ তম আউটপুট
আউটপুট $z[i]$ নিম্নলিখিত উপায়ে বের করা হয়:
\[z[i]=f(s[i])\]যেখানে $f$ হচ্ছে একটি নন-লিনিয়ার ফাংশন।
নন-লিনিয়ার ফাংশন এর মধ্য দিয়ে ব্যাকপ্রোপাগেসন
ব্যাকপ্রোপাগেসন এর প্রথম উপায় হচ্ছে একটি নন-লিনিয়ার ফাংশন এর মধ্য দিয়ে ব্যাকপ্রোপাগেট করা। আমরা নেটওয়ার্ক থেকে একটি নির্দিষ্ট নন-লিনিয়ার ফাংশন $h$ নেই এবং এছাড়া সব ব্ল্যাকবক্স এ রেখে দেই।
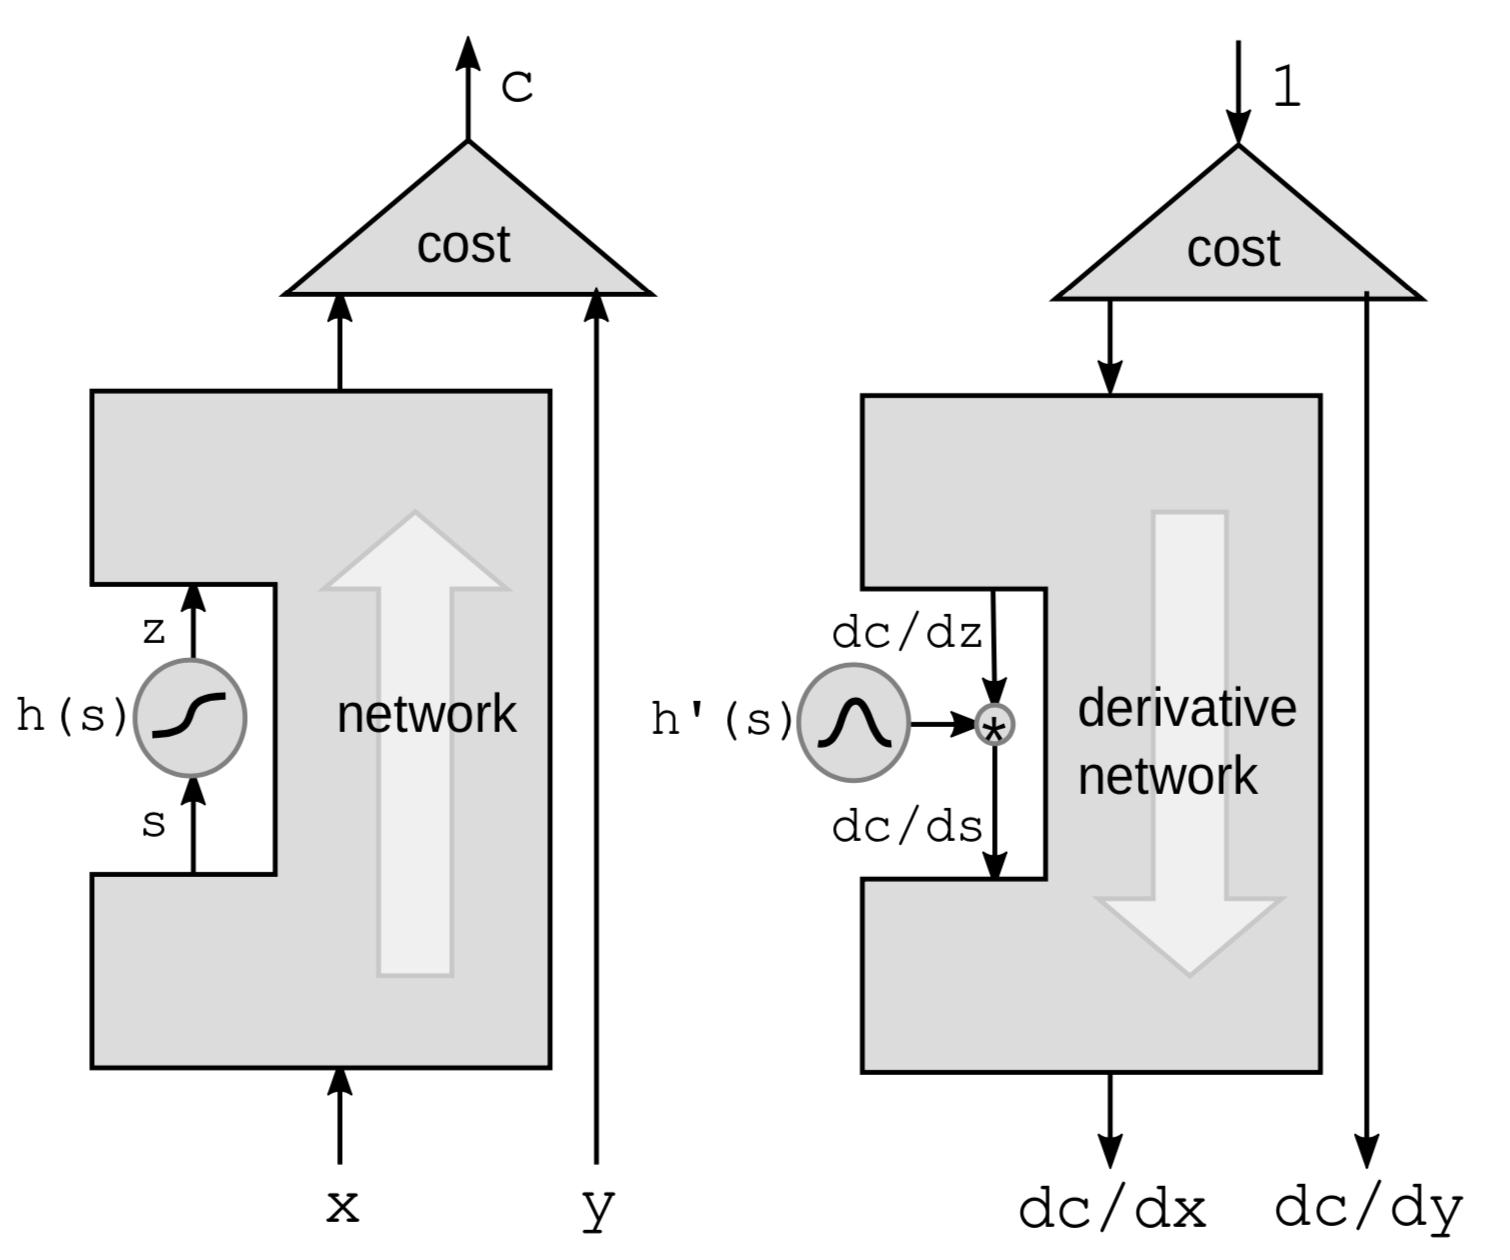 |
গ্রেডিয়েন্ট ক্যালকুলেট করার জন্য আমরা চেইন রুল ব্যবহার করবো:
\[g(h(s))' = g'(h(s))\cdot h'(s)\]যেখানে $h’(s)$ হচ্ছে $s$ এর সাপেক্ষে $z$ এর ডেরিভেটিভ যা প্রকাশ করা হয় এভাবে $\frac{\mathrm{d}z}{\mathrm{d}s}$। ডেরিভেটিভ এর ব্যাপারটি নিম্নলিখিত উপায়ে আরো পরিষ্কার ভাবে দেখতে পারি:
\[\frac{\mathrm{d}C}{\mathrm{d}s} = \frac{\mathrm{d}C}{\mathrm{d}z}\cdot \frac{\mathrm{d}z}{\mathrm{d}s} = \frac{\mathrm{d}C}{\mathrm{d}z}\cdot h'(s)\]অতএব আমাদের যদি এরকম ফাংশন এর চেইন থাকে নেটওয়ার্ক এ, তাহলে আমরা সবগুলো ডেরিভেটিভ ফাংশন ${h}$ এর গুণ এর মাধ্যমে ব্যাকপ্রোপাগেট করতে পারি একেবারে নিচে এসে পৌঁছানো পর্যন্ত।
এটা পার্টারবেশন এর মাধ্যমে আরো সহজভাবে বুঝা যায়। $s$ কে যদি $\mathrm{d}s$ পার্টার্ব করি তাহলে $z$ তে পার্টার্ব হবে এতটুকু:
\[\mathrm{d}z = \mathrm{d}s \cdot h'(s)\]এটি পর্যায়ক্রমে আবার $C$ কে পার্টার্ব করবে এতটুকু:
\[\mathrm{d}C = \mathrm{d}z\cdot\frac{\mathrm{d}C}{\mathrm{d}z} = \mathrm{d}s\cdot h’(s)\cdot\frac{\mathrm{d}C}{\mathrm{d}z}\]আবারও, আমরা উপরেউল্লেখিত ফর্মুলাই পেলাম।
ওয়েইটেড সাম এর মধ্য দিয়ে ব্যাকপ্রোপাগেসন
লিনিয়ার মডেল এ, আমরা ওয়েইটেড সাম এর মধ্য দিয়ে ব্যাকপ্রোপাগেসন করে থাকি। এখানে আমরা ${z}$ ভ্যারিয়েবল থেকে কিছু $s$ ভ্যারিয়েবল এ যাওয়া শুধু ৩ টি কানেকশন বাদে বাকি সবকিছুকে ব্ল্যাকবক্স হিসেবে ধরবো।
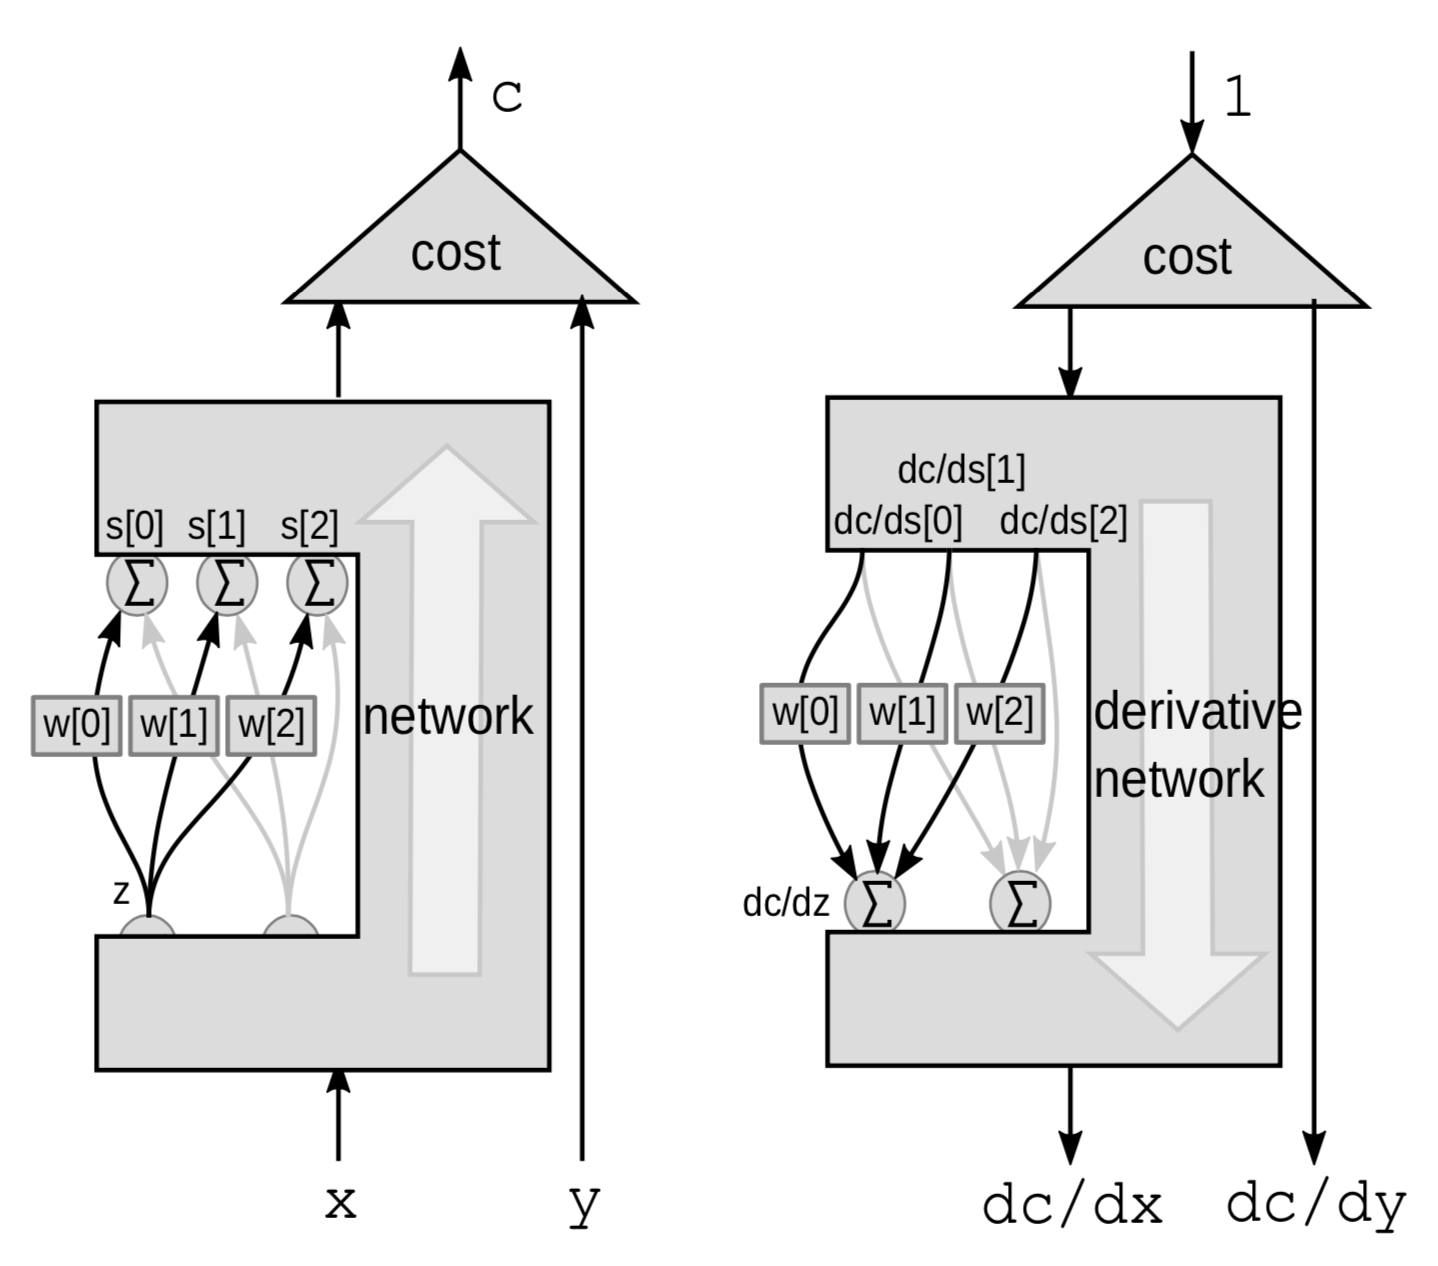 |
এক্ষেত্রে পার্টারবেশনটি হচ্ছে একটি ওয়েইটেড সাম। $Z$অনেকগুলো ভ্যারিয়েবল প্রভাবিত করে, $z$ তে $\mathrm{d}z$ পরিমান পার্টার্ব $s[0]$, $s[1]$ and $s[2]$ এ পার্টার্ব ঘটাবে এতটুকু:
\[\mathrm{d}s[0]=w[0]\cdot \mathrm{d}z\] \[\mathrm{d}s[1]=w[1]\cdot \mathrm{d}z\] \[\mathrm{d}s[2]=w[2]\cdot\mathrm{d}z\]এটি পর্যায়ক্রমে আবার $C$ কে পার্টার্ব করবে এতটুকু
\[\mathrm{d}C = \mathrm{d}s[0]\cdot \frac{\mathrm{d}C}{\mathrm{d}s[0]}+\mathrm{d}s[1]\cdot \frac{\mathrm{d}C}{\mathrm{d}s[1]}+\mathrm{d}s[2]\cdot\frac{\mathrm{d}C}{\mathrm{d}s[2]}\]তাই $C$ ৩ টি সাম এর ভ্যারিয়েশন পরিমান ভ্যারি করবে::
\[\frac{\mathrm{d}C}{\mathrm{d}z} = \frac{\mathrm{d}C}{\mathrm{d}s[0]}\cdot w[0]+\frac{\mathrm{d}C}{\mathrm{d}s[1]}\cdot w[1]+\frac{\mathrm{d}C}{\mathrm{d}s[2]}\cdot w[2]\]পাইটর্চ এর মাধ্যমে নিউরাল নেটওয়ার্ক এবং একটি জেনারালিজড ব্যাকপ্রোপ এলগোরিদম ইমপ্লিমেন্টেশন
প্রচলিত নিউরাল নেট এর ব্লক ডায়াগ্রাম
- লিনিয়ার ব্লক $s_{k+1}=w_kz_k$
-
নন-লিনিয়ার ব্লক $z_k=h(s_k)$
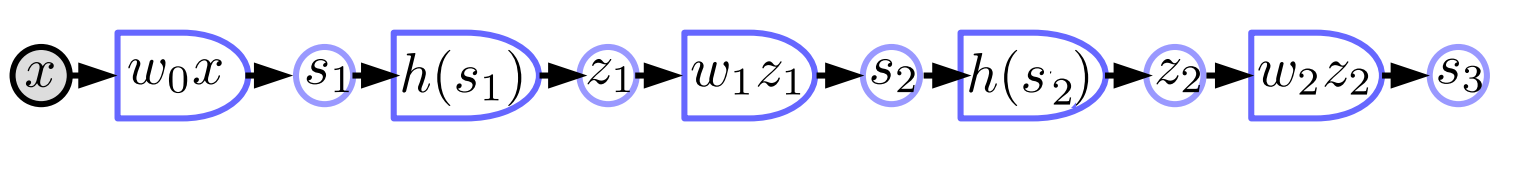
$w_k$: ম্যাট্রিক্স $z_k$: ভেক্টর $h$: প্রতিটি উপাদানে স্কেলার ${h}$ ফাংশন এর প্রয়োগ। এটি একটি ৩ লেয়ার নিউরাল নেটওয়ার্ক লিনিয়ার এবং নন-লিনিয়ার ফাংশন বিশিষ্ট, যদিও আধুনিক নিউরাল নেট গুলোতে এতো পরিষ্কার লিনিয়ার এবং নন-লিনিয়ার এর বর্ণনা থাকেনা, সেগুলো বরং আরো জটিল।
পাইটর্চ ইমপ্লিমেন্টেশন
import torch
from torch import nn
image = torch.randn(3, 10, 20)
d0 = image.nelement()

class mynet(nn.Module):
    def __init__(self, d0, d1, d2, d3):
        super().__init__()
        self.m0 = nn.Linear(d0, d1)
        self.m1 = nn.Linear(d1, d2)
        self.m2 = nn.Linear(d2, d3)

    def forward(self,x):
        z0 = x.view(-1)  # flatten input tensor
        s1 = self.m0(z0)
        z1 = torch.relu(s1)
        s2 = self.m1(z1)
        z2 = torch.relu(s2)
        s3 = self.m2(z2)
        return s3
model = mynet(d0, 60, 40, 10)
out = model(image)
- আমরা পাইটর্চ এর অবজেক্ট ওরিয়েন্টেড ক্লাসগুলো ব্যবহার করে নিউরাল নেটওয়ার্ক ইমপ্লিমেন্ট করতে পারি। প্রথমে আমরা নিউরাল নেট এর জন্য একটা ক্লাস তৈরী করবো এবং সেই ক্লাস এর কন্সট্রাক্টর এ প্রিডিফাইন
nn.Linearক্লাস ব্যবহার করে লিনিয়ার লেয়ারগুলো ইনিশিয়ালইজ করবো। লিনিয়ার লেয়ার গুলোকে আলাদা অবজেক্ট হতে হবে যেহেতু সেগুলোর প্রত্যেকটিতেই প্যারামিটার ভেক্টর রয়েছে।nn.Linearক্লাস একটি বায়াস ও যুক্ত করে দেয়। এরপর আমরা ফরওয়ার্ড ফাংশন তৈরী করি যেখানে আমাদের আউটপুট কেমন হবে তা বলে দেই এবং $\text{torch.relu}$ কে নন-লিনিয়ার এক্টিভেশন ফাংশন হিসেবে ঠিক করি। আমাদের আলাদা করে রেলু (ReLU) ফাংশন ইনিশিয়ালইজ করার দরকার নেই, কারণ এর কোনো প্যারামিটার নেই।
- আমাদের নিজেদের গ্রেডিয়েন্ট ক্যালকুলেট করার প্রয়োজন নেই, যেহেতু পাইটর্চ জানে
forwardফাংশন দেয়া থাকলে কিভাবে ব্যাকপ্রোপাগেট করে গ্রেডিয়েন্ট ক্যালকুলেট করতে হয়।
একটি ফাংশনাল মডিউল এর মধ্য দিয়ে ব্যাকপ্রপ
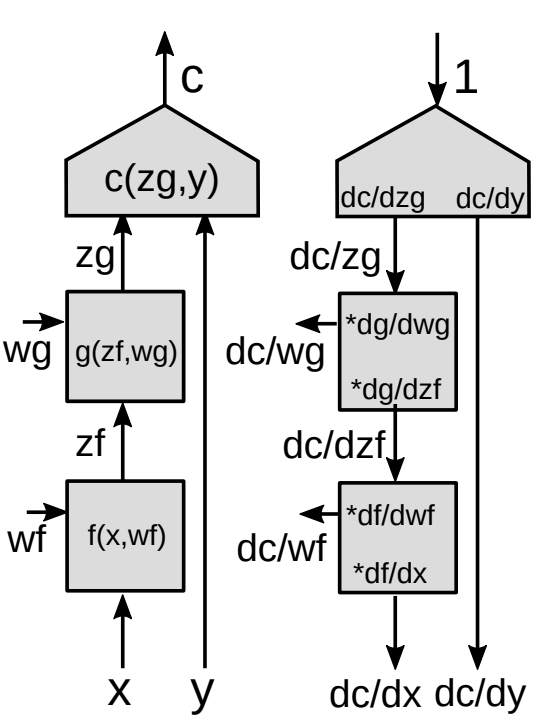
এখানে ব্যাকপ্রোপাগেসন এর আরো জেনেরালাইজড রূপ তুলে ধরা হলো।
 |
-
ভেক্টর ফাংশন এর জন্য চেইন রুল ব্যবহার করে
\[z_g : [d_g\times 1]\] \[z_f:[d_f\times 1]\] \[\frac{\partial c}{\partial{z_f}}=\frac{\partial c}{\partial{z_g}}\frac{\partial {z_g}}{\partial{z_f}}\] \[[1\times d_f]= [1\times d_g]\times[d_g\times d_f]\]এটি $\frac{\partial c}{\partial{z_f}}$ এর চেইন রুল ব্যবহার করে বেসিক ফর্মুলা। লক্ষ্য কর, একটি ভেক্টর এর সাপেক্ষে একটি স্কেলার ফাংশন এর গ্রেডিয়েন্ট হচ্ছে একটি ভেক্টর যার আকার যেই ভেক্টর এর সাপেক্ষে ডিফারেন্সিয়েট করা হয়েছে। নোটেশনগুলোকে সামঞ্জস্যপূর্ণ করার জন্য, এটি কলাম ভেক্টর এর বদলে একটি রো ভেক্টর।
-
জ্যাকোবিয়ান ম্যাট্রিক্স
\[\left(\frac{\partial{z_g}}{\partial {z_f}}\right)_{ij}=\frac{(\partial {z_g})_i}{(\partial {z_f})_j}\]আমাদের $\frac{\partial {z_g}}{\partial {z_f}}$ (জ্যাকোবিয়ান ম্যাট্রিক্স উপাদানসমূহ) প্রয়োজন $z_f$ এর সাপেক্ষে কস্ট ফাংশন এর গ্রেডিয়েন্ট ক্যালকুলেট করার জন্য যদি ধরে নেই $z_g$ এর সাপেক্ষে কস্ট ফাংশন এর গ্রেডিয়েন্ট দেয়া আছে প্রতিটি $ij$ উপাদান, ইনপুট ভেক্টর এর $j$ তম উপাদান এর সাপেক্ষে আউটপুট ভেক্টর এর $i$th তম উপাদান এর পার্শিয়াল ডেরিভেটিভ এর সমান।
যদি আমাদের কাছে মডিউলগুলির একটি ক্যাসকেড থাকে, আমরা নীচে নেমে যাওয়া সমস্ত মডিউলগুলির জ্যাকোবিয়ান ম্যাট্রিক্সগুলি গুণ করতে থাকি এবং আমরা অভ্যন্তরীণ সবগুলো ভ্যারিয়েবল এর সাপেক্ষে গ্রেডিয়েন্ট পেয়ে যাই।
মাল্টি-স্টেজ গ্রাফের এর মধ্য দিয়ে ব্যাকপ্রপ
একটি নিউরাল নেটওয়ার্ক এর মধ্যে অনেকগুলো মডিউল এর সারি চিন্তা করো চিত্র ৯ এর মতো।
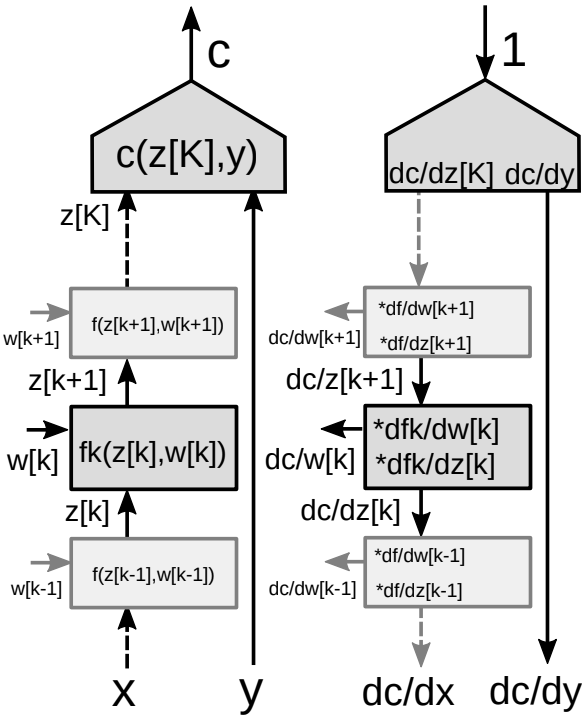 |
ব্যাকপ্রপ এলগোরিদমটির জন্য আমাদের গ্রেডিয়েন্ট এর ২ টি সেট প্রয়োজন - একটি স্টেটগুলোর সাপেক্ষে (নেটওয়ার্ক এর প্রতিটি মডিউল) এবং আরেকটি হচ্ছে ওয়েইটগুলোর সাপেক্ষে (কোনো একটি নির্দিষ্ট মডিউল এর সকল প্যারামিটার)। তাই প্রতিটি মডিউল দুটি করে জাকোবিয়ান ম্যাট্রিক্স যুক্ত। আমরা আবারো ব্যাকপ্রপ এর জন্য চেইন রুল ব্যবহার করতে পারি।
-
ভেক্টর ফাংশন এর জন্য চেইন রুল ব্যবহার করে
\[\frac{\partial c}{\partial {z_k}}=\frac{\partial c}{\partial {z_{k+1}}}\frac{\partial {z_{k+1}}}{\partial {z_k}}=\frac{\partial c}{\partial {z_{k+1}}}\frac{\partial f_k(z_k,w_k)}{\partial {z_k}}\] \[\frac{\partial c}{\partial {w_k}}=\frac{\partial c}{\partial {z_{k+1}}}\frac{\partial {z_{k+1}}}{\partial {w_k}}=\frac{\partial c}{\partial {z_{k+1}}}\frac{\partial f_k(z_k,w_k)}{\partial {w_k}}\] -
মডিউলটির জন্য ২ টি জ্যাকোবিয়ান ম্যাট্রিক্স
- একটি $z[k]$ এর সাপেক্ষে
- একটি $w[k]$ এর সাপেক্ষে
📝 Amartya Prasad, Dongning Fang, Yuxin Tang, Sahana Upadhya
Khalid Saifullah
3 Feb 2020